2026년 11월 14일 토요일

헤르메스 로컬 바이브 코딩 설치 최적화 방법 - 최신 오픈 모델 기반 클로드 코드와 실측 비교

이 글은 오픈소스 에이전트인 헤르메스(Hermes Agent)와 오픈 웨이트 모델(Qwen3.8 27B)을 GPU있는 컴퓨터에 설치하고, 클로드 코드(Claude Code)나 코덱스(Codex) 같은 상용 바이브 코딩 도구와 비교해 정확도 차이가 거의 없도록 최적화한 방법을 기록해 남긴다. 코드와 대화가 외부 클라우드로 나가지 않는 온프레미스(on-premise) 환경이 목표다. 보안 때문에 상용 AI 코딩 도구를 쓰기 어려운 조직에서 쓸 만하다.

헤르메스 텔레그램 연결 바이브 코딩 화면

우선, 비교 기준은 직접 만든 코딩 과제 9개(숨은 테스트 119개)다. 단일 파일 모듈 작성부터 7개 모듈로 된 기존 패키지 수정까지 포함했다. 같은 과제를 클로드 코드와 헤르메스에 똑같이 주고 결과를 채점했다. 최종 설정에서 헤르메스는 9개 모두 통과했고(클로드 코드도 9개 모두 통과), 시간은 48분(클로드 코드 13분)이 걸렸다. 정확도는 같고 속도는 3~4배 느린 수준이다.

헤르메스는 Nous Research에서 만든 오픈소스 에이전트로, 터미널에서 클로드 코드처럼 쓸 수도 있고 텔레그램 같은 메신저와 연결해 휴대폰에서 개발을 시킬 수도 있다. 다만 기본 설정 그대로 로컬 모델을 붙이면 9개 과제 중 1개만 통과할 정도로 성능이 낮다. 모델, 추론 엔진, 에이전트 하네스(도구 구성, 작업 절차, 검증 훅)를 단계별로 바꿔 가며 최적화한 결과를 정리한다.

설치 과정 전체는 깃허브에 하나의 마크다운 파일로 올려 두었다. 이 파일을 클로드 코드나 코덱스에 읽혀 자동 설치하는 방법부터 설명하고, 그 다음 각 단계가 무엇을 왜 하는지 설명한다.

헤르메스 바이브 코딩 환경 구성

최종 구성은 다음과 같다.

  • 모델: Qwen3.8 27B NVFP4 (21.9GB) + DSpark 보조 모델 (4.0GB, 추측 디코딩용)
  • 추론 엔진: vLLM 0.27.1 (포트 8000, 컨텍스트 65,536 토큰)
  • 예비 엔진: Ollama qwen3.8 q4 (vLLM이 꺼지면 헤르메스가 자동 전환)
  • 에이전트: Hermes Agent v0.21 이상, 코딩용 coder 프로필과 텔레그램 봇용 기본 프로필
  • 입력: 텍스트, 사진(모델이 직접 인식), 음성(faster-whisper 로컬 음성 인식)
  • 출력: 실시간 스트리밍 텍스트, 선택적으로 음성(MeloTTS 로컬 음성 합성)

모델, 음성 인식, 음성 합성이 모두 장비 안에서 돈다. 인터넷은 설치할 때 모델을 받는 것과 텔레그램 메시지 전달에만 쓴다.

준비사항

장비 스펙은 다음과 같다. 핵심은 GPU 메모리다.

  • GPU: NVIDIA, 메모리 96GB 이상 권장 (RTX PRO 6000 Blackwell 96GB에서 검증). DGX Spark 같은 128GB 통합메모리 장비, 64GB급 장비도 설정을 낮춰 쓸 수 있다(아래 메모리 등급 참고)
  • 드라이버: CUDA 13 지원 (검증 장비 595.99, CUDA 13.2)
  • OS: Ubuntu 24.04 (x86_64). DGX Spark(arm64)는 vLLM 설치 방법만 다르다
  • 디스크: 여유 60GB 이상 (모델 26GB, 예비 모델 17GB, 음성 모델 등)
  • RAM: 64GB 이상 권장
  • 기타: 인터넷(설치 시), 텔레그램 봇을 쓸 경우 텔레그램 계정

GPU 메모리에 따라 추측 디코딩용 보조 모델을 쓸 수 있는지가 갈린다. 64K 토큰 입력을 넣고 실측한 값은 다음과 같다.

등급장비보조 모델KV 캐시최대 메모리코드 생성 속도
gpu96전용 GPU 90GB 이상DSpark12GiB약 77GB약 246 tok/s
unified128128GB 통합메모리 (DGX Spark)DSpark8GiB약 76GB메모리 대역폭에 비례해 낮음
mem6448~110GB (80GB GPU 포함)없음5GiB약 30GB약 58 tok/s
small48GB 미만vLLM 없이 Ollama만 사용 (약 22GB, 약 75 tok/s)

보조 모델을 켜면 메모리를 많이 쓰는 이유가 있다. vLLM 0.27.1은 추측 디코딩을 켠 상태에서 긴 입력을 나눠 처리(chunked prefill)하면 CUDA illegal memory access로 죽는다. 그래서 64K 입력을 한 번에 처리해야 하고, 이때 계산용 메모리가 약 16GiB 더 든다. 반면 KV 캐시는 생각보다 작다. Qwen3.8은 64개 층 중 16개만 전체 어텐션을 쓰는 하이브리드 구조라 5GiB에 약 14만 토큰이 들어간다. 통합메모리 장비는 운영체제, 헤르메스, 음성 모델과 메모리를 나눠 쓰므로 KV 캐시와 동시 요청 수를 줄였다. 참고로 unified128과 mem64 값은 검증 장비에서 같은 설정으로 측정해 정한 것이다.

깃허브 설정 파일로 한 번에 설치하기

가장 쉬운 방법은 깃허브의 HERMES_SETUP.md 파일을 클로드 코드나 코덱스에 읽혀 설치를 맡기는 것이다. 이 파일 하나에 설치 순서, 단계별 확인 명령과 기대값, 필요한 스크립트 18개가 모두 들어 있다. 장비 메모리를 감지해 위 등급에 맞는 설정도 자동으로 고른다.

1) 새 장비에서 저장소를 받는다.

git clone https://github.com/mac999/hermes_vibe_dev.git
cd hermes_vibe_dev

2) 그 폴더에서 클로드 코드나 코덱스를 다음 프롬프트로 실행한다.

claude "Read HERMES_SETUP.md and set up this machine by following it section by section. Follow section 0 exactly: ask me before sudo, GPU choice or deleting anything, and never ask me for the Telegram token in chat."
codex "Read HERMES_SETUP.md and set up this machine by following it section by section. Follow section 0 exactly: ask me before sudo, GPU choice or deleting anything, and never ask me for the Telegram token in chat."

3) 에이전트가 먼저 몇 가지를 묻는다. 모델 서버에 쓸 GPU 번호, 텔레그램 봇이 작업할 폴더, 텔레그램과 음성 기능 사용 여부다. 이후 스크립트 생성, 메모리 등급 판별, vLLM 설치, 모델 다운로드(약 26GB, sha256 확인), Ollama, 헤르메스, 프로필 설정까지 순서대로 진행하고 마지막에 검증표를 채워 보고한다. sudo 명령, GPU 선택, 파일 삭제 전에는 반드시 사람에게 확인을 받도록 파일 첫 장에 규칙을 넣어 두었다.

4) 텔레그램 봇 토큰만 사람이 직접 넣는다. 토큰이 AI 대화 기록에 남지 않게 하기 위해서다. 텔레그램 @BotFather에서 봇을 만들어 토큰을 받고, @userinfobot에서 내 숫자 ID를 확인한 뒤 다음을 실행한다. 토큰을 숨긴 채 입력받아 텔레그램에 실제로 확인한 뒤 저장한다.

bash ~/hermes-coder-kit/telegram/setup-telegram.sh

파일의 각 단계는 사람이 직접 따라 해도 된다. 아래는 그 단계들이 무엇을 왜 하는지에 대한 설명이다.

단계별 설치 및 최적화 방법

1) 모델 선정. 같은 하네스로 로컬 모델 5종을 비교했다. 9개 과제의 숨은 테스트 통과율 기준이다.

  • Qwen3.8 27B: 100% (3회 반복 모두 9개 통과)
  • Laguna XS 2.1 33B-A3B: 98%
  • Qwen3.5 122B-A10B: 96%
  • Qwen3 Coder Next 80B-A3B: 94%
  • Qwen3.6 35B-A3B: 91%

파라미터를 일부만 쓰는 MoE 모델이 빠르지만 요구사항을 놓치는 경우가 많았다. 생각(thinking) 모드가 있는 모델이 중요했다. 생각 모드가 없는 qwen3-coder는 파일을 읽지 않고 내용을 지어낸 사례가 있었다.

2) 추론 엔진을 vLLM으로 바꾼다. 처음에는 Ollama를 썼는데, 시간의 93~98%가 모델 응답 대기였다. 헤르메스는 도구를 호출할 때마다 대화 전체를 다시 보내기 때문에 입력 처리(prefill) 속도가 체감 속도를 좌우한다.

  • Ollama q4 + MTP: 입력 554 tok/s, 생성 75 tok/s, 9개 과제 89.5분
  • vLLM NVFP4 + MTP: 입력 7,695 tok/s, 코드 생성 152 tok/s, 58.5분
  • vLLM NVFP4 + DSpark 보조 모델: 입력 7,304 tok/s, 코드 생성 246 tok/s, 48.0분

NVFP4는 블랙웰 GPU가 하드웨어로 계산하는 4비트 형식이라 정확도 손실 없이 입력 처리가 14배 빨라졌다. DSpark는 본 모델 대신 다음 토큰들을 미리 써 보는 5층짜리 작은 모델이다. 본 모델이 검사해 맞는 것만 받아들이므로 결과는 같고 속도만 오른다. 코드처럼 형태가 정해진 출력에서 효과가 크다.

3) 헤르메스 coder 프로필을 튜닝한다. 정확도를 1/9에서 9/9로 올린 것은 대부분 이 단계다.

  • 도구를 terminal, file, todo 3개만 남긴다. 기본으로 켜진 웹, 브라우저, 이미지, 음성 등 도구 정의가 매 요청 약 14K 토큰을 차지했다
  • 메모리를 끈다. 이전 세션 메모가 다음 작업을 엉뚱한 폴더로 끌고 가는 사례가 있었다
  • 작업 절차(SOUL.md)를 7단계로 바꾼다. 탐색, 계획, 테스트 먼저, 최소 구현, 검증, 요구사항 재확인, 짧은 보고 순이다. "도구로 읽지 않은 파일 내용은 말하지 말 것", "직접 실행해 본 결과만 보고할 것"이 핵심이다
  • 테스트 확인 훅을 건다. 코드를 고친 턴이 끝나기 전에 pytest, node --test를 자동 실행하고, 실패하면 계속 일하게 한다
  • 패키지 설치 승인 훅을 건다. 금지했는데도 패키지를 설치하려 한 모델이 있었다
  • 작업 폴더를 실행한 위치로 둔다. 클로드 코드처럼 프로젝트 폴더에서 hermes -p coder chat으로 실행한다
  • 생각 강도를 xhigh로 고정한다. Qwen3.8 템플릿은 low, medium, xhigh만 받고 헤르메스 기본값 high를 HTTP 400으로 거부한다

4) 예비 서버를 둔다. vLLM이 꺼져 있으면 헤르메스가 경고 한 줄을 띄우고 Ollama qwen3.8로 넘어가 답한다. 재부팅 뒤 vLLM을 아직 안 띄웠어도 봇은 동작한다.

5) 텔레그램 봇을 연결한다. 기본 프로필에 coder와 같은 설정을 입히고, 텔레그램에는 현재 폴더 개념이 없으므로 작업 폴더만 고정한다. 이렇게 하면 휴대폰에서 "계산기 앱 만들어줘"라고 보내면 장비에서 개발, 테스트, 서버 실행까지 진행하고 결과를 알려준다.

6) 사진, 음성, 실시간 출력을 켠다.

  • 사진: Qwen3.8은 이미지를 직접 이해하지만, 헤르메스는 로컬 서버 모델의 비전 지원을 모른다. supports_vision과 image_input_mode native를 설정해야 모델이 원본 이미지를 본다. 화면 캡처를 보내며 "겹치는 UI 고쳐줘"라고 할 수 있다
  • 음성 인식: faster-whisper large-v3-turbo를 별도 환경에 설치해 연결했다. 10초 한국어 음성이 약 8초에 정확히 변환됐다
  • 음성 답장: 헤르메스 기본 TTS는 답변 글을 외부 서버로 보낸다. 그래서 로컬 MeloTTS 한국어 모델을 CPU로 돌렸다. /voice on으로 켠다
  • 실시간 출력: 헤르메스는 기본값으로 답을 다 만든 뒤에 한 번에 보낸다. streaming.enabled를 켜면 텔레그램에 글이 써지는 모습이 그대로 보인다

성능 비교 결과

구성완전 해결숨은 테스트 통과율시간
클로드 코드 (클라우드)9/9100%13분
헤르메스 기본 설정 + qwen3-coder 30B1/956%-
헤르메스 튜닝 + Qwen3.8 27B (Ollama)9/9100%89.5분
헤르메스 튜닝 + Qwen3.8 27B NVFP4 (vLLM + DSpark)9/9100%48.0분

정리하면, 요구사항이 명확한 중소 규모 개발에서는 클로드 코드와 결과물 정확도가 같았다. 차이는 세 가지다. 속도가 3~4배 느리다. 도구 호출이 약 5배 많다(9개 과제 약 320회 대 63회). 화면 결과물을 스스로 확인하는 능력이 약하다. 공개 벤치마크로 보면 Qwen3.8 27B는 클로드 Opus 4.6급에 근접한다는 업체 발표가 있다. 체감으로는 1년쯤 전 상용 도구 수준이다. 수천 줄 이상의 대형 코드베이스, 몇 시간짜리 장기 작업, 모호한 요구사항은 측정하지 않았으므로 그런 작업에서는 차이가 더 날 수 있다.

그럼에도 이 방식을 쓰는 이유

속도는 상용 도구보다 느리다. 그래도 이 방식을 쓸 이유는 충분하다.

  • 코드가 밖으로 나가지 않는다. 소스 코드, 로그, 고객 데이터, 화면 캡처, 음성까지 모두 내 GPU 안에서 처리된다. 국방, 금융, 의료, 공공, 기밀 유지 계약이 걸린 프로젝트에서는 AI 코딩 도구를 쓸 수 있느냐 없느냐를 가르는 차이다
  • 인터넷이 끊긴 망에서도 쓴다. 처음 모델을 받은 뒤에는 텔레그램 메시지 전달을 빼면 모두 오프라인으로 돈다. 모델 파일과 저장소를 반입해 폐쇄망에 설치할 수 있다
  • 사용량 제한과 과금이 없다. 토큰당 요금, 호출 제한, 주간 한도가 없다. 밤새 긴 작업을 돌리거나 실험을 마음껏 반복하거나 팀이 GPU 서버 하나를 같이 써도 된다. 비용은 이미 가진 장비와 전기료뿐이다
  • 측정한 과제에서는 결과가 같았다. 클로드 코드가 푼 과제를 모두 풀었다. 차이는 정확도가 아니라 속도이고, 속도는 장비와 보조 모델이 좋아지면 따라 오른다
  • 내가 통제한다. 모델 버전이 고정되어 있어 어느 날 갑자기 동작이 바뀌지 않는다. 프롬프트, 도구, 훅, 정책이 모두 파일이라 감사하고 고칠 수 있다. 업체 장애, 정책 변경, 가격 인상에 작업이 멈추지 않는다
  • 더 좋은 모델로 바로 갈아탈 수 있다. 오픈 웨이트 모델은 최첨단을 대략 6개월에서 1년 간격으로 따라왔고 그 간격은 줄고 있다. 모델만 바꾸고 벤치마크를 다시 돌리면 된다
  • 어디서든 개발을 시킨다. 텔레그램으로 휴대폰에서 글, 사진, 음성으로 일을 맡기고 자리를 비운 사이에 결과를 받는다

결국 보안, 비용, 통제가 속도보다 중요한 곳에서 쓸 도구다. 가장 어렵고 크고 모호한 작업은 여전히 상용 클라우드 에이전트가 빠르다. 그래서 둘을 상황에 따라 나눠 쓰는 것이 현실적이다.

텔레그램으로 바이브 코딩한 결과

다음 두 앱은 휴대폰 텔레그램으로만 요청해 헤르메스가 로컬 모델로 개발한 것이다. 첫 번째는 공학용 계산기이며, 사용한 프롬프트는 다음과 같다.

좋아. 그럼 웹뷰 기반 공학용 계산기 개발해. 다크모드 지원. 영어 ux기반. 함수 그래프 출력 지원.

헤르메스는 할 일 목록으로 계획을 세웠다. 이어 계산 엔진 테스트(pytest 5개, node 11개)를 먼저 쓰고 Flask 앱을 만들어 검증했다. 모델 호출 29번, 약 10분이 걸렸다. 다만 첫 버전은 테스트를 모두 통과했는데도 키패드에 + 버튼이 없었다. 테스트가 계산 엔진만 보고 화면 구성은 보지 않았기 때문이다. 후속 요청 한 번으로 고쳤다.

더하기 버튼 추가후 개선. 재실행
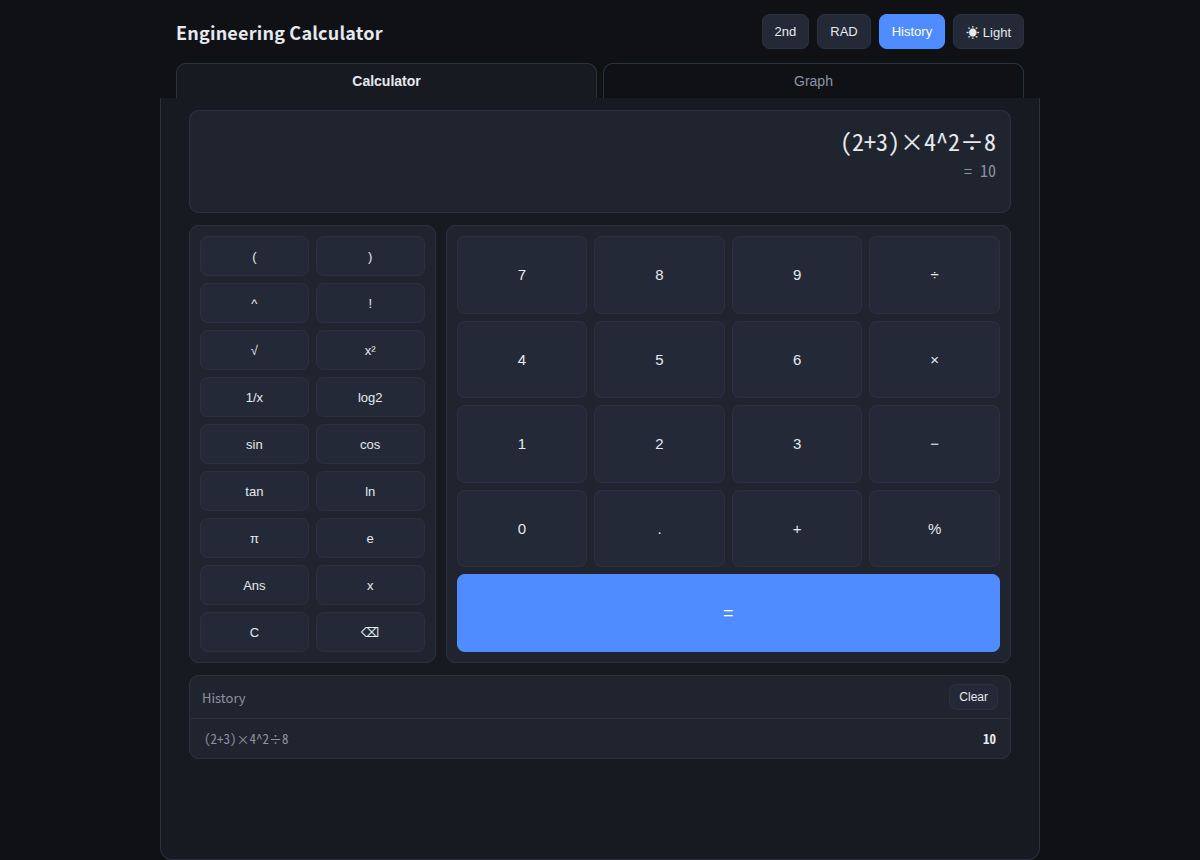
공학용 계산기 (다크 모드, 2nd, RAD/DEG, Ans, 히스토리)
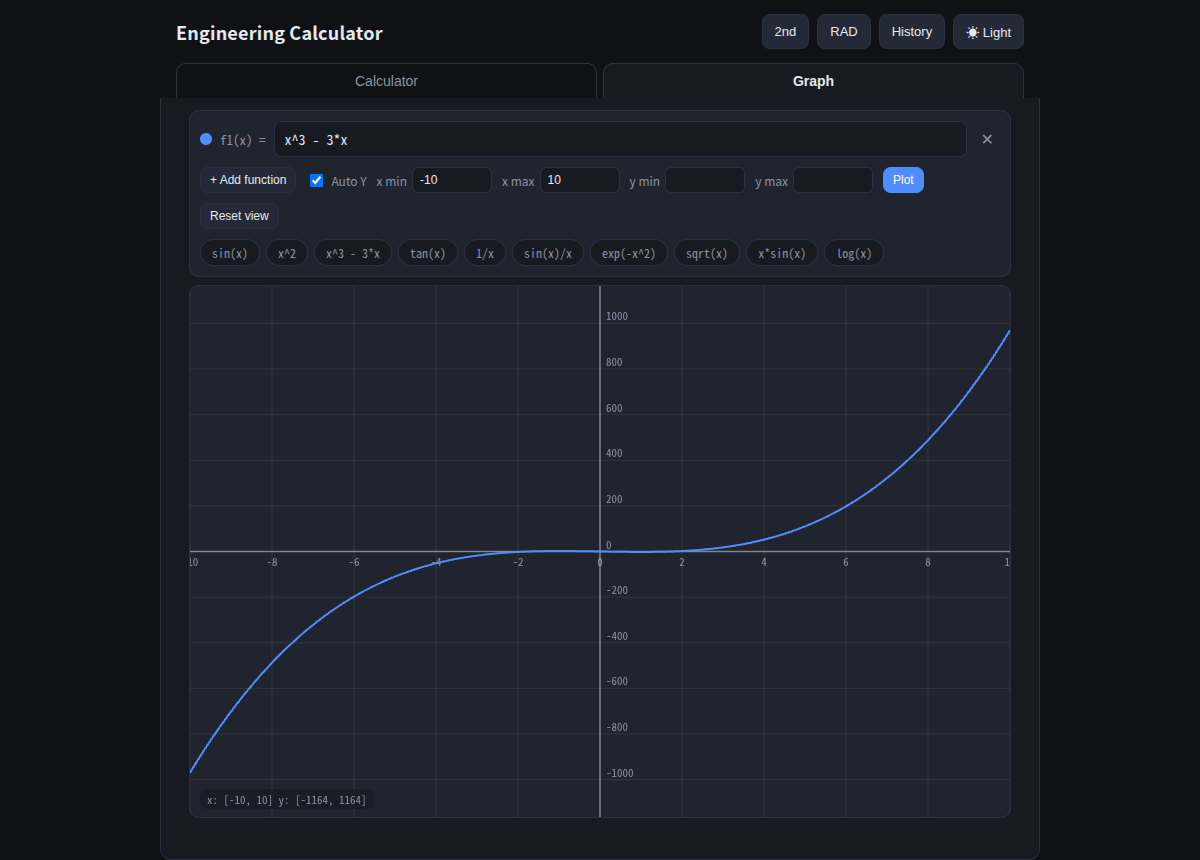
함수 그래프 탭 (x^3 - 3x, 프리셋 함수, 자동 Y축)

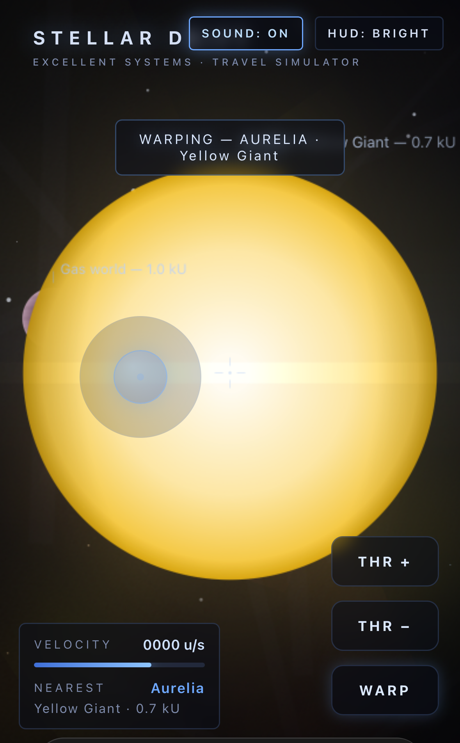
두 번째는 항성계 여행 시뮬레이터(Stellar Drift)다. 프롬프트는 두 번 보냈다.

이제 우수 항성계를 여행하는 시뮬레이터 개발. 파이썬 플라스크 기반 웹뷰 앱. 다크모드. 영문. 성운. 거대 항성. 아름다운 성운과 화려한 이팩트. 잔잔한 우주선 음향. 테스트 후 링크줘.
3d 일인칭 시점 뷰. 아이폰에서도 실행 가능하게 적절히 뷰 처리.

헤르메스는 작업을 다음과 같이 나눴다.

  • 순수 로직(spacecore.js, 노드 테스트 포함)
  • 캔버스 렌더러(별, 성운, 거대 항성, 행성, 파티클)
  • Web Audio로 만든 우주선 배경음
  • 아이폰용 가상 조이스틱과 WARP 버튼

그 다음 헤드리스 크롬에서 데스크톱과 아이폰 화면을 각각 확인했다.
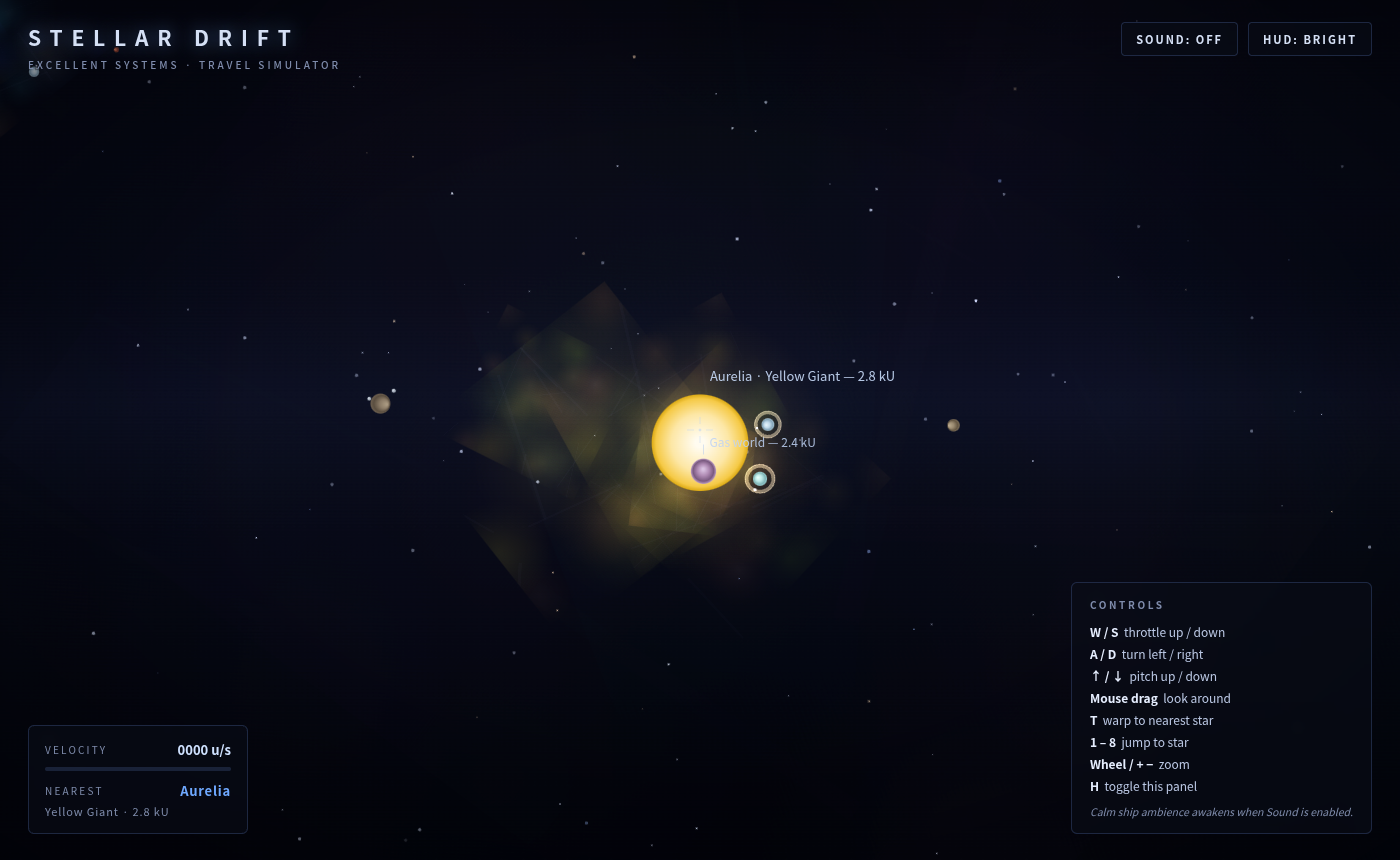
Stellar Drift 데스크톱 화면 (성운과 황색 거성 Aurelia)
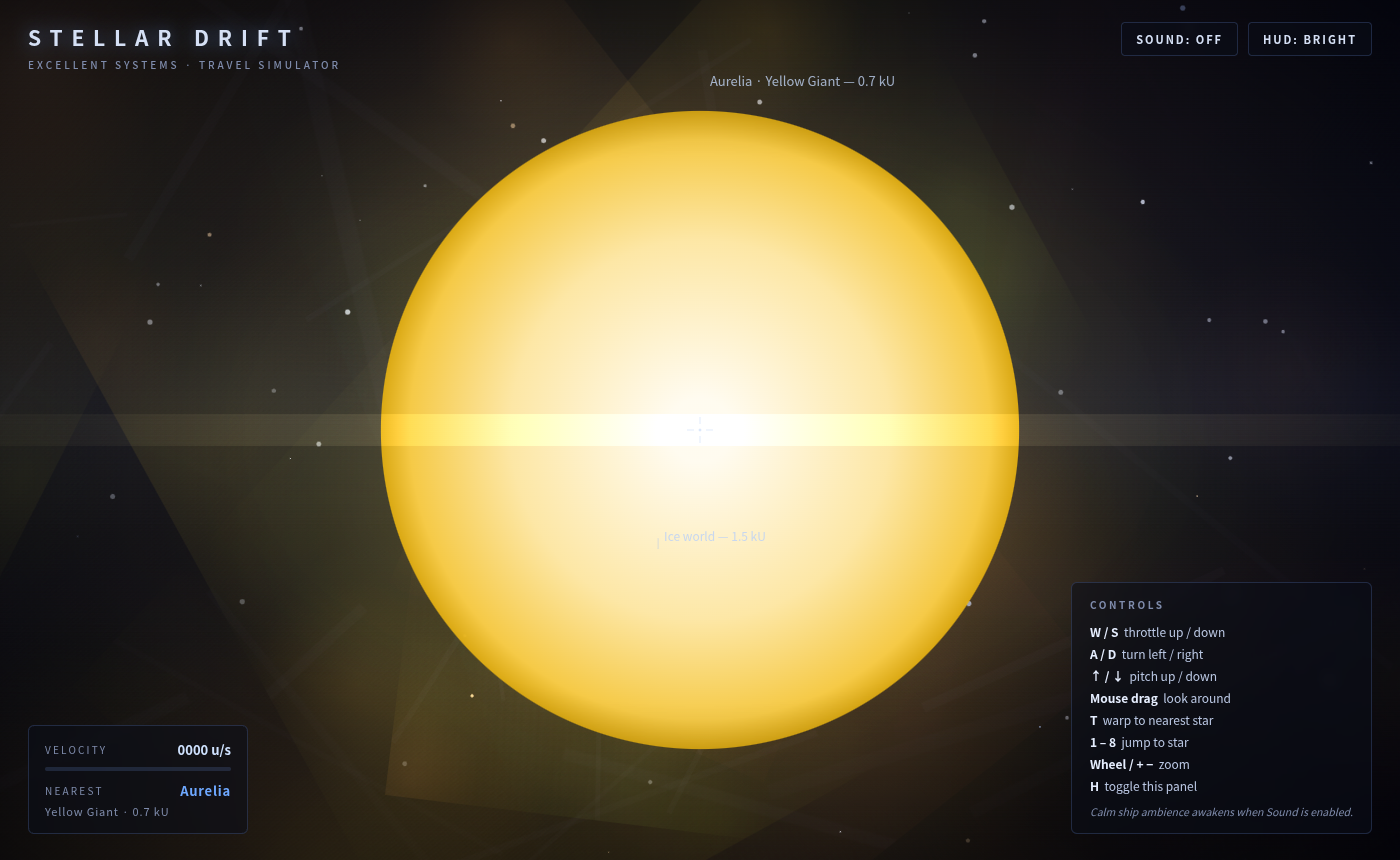
워프 후 거성에 도착한 화면
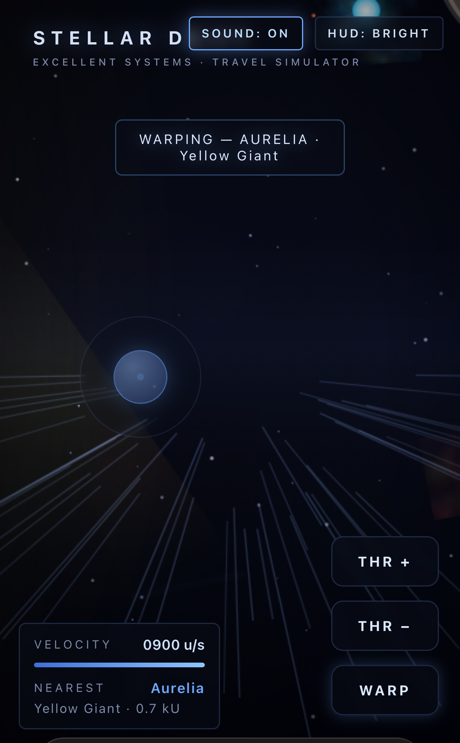
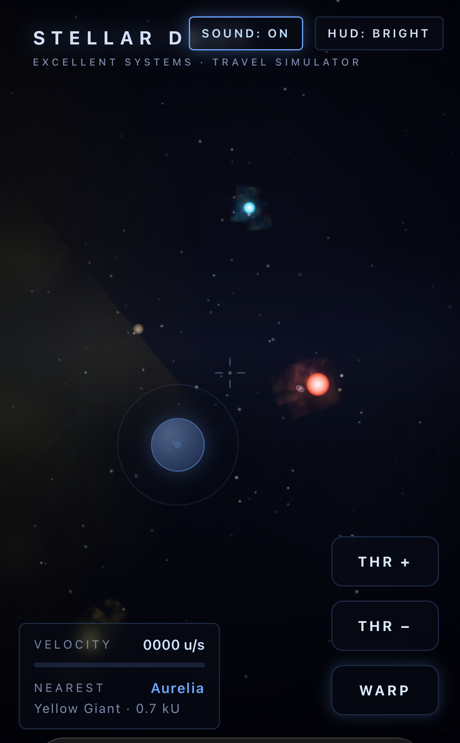
아이폰 실행 화면 (워프 중, 순항, 도착)

보다시피 꽤 그럴듯하게 동작한다. 다만 아이폰 화면에서 제목이 SOUND 버튼에 가려지고, 도착 후에도 WARPING 배너가 남는 문제가 보인다. 로컬 모델의 약점이 그대로 드러나는 부분이다. 이 화면을 캡처해 텔레그램으로 보내며 고쳐 달라고 하면 모델이 이미지를 직접 보고 문제를 찾는다. 시험해 보니 세 가지 문제를 정확히 짚었다.

개발 중 만난 문제들

  • vLLM이 CUDA illegal memory access로 죽음: 추측 디코딩과 입력 분할 처리가 충돌. max-num-batched-tokens를 컨텍스트 길이와 같게 해 해결
  • HTTP 400 Unexpected reasoning effort high: Qwen3.8 템플릿이 high를 거부. 모델별 생각 강도를 xhigh로 지정해 해결
  • Ollama가 헤르메스의 컨텍스트 설정을 무시하고 26만 토큰으로 올라감: 컨텍스트를 고정한 파생 모델을 만들어 해결
  • 허깅페이스 다운로드가 초당 2MB: aria2c 16개 연결로 받아 초당 45~50MB로 해결
  • 텔레그램 사진을 모델이 직접 못 봄: 별도 사진 설명용 모델 설정이 우선 적용되고 있었음. image_input_mode를 native로 고정해 해결
  • 음성 인식 오류(metadata_errors): PyAV 19와 faster-whisper 충돌. av를 16으로 고정해 해결
  • MeloTTS 설치 오류: setuptools 70 미만 고정, unidic 사전 다운로드로 해결
  • 텔레그램 답이 한 번에 옴: 헤르메스 스트리밍 기본값이 꺼져 있었음. streaming.enabled로 해결
  • pkill -f로 프로세스를 끄다가 자기 셸까지 종료: 패턴이 셸 명령줄과 겹침. PID로 종료하도록 변경

마무리

이 글에서는 헤르메스와 오픈 웨이트 모델로 클로드 코드급 정확도의 로컬 바이브 코딩 환경을 만드는 방법을 정리했다. 성능을 좌우한 것은 모델 크기보다 세 가지였다. 생각 모드가 있는 모델 선택, 입력 처리가 빠른 추론 엔진, 그리고 도구를 줄이고 테스트로 검증하게 만든 하네스다. 깃허브의 HERMES_SETUP.md를 쓰면 새 장비에서도 클로드 코드나 코덱스에 맡겨 같은 환경을 재현할 수 있다.

다만 속도는 여전히 상용 도구보다 3~4배 느리고, 화면 결과물처럼 테스트로 잡기 어려운 부분은 사람이 확인해야 한다. 요구사항을 명확히 쓰고 핵심 합격 기준을 정하는 일, 결과를 검수하는 일은 여전히 사람이 챙겨야 할 몫이다. 그래도 코드가 밖으로 나가지 않는다는 점에서, 보안이 중요한 조직이라면 지금 수준으로도 충분히 쓸 만하다.

부록: 공개된 유사 구성과 비교

글을 정리한 뒤 Qwen 27B급 모델을 단일 GPU에서 돌려 헤르메스나 코딩 에이전트에 붙인 공개 사례를 찾아 비교했다. 수치는 각 글의 측정값이라 측정 조건이 서로 다르다. 대략의 위치를 보는 용도로만 참고하길 바란다.

구성생성 속도입력 처리컨텍스트장점단점
이 글: vLLM + NVFP4 + DSpark (RTX PRO 6000)코드 246 tok/s약 7,300 tok/s64K원본 모델 사용. 클로드 코드와 같은 과제로 정확도 검증. 설치 파일 하나로 재현추측 디코딩 사용 시 입력을 나눠 처리하지 못해 메모리 16GiB 추가, 컨텍스트 64K로 제한
SGLang + DFlash 2 (RTX PRO 6000)에이전트 30K 기준 220 tok/s, 코드 320 tok/s11,000~12,000 tok/s262K, 동시 8개입력 처리가 약 1.6배 빠름. 추측 디코딩을 켠 채 8K씩 나눠 처리. 긴 컨텍스트검열 해제 모델과 자체 양자화 사용. SGLang 패치 6개 필요. 구조화 출력 요청은 400 오류
vLLM + MTP (RTX PRO 6000)114 tok/s미공개262K모델 내장 MTP만 써서 설정이 간단생성 속도가 절반 수준
vLLM + MTP 2 (DGX Spark / RTX 6000)미공개미공개1M (YaRN)초장문 컨텍스트, KV 용량 실측속도 측정 없음. 짧은 입력에서 품질이 약간 떨어질 수 있음
vLLM + GPTQ 4bit + 헤르메스 (24GB RTX 3090)30~45 tok/s미공개131K24GB 보급형 GPU로 가능. 운영 노하우(요청 1개씩, 긴 타임아웃)가 실용적MTP를 켜면 메모리 부족과 오류로 끄고 사용. 느림

정리하면 다음과 같다.

  • 생성 속도와 정확도 검증 면에서는 이 글의 구성이 공개 사례 중 앞선 편이다. 다른 글들은 대부분 속도나 연결 방법만 다루고, 상용 도구와 같은 과제로 정확도를 비교한 사례는 찾지 못했다.
  • 입력 처리 속도와 컨텍스트 길이는 SGLang + DFlash 2 구성이 낫다. 헤르메스는 도구 호출마다 대화 전체를 다시 보내므로 입력 처리 속도가 전체 작업 시간에 크게 영향을 준다. 원본 모델로 이 조합을 검증하는 것이 다음 개선 후보다.
  • vLLM이 추측 디코딩과 분할 입력 처리를 함께 지원하도록 고쳐지면, 같은 메모리로 더 긴 컨텍스트를 쓸 수 있다.
  • 공통된 운영 교훈도 있다. 요청을 한 번에 하나씩 보내고, 타임아웃을 길게 잡고, 프롬프트 앞부분을 고정해 접두 캐시를 살리고, 로컬 모델에게 최종 검수까지 맡기지 않는 것이다.


레퍼런스

2026년 10월 17일 토요일

REA 역공학 도구 기반 DWG 캐드파일 분석, 캐드 뷰어 및 모델러 도구 Web App 개발기

이 글은 역공학 도구인 REA(Reverse Engineering Agents)를 설치하고, 이를 이용해, AutoCAD DWG 바이너리 파일 구조를 분석한 후, 그 결과를 바탕으로 CAD 웹 뷰어를 바이브 코딩으로 개발한 과정을 간략히 기록해 남긴다. 아울러, 윈도우 실행파일 분석기로 유명한 dependency, 3D solid 모델러 등도 같은 방식으로 역공학해 웹 기반 실행 도구로 변환 개발한 후 결과를 정리한다. 

우선, DWG 파일 뷰어 개발용 테스트 대상은 연구원 본관동 평면도 DWG 파일 2종이다. 하나는 AutoCAD 2004 포맷(AC1018), 다른 하나는 2010 포맷(AC1024)으로, 둘 다 한글 텍스트와 한글 SHX 빅폰트를 사용한다. 전체 작업은 클로드 코드에 프롬프트를 주는 방식으로 진행했고, 분석부터 웹 앱 개발, 테스트까지 한 시간 남짓 걸렸다.

개발된 웹 뷰어로 연 본관동 평면도 (6장 시트, 다크 모드)

REA 소개

REA는 Ghidra, JADX 같은 역공학 엔진들을 MCP(Model Context Protocol) 서버로 묶어, 클로드 코드 같은 LLM 에이전트가 바이너리 분석을 직접 수행할 수 있게 해주는 도구다. 네이티브 바이너리 디컴파일(exe, dll 등), 안드로이드 APK 분석, 일렉트론/자바스크립트 번들 분석, 펌웨어 추출 등 200개가 넘는 분석 도구를 제공한다. 분석 결과에는 증거(Evidence)가 함께 붙어 나오므로, LLM이 지어낸 내용인지 실제 바이너리에서 확인된 내용인지 구분할 수 있다.

REA 설치 방법

윈도우 기준 설치 과정은 다음과 같다. 관리자 권한 없이 모두 포터블로 설치했다.

1) JDK 21 설치 (Ghidra 실행용). Temurin 포터블 zip을 받아 압축 해제.
2) Ghidra 12.x 설치. NSA 깃허브 릴리즈에서 zip을 받아 압축 해제.
3) (안드로이드 분석용, 선택) jadx-headless-mcp JAR 다운로드. REA가 요구하는 버전과 sha256이 일치해야 한다.
4) 환경 변수 설정: JAVA_HOME, GHIDRA_INSTALL_DIR, REA_JADX_MCP_JAR.
5) 클로드 코드에 MCP 서버 등록:

claude mcp add rea -- cmd.exe /d /c npx -y rea-agents@latest mcp

등록 후 doctor 명령으로 Ghidra, JADX 프로바이더가 healthy인지 확인하면 된다. npx 첫 실행은 패키지 다운로드 때문에 타임아웃될 수 있는데, 이 경우 앱을 재시작하면 연결된다.

DWG 파일 구조 분석

분석과 개발에 사용한 프롬프트는 대략 다음과 같다.

이 폴더 아래의 dwg 파일을 REA로 분석해 구조를 파악해줘. 헤더 필드, 섹션 구조, 한글 텍스트 인코딩, 폰트(.shx 빅폰트/.ttf)를 확인하고 바이트 증거와 함께 문서로 정리해줘. 확인 안 된 항목은 추정으로 표시할 것.
이후, 그 결과를 활용해 Rust 웹 앱 개발 실행해. 한글 텍스트가 정확히 표시되어야 해.

이런식으로 하네스하면서 진행한다. 처음부터 완벽한 컨텍스트와 Goal을 넣고 하는 편이 좋으나 이 정도 도구는 적절히 피드백 주면서 개발해도 큰 무리가 없다.  

REA로 DWG 파일을 등록해 sha256 무결성 증거를 확보하고, 파일 헤더를 바이트 단위로 분석했다. 참고로 윈도우용 Ghidra 백엔드는 PE 등 실행 파일 위주라 DWG 같은 raw 데이터 이미지의 바이트 읽기는 지원하지 않았다. 이 부분은 자체 분석 스크립트와 LibreDWG(dwg2dxf) 교차 검증으로 보완했다. 확인된 주요 내용은 다음과 같다.

- 파일 헤더 고정 필드: 버전 문자열(AC1018/AC1024), 썸네일 주소(0x0D), 코드페이지(0x13), SummaryInfo 주소(0x20)
- 코드페이지 필드 값 40 = ANSI_949(한국어 CP949). DXF 변환 결과의 $DWGCODEPAGE로 교차 확인
- 썸네일 블록: 16바이트 센티널 + BMP DIB 데이터. 추출해 웹 뷰어 미리보기로 활용
- 한글 인코딩 규칙: R2004 이하는 CP949 바이트, R2007 이상은 내부 유니코드(DXF 변환 시 UTF-8)
- 텍스트 스타일: romans.shx + whgtxt.shx 같은 SHX 빅폰트 조합과 HY울릉도M, HY견고딕 등 한글 TTF
- MTEXT에는 인라인 서식 코드({\fHYwulM|b0|i0;...})가 섞여 있어 표시 전 제거 필요

분석 결과는 바이트 증거와 함께 보고서로 정리했고, 이 보고서가 이후 웹 앱 개발의 설계 근거가 됐다.

Rust 한글 지원 CAD 웹 뷰어 개발

구성은 cargo 워크스페이스로, DWG 헤더 파서/DXF 파서/MTEXT 서식 제거를 담당하는 라이브러리 크레이트와 axum 웹 서버 크레이트로 나눴다. 파이프라인은 다음과 같다.

업로드 DWG -> 자체 헤더 파싱(버전, 코드페이지, 썸네일) -> LibreDWG dwg2dxf 사이드카 변환 -> 자체 DXF 파싱 -> 평탄화된 엔티티 JSON -> HTML 캔버스 렌더링

한글 처리가 이번 개발의 핵심이었다. DXF의 $ACADVER를 보고 AC1018 이하는 encoding_rs의 EUC-KR 디코더로, AC1021 이상은 UTF-8로 분기한다. MTEXT 서식 코드는 파서에서 제거한다. 도면의 원본 폰트(whgtxt.shx 등 셰이프 폰트)는 라이선스와 포맷 문제로 재현하지 않고 Noto Sans KR 웹폰트로 대체했는데, 실명 표기 용도로는 충분하다.

1층 평면도 확대. 건설정보연구부, 숙직실 등 한글 실명이 CP949 디코딩으로 표시된다 (AC1018)
AC1024 파일의 지하층 평면도. MTEXT 서식 코드를 제거한 한글(매점, 문서고, 교육실)이 표시된다

뷰어 UX는 CAD 사용자에게 익숙한 구성으로 만들었다. 파일/보기 메뉴바, 레이어 패널(검색 필터, 표시 토글, 색상 피커로 레이어 색 즉시 변경), 휠 확대/축소와 드래그 이동, 커서 도면 좌표 표시, 다크/라이트 모드, 한국어/영어 UI 전환을 지원한다.

보기 메뉴와 레이어 검색 필터
라이트 모드 + 영문 UI

단위 테스트 16개로 CP949 디코딩(본관동 1층평면도, 레이어명 구조기둥), MTEXT 서식 제거(실제 도면 샘플), INSERT 블록 전개, 실파일 헤더 검증을 고정했다.

개발 끝난 결과는 다음과 같다. 보다시피 거의 완벽하게 기준이 된 도면 DWG 파일을 파싱, 처리 및 뷰어 렌더링되었다. 


개발 중 만난 문제들

바이브 코딩이라고 해도 중간마다 하네스해야 하고, 간단한 디버깅은 피할 수 없었다. 기록해 둘 만한 것들은 다음과 같다.

- 윈도우 GNU 러스트 툴체인에서 raw-dylib을 쓰는 최신 windows-sys 크레이트가 dlltool 오류로 빌드 실패. tokio를 1.38로 고정해 해결
- LibreDWG의 C 도구들은 260자 넘는 출력 경로에서 WRITE ERROR로 실패. 짧은 임시 경로 사용으로 해결
- DIMENSION 엔티티의 group 10(정의점)을 블록 삽입점으로 잘못 해석해 치수 지오메트리가 수천만 단위 밖으로 흩어졌던 버그. 치수의 익명 *D 블록은 원점에 그대로 전개하는 것이 맞다
- 실무 도면에는 본 도면에서 수천만 단위 떨어진 쓰레기 지오메트리가 흔해, 화면 맞춤을 min/max 대신 좌표 백분위수 트리밍으로 계산

마무리

REA 같은 역공학 MCP와 LLM 에이전트를 결합하면, 바이너리 포맷 분석부터 그 결과를 반영한 앱 개발까지 하나의 대화 흐름 안에서 처리할 수 있다. 이번 작업은 분석, 개발, 테스트, 렌더링 검증까지 한 시간 남짓 걸렸다. 다만 분석 결과를 그대로 믿기보다 LibreDWG 같은 검증된 도구와 교차 확인하는 과정, 그리고 중간 이슈를 확인하고 목표까지 가도록 가이드해줄 테스트케이스 작성은 여전히 사람이 챙겨야 할 몫이다.

부록: 윈도우 실행파일 분석기 및 솔리드 모델러 웹 버전 도구 개발

참고로 다음도 같은 방식으로 개발된 실행파일 분석기(개발자 사이 유명한 Dependency)도구 웹앱 버전, 솔리드 모델링 캐드 웹앱 버전이다.

앞서 했던 프로세스와 동일하게 진행하였다. dependency는 주요 exe, dll 과 같은 컨텍스트를 바이브코딩도구에 입력하고, 프롬프트로 개발 명령을 내렸다. 이 도구는 실행파일이 300k이하라 30분정도면 개발이 완료되었다. 실행해 보면 다음 그림과 같이 웹 기반으로 exe, dll 파일을 입력받아 내부 구조를 분석하고 의존성 트리와 관련 이슈들을 분석한 후, 알기 쉽게 데쉬보드 차트 형식으로 분석 결과를 정리해 준다. 원본 도구가 단순히 윈도우에서 만 실행되고 의존성 트리 등 만 표출해 준 것에 비해 여러 기능을 추가할 수 있다. 

역공학된 Dependency 웹앱 버전(링크)

마찬가지로, 3D 솔리드 모델링 도구도 유명한 관련 모델러를 참고해 같은 방식으로 개발을 하였고, 결과는 다음과 같다. 작업 과정 하네스를 포함해 전체 개발에 걸린 시간은 2~3시간 미만이다. 웹 기반 도구로 개발되었고, 다음 그림과 같이 유명 상용 모델러와 큰 차이가 없는 UX 경험을 할 수 있다. 

다음 영상은 실제로 이렇게 개발된 모델러를 통해 스케치 > 구속제약 설계 > 3차원 모델링 > 파라메트릭 수정 > 최종 완성된 결과를 보여준다. 단, 나머지 어셈블리 등 모델러 기능은 시간이 더 필요한 부분이라 계속 진행하지는 않았고 차후 작업으로 남겨두었다.

역공학된 3차원 솔리드 모델러

레퍼런스

2026년 10월 4일 일요일

GPT6 Codex 기반 바이브 디자인 및 영상 제작 관련 테스트 결과

이 글은 GPT6 Codex 기반 바이브 디자인 및 영상 제작 관련 테스트 결과를 간략히 기록해 남긴다. 

테스트 대상은 서울 선릉역 인근의 가상 대지에 계획한 지상 5층, 지하 2층 규모의 미술관·문화공간이다. 자하 하디드와 프랭크 게리의 조형 언어를 참고해 금속 곡면 외피와 유리 입면, 아트리움을 중심으로 구성했다. 

코덱스를 띄우고 Astra 모델에 프롬프트로 지시하자 Computer Use 하며 모델링, 렌더링, 애니메이션쉬지않고 작업한다. 레빗 등 실행하며 중간 에러나니 자가 수정 후 재시도하고 있다.ㅎ 

Rhino, Revit 을 이용해 개념 모델에서 시작해 Blender로 모델링과 재질, 조명, 카메라 동선을 작업했다. 상공에서 건물을 조망하다가 점차 내려와 입구를 통과하고, 로비와 전시 공간을 둘러보는 32초 애니메이션을 제작했다. 주요 장면은 별도의 이미지로 렌더링했다.

이후 힉스필드를 연결해 영상의 실사화도 테스트했다. 작업 화면 녹화본에서 외부 전경과 입구 접근 부분을 추출하고, 화면 UI를 잘라낸 뒤 짧은 영상으로 변환했다. 10크레딧 예산을 고려해 해상도와 길이를 제한했으며, 최종 결과는 약 8.4초, 960×512 해상도였다. 실제 사용량은 8.46크레딧이었다.

실사화 과정에서 금속 외피와 유리 반사, 조경, 주변 건물의 표현은 한층 풍부해졌다. 다만 일부 건물 형상과 디테일이 원본과 달라지는 현상도 확인했다. 설계 형태의 정확성을 검토할 때는 원본 모델과 Blender 렌더링을 기준으로 삼고, 생성형 영상은 분위기와 공간 경험을 전달하는 용도로 활용하는 편이 적절해 보였다.

이번 테스트에서는 자연어 지시를 통해 개념 모델링부터 카메라 애니메이션, 주요 장면 렌더링, 영상 실사화까지 이어지는 작업 흐름을 확인했다. 

초기 설계안을 빠르게 시각화하고 클라이언트와 공유하는 데 활용 가능성이 있지만, 설계 정확도와 영상의 시각적 완성도는 AI가 설계 영상 의도를 정확히 추론할 수 있도록 적절한 컨텐츠(도면, 설계치수, 배경, 목적 등)와 프롬프트 하네스 작업에 크게 영향을 받는다.

이 작업은 다른 일을 하면서 두시간 정도에 걸쳐 진행되었고, 개념 설계 정도로 시작하였다. 참고로, 상세 프롬프트는 다음과 같다(사실 이 테스트에서 내가 준 컨텐츠는 거의 없었다).

> 건축가 프랭크 게리 스타일로 Revit을 이용해 모델링해 줘. 지상 5층, 지하 2층 규모의 럭셔리 미술관 및 문화공간으로 기획하고 진행해 줘. 위치는 서울 강남구 선릉역 근처야. 가상 대지로 개념설계 진행.

> 클라이언트 입장에서 다양한 뷰로 렌더링해 줘. 건물을 설명하는 도면뿐 아니라, 외관과 공간 분위기를 이해할 수 있는 여러 시점의 이미지를 요청.

작업 과정을 화면에서 확인하기 위해 다음 지시도 추가했다.

> 모델링 과정을 Blender의 해당 위치 뷰로 줌·팬하면서 보여 줘.

> 모델링이 끝나면 스카이 뷰로 위에서 마치 새가 날아오는 것처럼 건물을 조망해 줘. 점점 카메라를 아래로 내려 입구까지 들어간 다음, 실내를 한 번 훑어보는 식으로 Blender 애니메이션을 작성해 줘. 주요 장면도 캡처해서 렌더링해 줘.

카메라의 출발점과 이동 순서, 최종 도착 공간을 자연어로 지정했다. 결과물은 상공 조망에서 입구와 실내로 이어지는 32초 영상과 주요 장면 이미지로 구성했다.

> 이 애니메이션 영상을 힉스필드로 연결해서 영상 제작해. 힉스필드를 이용해서 사실적으로 영상을 제작해 봐. 단, 해상도나 작업량은 사용량을 고려해서 진행해 줘. 현재 힉스필드 크레딧은 10개 내로만 사용해.

> 첨부 영상의 외부 건물 전경에서 들어가는 부분만 추출해 짧게 실사화해 줘. 

최종 결과는 약 8.4초, 960×512 였으며, 8.46크레딧을 사용했다. 형태 보존을 요청했음에도 일부 디테일은 달라졌으므로, 생성 결과를 원본 설계와 비교하는 과정은 필요하다.

2026년 10월 3일 토요일

MoE LLM 개발을 통해 본 Claude code 와 Codex 최신 모델 간 바이브 코딩 성능 비교

이 글은 현 시점에서 Claude code 와 Codex 최신 모델 간 바이브 코딩 성능 비교를 위해 간단한 LLM의 MoE구조를 개발하고 테스트해본 사례를 정리한다.

PRD 설계

가급적 동일한 비교를 위해 아래 목적에 맞는 MoE 기반 LLM 개발을 위한 간단한 PRD를 우선 설계한다.

# PRD — nano MoE

문자 단위 Mixture-of-Experts 언어 모델 학습·실험 도구

| 항목 | 내용 |
|---|---|
| 프로젝트 | nano_moe |
| 버전 | 1.0 (2026-10-04 기준 구현 반영) |
| 상태 | 구현 완료 (모델 코어 · CLI · 웹 UX) |
| 실행 환경 | Windows, Python 3.12 (`venv_lmm`), PyTorch ≥ 2.5, Flask ≥ 3.0 |

---

## 1. 개요

nano MoE는 PyTorch만으로 구현한 소형 문자 단위 decoder-only Mixture-of-Experts(MoE) 언어 모델이다. MoE 학습 구조(top-k 라우팅, 전문가 용량, 균형 손실)를 작은 규모에서 직접 실행하며 학습하기 위한 교육·실험용 프로젝트이며, 범용 언어 모델 제작이 목적이 아니다.

CLI(`train.py`)로 학습·생성을 수행할 수 있고, Flask 기반 웹 UX(`webapp/`)로 데이터 설정 → 학습 → 로그/그래프 확인 → 모델 저장·로딩 → 챗봇 스타일 생성까지 한 화면에서 처리할 수 있다.

## 2. 목표 / 비목표

### 목표
- MoE 핵심 메커니즘(라우터, top-k 선택, 용량 제한, 균형 손실, z-loss)을 읽기 쉬운 최소 코드로 구현한다.
- CPU에서도 수 초 내 확인 가능한 소규모 학습 루프를 제공하고, CUDA가 있으면 자동 활용한다(bf16 autocast 포함).
- 비전문가도 브라우저에서 하이퍼파라미터 설정부터 텍스트 생성까지 전체 사이클을 수행할 수 있는 웹 UI를 제공한다.

### 비목표
- 대규모/분산 학습, 프로덕션 서빙, 멀티유저 동시 사용.
- 서브워드(BPE 등) 토크나이저 — 문자 단위 토큰화만 지원.
- 학습 데이터에 없는 문자를 포함한 프롬프트 처리.

## 3. 대상 사용자

- MoE 아키텍처 내부 동작을 코드로 확인하려는 개발자·학습자.
- 작은 텍스트로 학습→생성 사이클을 빠르게 반복 실험하려는 사용자.

## 4. 시스템 구성

```
nano_moe/
├─ nano_moe/            # 모델 패키지
│  ├─ model.py          #   ModelConfig, CausalAttention, Block, NanoMoE(forward/generate)
│  ├─ moe.py            #   Expert(FFN), MoELayer(top-k 라우터·용량·균형/z 손실)
│  └─ data.py           #   TextData: 문자 토큰화, 90/10 분할, 배치 샘플링
├─ train.py             # CLI: train / generate 서브커맨드
├─ webapp/              # Flask 웹 UX
│  ├─ app.py            #   REST API + 백그라운드 학습 스레드
│  ├─ templates/index.html
│  └─ static/{style.css, app.js}
├─ tests/test_model.py  # 단위 테스트 3종
├─ data/sample.txt      # 예제 학습 텍스트
├─ checkpoints/         # 체크포인트 저장 위치 (기본 nano_moe.pt)
└─ run.bat              # 웹 UI 원클릭 실행 (venv python 직접 호출 + 브라우저 자동 오픈)
```

## 5. 기능 요구사항

### 5.1 모델 코어 (`nano_moe/`)

| ID | 요구사항 | 구현 |
|---|---|---|
| M-1 | 문자 단위 토큰화: UTF-8 텍스트의 고유 문자 집합을 vocab으로 사용, train/validation 90/10 분할 | `data.py` TextData |
| M-2 | decoder-only Transformer: 토큰+위치 임베딩, 인과적 어텐션(SDPA `is_causal`), pre-LayerNorm 잔차 블록 | `model.py` |
| M-3 | `moe_every` 번째 블록의 FFN을 MoE 레이어로 교체, 나머지는 일반 FFN(Expert) | `model.py` Block |
| M-4 | top-k 라우팅: 라우터는 float32로 계산, 학습 중에만 노이즈 라우팅(softplus 스케일 가우시안) 적용 | `moe.py` MoELayer |
| M-5 | 전문가 용량 제한: `ceil(tokens × top_k × capacity_factor / experts)`, 초과분은 후순위 선택부터 드롭 | `moe.py` |
| M-6 | 보조 손실: 전문가 사용 균형 손실(가중치 0.01) + 라우터 z-loss(가중치 0.001)를 LM 손실에 합산 | `model.py` forward |
| M-7 | 자기회귀 생성: 온도 샘플링, 컨텍스트 길이 초과 시 최근 토큰으로 절단 | `model.py` generate |
| M-8 | 설정 검증: vocab/context/width/heads/layers 유효성, top-k ≤ experts 등 즉시 예외 | ModelConfig, MoELayer |

### 5.2 CLI (`train.py`)

| ID | 요구사항 | 구현 |
|---|---|---|
| C-1 | `train` 서브커맨드: 데이터·하이퍼파라미터 인자, 주기적 train/val 손실 출력, 체크포인트 저장(config+vocab+state_dict) | 기본 100스텝, `checkpoints/nano_moe.pt` |
| C-2 | `generate` 서브커맨드: 체크포인트 로딩 후 프롬프트 이어쓰기, vocab에 없는 문자는 에러 | 기본 80토큰, 온도 0.8 |
| C-3 | CUDA 자동 감지, bf16 지원 시 autocast, grad clip 1.0 | train() |

### 5.3 웹 UX (`webapp/`)

레이아웃: 다크 테마 단일 페이지, 좌/우 2패널. 헤더에서 한국어/영어 전환(localStorage 유지).

**왼쪽 패널 — 학습 관리**

| ID | 요구사항 | 구현 |
|---|---|---|
| W-1 | 학습 데이터 파일 경로 + 하이퍼파라미터 13종(스텝, 배치, 컨텍스트, 폭, 헤드, 레이어, MoE 주기, 전문가 수, top-k, 학습률, 로그 주기, 시드) 입력 폼 | `POST /api/train/start` |
| W-2 | 학습 시작/중지: 백그라운드 스레드 실행, 중복 실행 거부(409), 중지 플래그로 안전 중단 | `POST /api/train/stop` |
| W-3 | 실시간 로그: 1초 폴링으로 증분 수신(`since` 인덱스), 자동 스크롤 | `GET /api/status` |
| W-4 | 손실 그래프: train/val 손실을 스텝별 라인 차트로 표시 (Chart.js) | status의 history |
| W-5 | 모델 저장/로딩: 경로 지정 후 체크포인트 저장·로딩, 결과를 상태 표시줄에 피드백 | `POST /api/model/save`, `/api/model/load` |
| W-6 | 모델 상태 배지: 메모리 내 모델 유무를 헤더에 표시 | model_loaded |

**오른쪽 패널 — 챗봇 생성**

| ID | 요구사항 | 구현 |
|---|---|---|
| W-7 | 챗봇 스타일 UI: 사용자/모델 말풍선, Enter 전송(Shift+Enter 줄바꿈) | `POST /api/generate` |
| W-8 | 생성 파라미터: 토큰 수, 온도 조절 | 기본 80토큰 / 0.8 |
| W-9 | 에러 안내: 모델 없음, 빈 프롬프트, vocab에 없는 문자(해당 문자 목록 표시)를 구분해 현재 언어로 표시 | 에러 코드 기반 i18n |

### 5.4 실행 편의

| ID | 요구사항 | 구현 |
|---|---|---|
| R-1 | 원클릭 실행: conda 없이 venv python 절대경로로 서버 기동, 3초 후 브라우저 자동 오픈, 종료 시 에러 확인 가능하도록 창 유지 | `run.bat` |

## 6. 비기능 요구사항

- **성능**: 기본 설정(100스텝, width 64) 학습이 단일 GPU에서 수 초, CPU에서도 분 단위 내 완료. 생성 응답은 동기 처리.
- **동시성**: 단일 사용자 가정. 공유 상태는 lock으로 보호하고, 학습 중복 시작은 거부.
- **신뢰성**: 학습 스레드 예외는 로그로 노출하고 서버는 유지. 체크포인트는 `weights_only=True`로 로딩.
- **사용성**: 한/영 즉시 전환, 다크 테마 고정, 900px 이하에서 1열 반응형.
- **이식성**: 외부 의존성은 torch, flask 두 개. 프론트엔드는 Chart.js CDN 외 순수 HTML/CSS/JS.

## 7. 검증 (Definition of Done)

- `python -m unittest discover -s tests -v` — 라우터 그래디언트 존재, 인과성, 용량 제한·생성 shape 테스트 통과.
- CLI: `python train.py train --steps 100` 후 `python train.py generate` 로 생성 확인.
- 웹: 페이지 로드(200) → 학습 시작 → 로그·손실 히스토리 수신 → 저장 → 로딩 → 생성(지정 토큰 수) → 미지원 문자 400 응답까지 전체 플로우 검증 완료.

## 8. 제약 및 알려진 한계

- 프롬프트는 학습 데이터에 등장한 문자만 사용 가능(문자 단위 vocab의 구조적 제약). UI는 불가 문자를 명시해 안내한다.
- 체크포인트는 config·vocab을 함께 저장하므로 다른 데이터로 학습한 모델과 호환되지만, vocab이 다르면 생성 가능한 문자도 달라진다.
- Flask 개발 서버 사용 — 로컬 단일 사용자 용도이며 외부 노출·프로덕션 배포는 범위 밖.
- 학습 중 생성 요청은 직전 완료된 모델이 없으면 거부된다(학습 완료 시점에 모델이 교체됨).

## 9. 향후 과제 (범위 밖 제안)

- 학습 중 체크포인트 중간 저장 및 조기 중단 시 모델 보존.
- 데이터 파일 업로드 UI(현재는 서버 경로 입력 방식).
- 전문가별 라우팅 통계(사용률 히트맵) 시각화.
- 서브워드 토크나이저 옵션.

바이브 코딩 진행

바이브 코딩 진행은 각 독립 폴더에 해당 도구를 CLI 모드에서 실행해서 모델을 다음과 같이 설정한다.

코덱스 설정

클로드 설정

이후 PRD를 읽게 하고 프로젝트 개발하도록 하였다.

결과

플젝 생성 결과는 다음과 같다.

  • 클로드: 12.9분 소요. 소요 토큰수 251,278. 파일수 23개. 총 용량 1.82M. 총 라인수 1,370(코드만 1,203줄). 
  • 코덱스: 23분 소요. 소요 토큰수 1,038,041. 파일 수 35개. 총 용량 1.86M. 총 라인수 1,337줄(코드만 1,088줄).

다음과 같이 결과는 유사하게 실행된다. 다만, 명확히 지시하지 않았던 UX 테마 스타일이 달라 코덱스는 좀 화려한 형광색 위주로 생성되고, 페이블은 간략화된 다크테마 스타일로 생성된다. 


알고리즘 차이는 클로드 코드는 라우팅 순위 우선(top-1 먼저), 코덱스는 시간 순 우선(앞 토큰 먼저 보존 후 생성 시 prefix 라우팅 인과성 보존 방식이며, 학습 안정성 및 재현성은 코덱스는 노이즈 라우터 0 초기화 + 1e-2 하한(초반 안정), std=0.02 초기화, 시드 고정 Generator로 손실 곡선 완전 재현하였으며, 클로드는 eval 배치가 매번 랜덤이라 val 곡선에 노이즈 섞였다. 

코드 견고성은 코덱스가 신경써 개발되었고, 체크포인트 원자적 저장(tempfile+replace) 및 로딩 시 vocab 무결성 검증, utf-8-sig(BOM) 처리, 데이터 로딩 시점에 split 길이 즉시 검증, 웹은 전역 errorhandler, lock 2개로 학습/생성/로딩 직렬화, run_id로 세션 구분, CLI 인자를 dataclass에서 자동 생성을 고려하였다. 

결론적으로 깊게 생각하는 차이(12분과 23분)를 고려한다면 결과를 고려할 때 바이브 코딩 모델 성능 간 큰 차이는 없어 보인다. 이 조건(생각하는 차이)에서도 결과물인 모델의 수렴 성능을 가르는 차이는 없고(실측 동일), 코덱스가 좀 더 오래 생각하며 방어 코드 재현성에서 더 촘촘하게 개발하였고, 클로드는 본 프로젝트 목적에 맞는 더 읽기 쉬운 미니멀한 코드 생성하였다. 

2026년 7월 31일 금요일

NVIDIA DGX Spark에서 Isaac Sim, Isaac Lab 로봇 피지컬AI 시뮬레이션 개발환경 구축기

이 글은 NVIDIA DGX Spark(GB10, ARM64) 장비에 Isaac Sim과 Isaac Lab을 설치하고, 로봇 시뮬레이션과 강화학습까지 실행해 본 개발환경 구축기를 간단히 나눔한다. 요즘 피지컬 AI가 화두인데, 시뮬레이션에서 로봇 정책을 학습해 실물에 이식하는 sim-to-real 워크플로 실행 환경을 세팅해 보고 간단한 예제를 실행해 본다. 참고로, DGX Spark는 ARM 기반 Grace CPU와 Blackwell GPU가 통합 메모리를 공유하는 독특한 구조라서, 설치 과정에 x86 장비와는 다른 함정이 몇 군데 있었다. 이 글에서 해당 부분을 함께 정리한다.

개요

Isaac Sim은 NVIDIA Omniverse 기반의 로봇 시뮬레이터로, USD(Universal Scene Description)를 네이티브 씬 포맷으로 사용한다. RTX 레이트레이싱 렌더링, PhysX 물리엔진, 카메라 및 LiDAR 같은 합성 센서 시뮬레이션을 제공한다. Isaac Lab은 그 위에 구축된 로봇 학습 프레임워크로, GPU에서 수천 개 환경을 병렬로 돌려 강화학습(PPO 등)과 모방학습을 수행한다.

엔비디아 아이작 심 시뮬레이터

설치 대상 환경은 다음과 같다.

  • 장비: NVIDIA DGX Spark (GB10, ARM64/aarch64, 통합 메모리 121GB)
  • OS: Ubuntu 24.04 (DGX OS), 드라이버 580.159.03, CUDA 13.0
  • Isaac Sim 6.0.1, Isaac Lab 3.0.0b2, PyTorch 2.11 (cu130)

Isaac Sim의 ARM64(aarch64) 빌드는 현재 DGX Spark에서 공식 지원되며, 드라이버는 580.159.03이 권장 버전이다. 더 최신인 R590 계열 드라이버에서는 RTX 렌더러가 크래시하는 이슈가 보고되어 있으므로 드라이버 버전을 먼저 확인하는 것이 좋다.

1단계. 파이썬 환경 준비

Isaac Sim 6.x는 파이썬 3.12용 pip 패키지(cp312, manylinux_2_35_aarch64 휠)를 제공한다. 처음에는 시스템 python3.12로 가상환경인 venv를 만들었다. 본인의 경우, 설치 중 psutil과 PyOpenGL-accelerate가 소스 빌드되면서 Python.h 헤더가 없다는 에러로 실패했다. python3.12-dev를 apt로 설치하면 되지만 sudo 권한이 필요한 상황이었고, 대신 conda(miniforge)의 파이썬을 쓰면 개발 헤더가 자체 포함되어 있어 시스템 패키지 없이 해결된다. 가상환경은 터미널에서 다음과 같이 생성한다. 

conda create -n venv_sim -y python=3.12
conda activate venv_sim

2단계. PyTorch와 Isaac Sim 설치

DGX Spark는 CUDA 13 환경이므로 cu130 빌드의 PyTorch를 먼저 설치하고, 이어서 Isaac Sim 전체 패키지를 설치한다.

pip install -U torch==2.11.0 --index-url https://download.pytorch.org/whl/cu130
pip install "isaacsim[all,extscache]==6.0.1.0" --extra-index-url https://pypi.nvidia.com

다운로드 용량이 수 GB라서 시간이 좀 걸린다. 설치 후 실행 전에 환경변수 두 개를 설정해야 한다. EULA 동의와, aarch64에서 필수인 OpenMP 라이브러리 프리로드이다. 특히 두 번째 것을 빼먹으면 공유 라이브러리 로드 순서 문제로 실행이 그냥 종료되므로 주의한다.

export OMNI_KIT_ACCEPT_EULA=YES
export LD_PRELOAD=/lib/aarch64-linux-gnu/libgomp.so.1

3단계. 실행 확인

먼저 헤드리스 모드로 SimulationApp을 띄워 USD 스테이지 생성과 프레임 스텝이 정상 동작하는지 확인한다. 

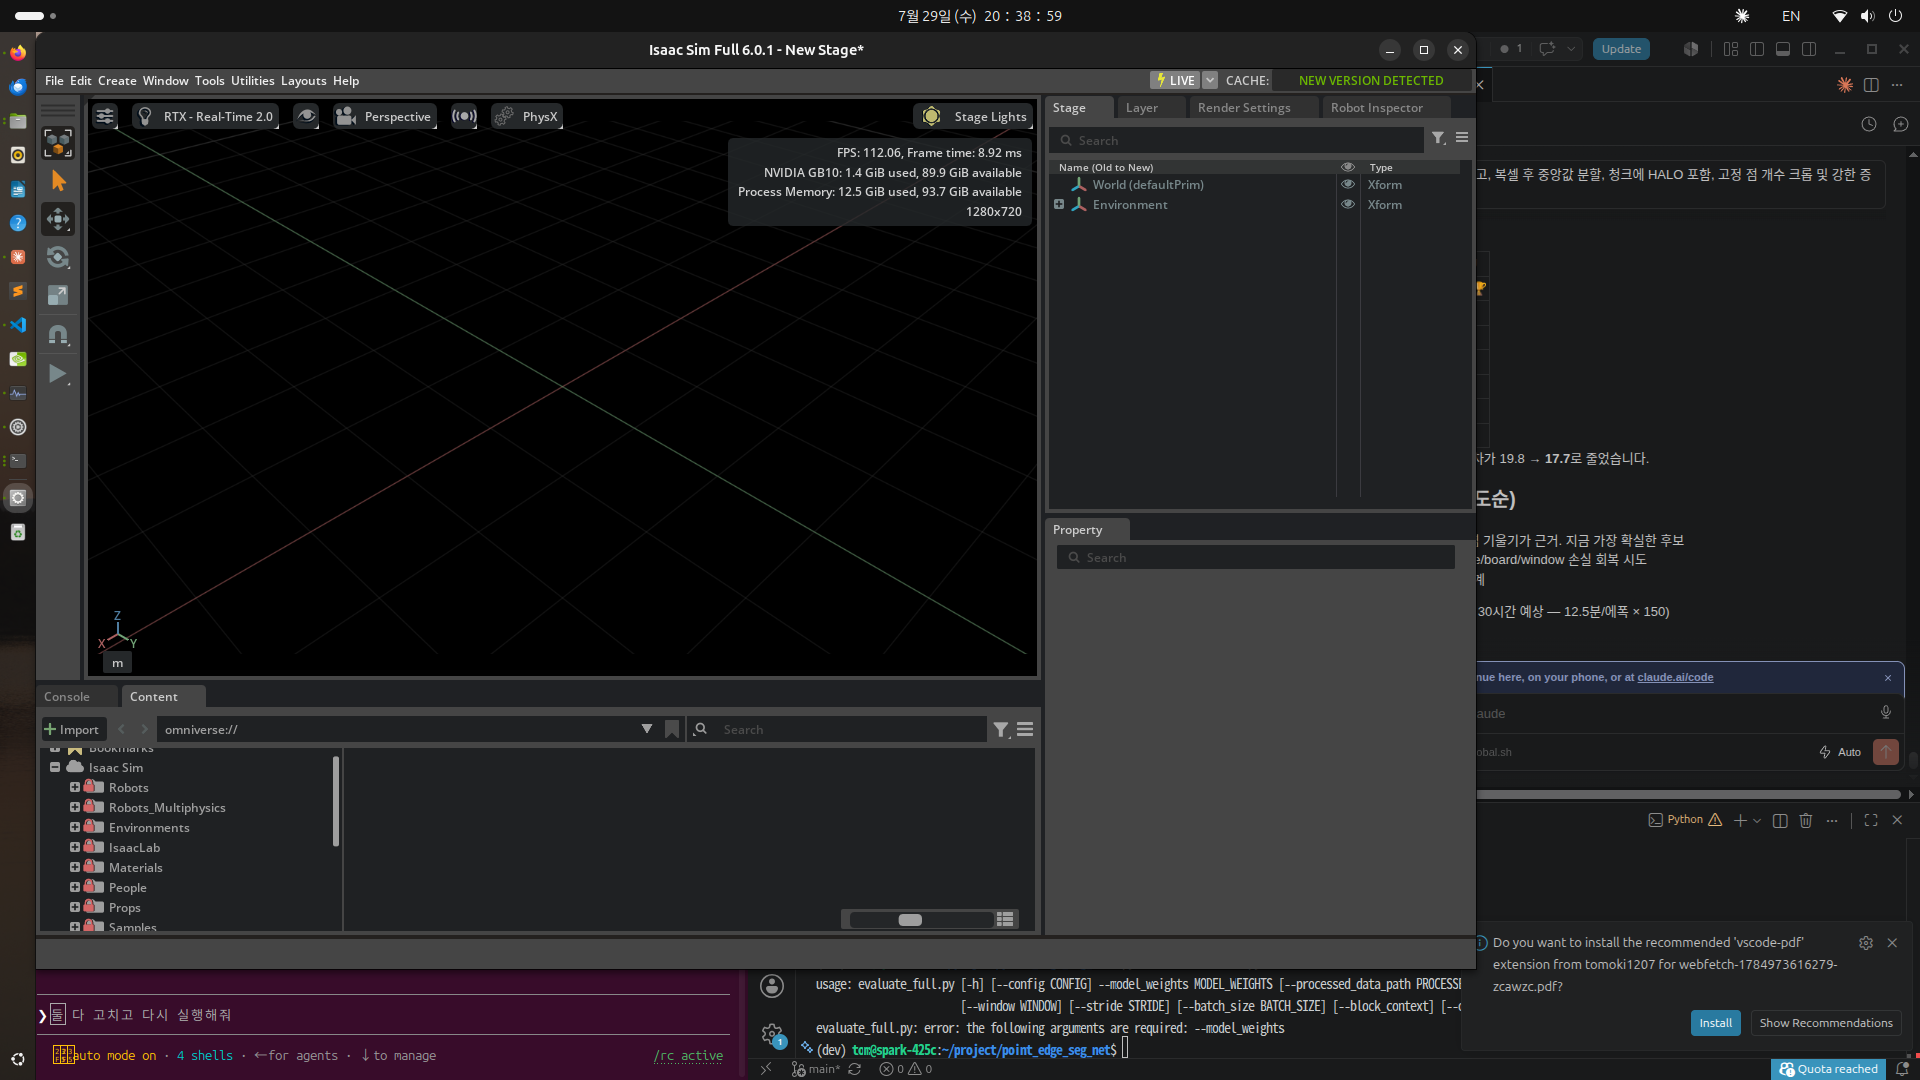
GB10 GPU가 Vulkan 백엔드로 인식되고, 93GB의 GPU 가용 메모리가 잡히는 것을 볼 수 있었다. 이어서 GUI 모드를 실행하면 첫 구동 시 셰이더 컴파일 때문에 수 분이 걸리는데, 완료되면 RTX 실시간 렌더링 뷰포트가 110 FPS 내외로 부드럽게 돌아간다.

isaacsim   # GUI 실행

Isaac Sim 6.0.1 GUI 첫 실행 화면. RTX 뷰포트가 112 FPS로 렌더링되고 있다

4단계. 로봇 데모 실행

환경이 잡혔으니 로봇을 움직여 봤다. Isaac Sim 6.0부터는 사전학습된 강화학습 정책 예제가 isaacsim.robot.policy.examples 모듈로 제공된다. 

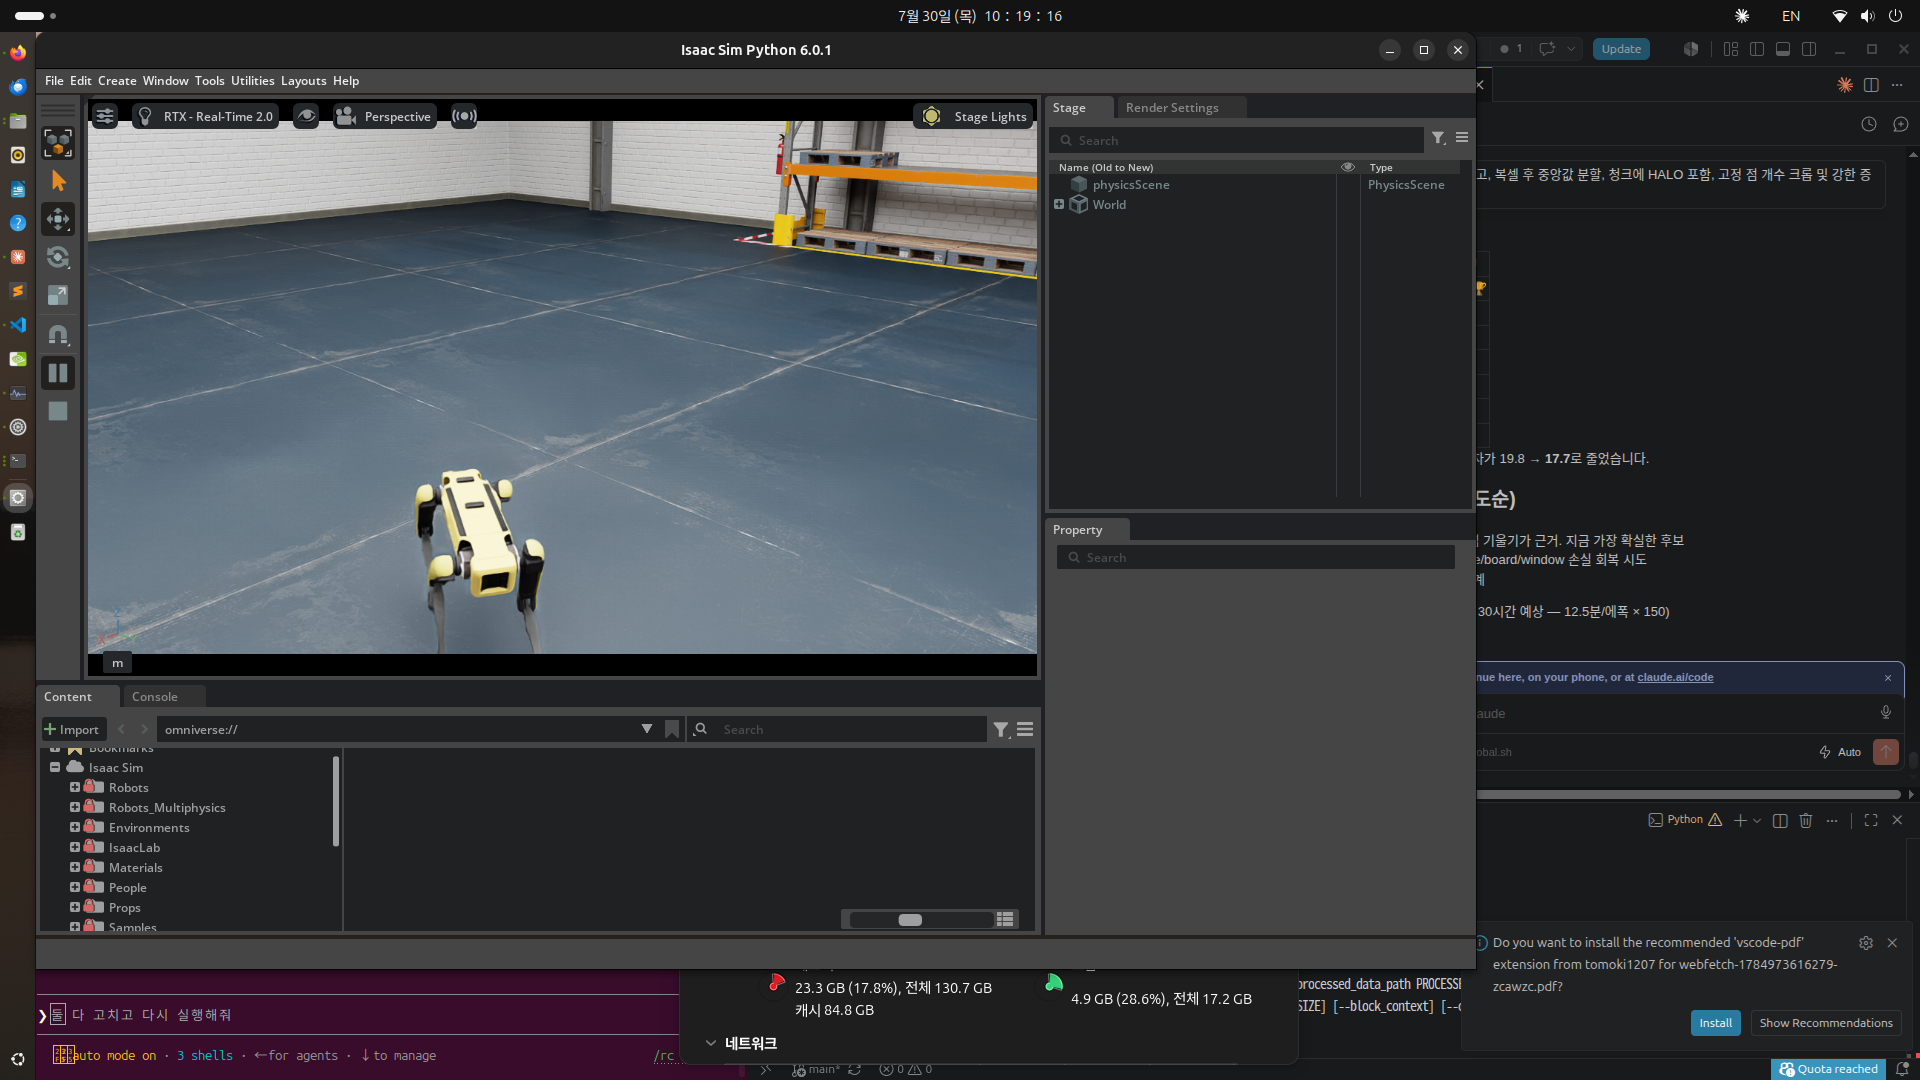
상단 메뉴 바의 Isaac Examples > Robots > Quadrupeds > Spot RL Policy를 선택하면 Boston Dynamics Spot 4족보행 로봇이 창고 환경에 자동으로 스폰된다. 이어서 우측 Property 패널에서 학습된 보행 정책(SpotFlatTerrainPolicy)을 확인한 뒤, 좌측의 Play 버튼을 누르고 Robot Controller UI를 통해 속도 명령(Velocity Command)을 주면 로봇이 실제로 걸어 다닌다. 

로봇 애셋과 정책 체크포인트는 NVIDIA 클라우드에서 자동으로 스트리밍되므로 별도의 대용량 파일 다운로드 없이 바로 테스트해 볼 수 있다

한 가지 주의할 점은 API 변화이다. 6.0에서는 정책 명령을 numpy 배열이 아닌 torch 텐서로 넘겨야 하고, 구버전 예제 모듈(omni.isaac.* 계열)은 상당수 제거되었다. 구버전 튜토리얼 코드를 그대로 쓰면 에러가 나므로 모듈 경로를 확인해야 한다.

창고 환경에서 강화학습 정책으로 보행 중인 Spot 로봇

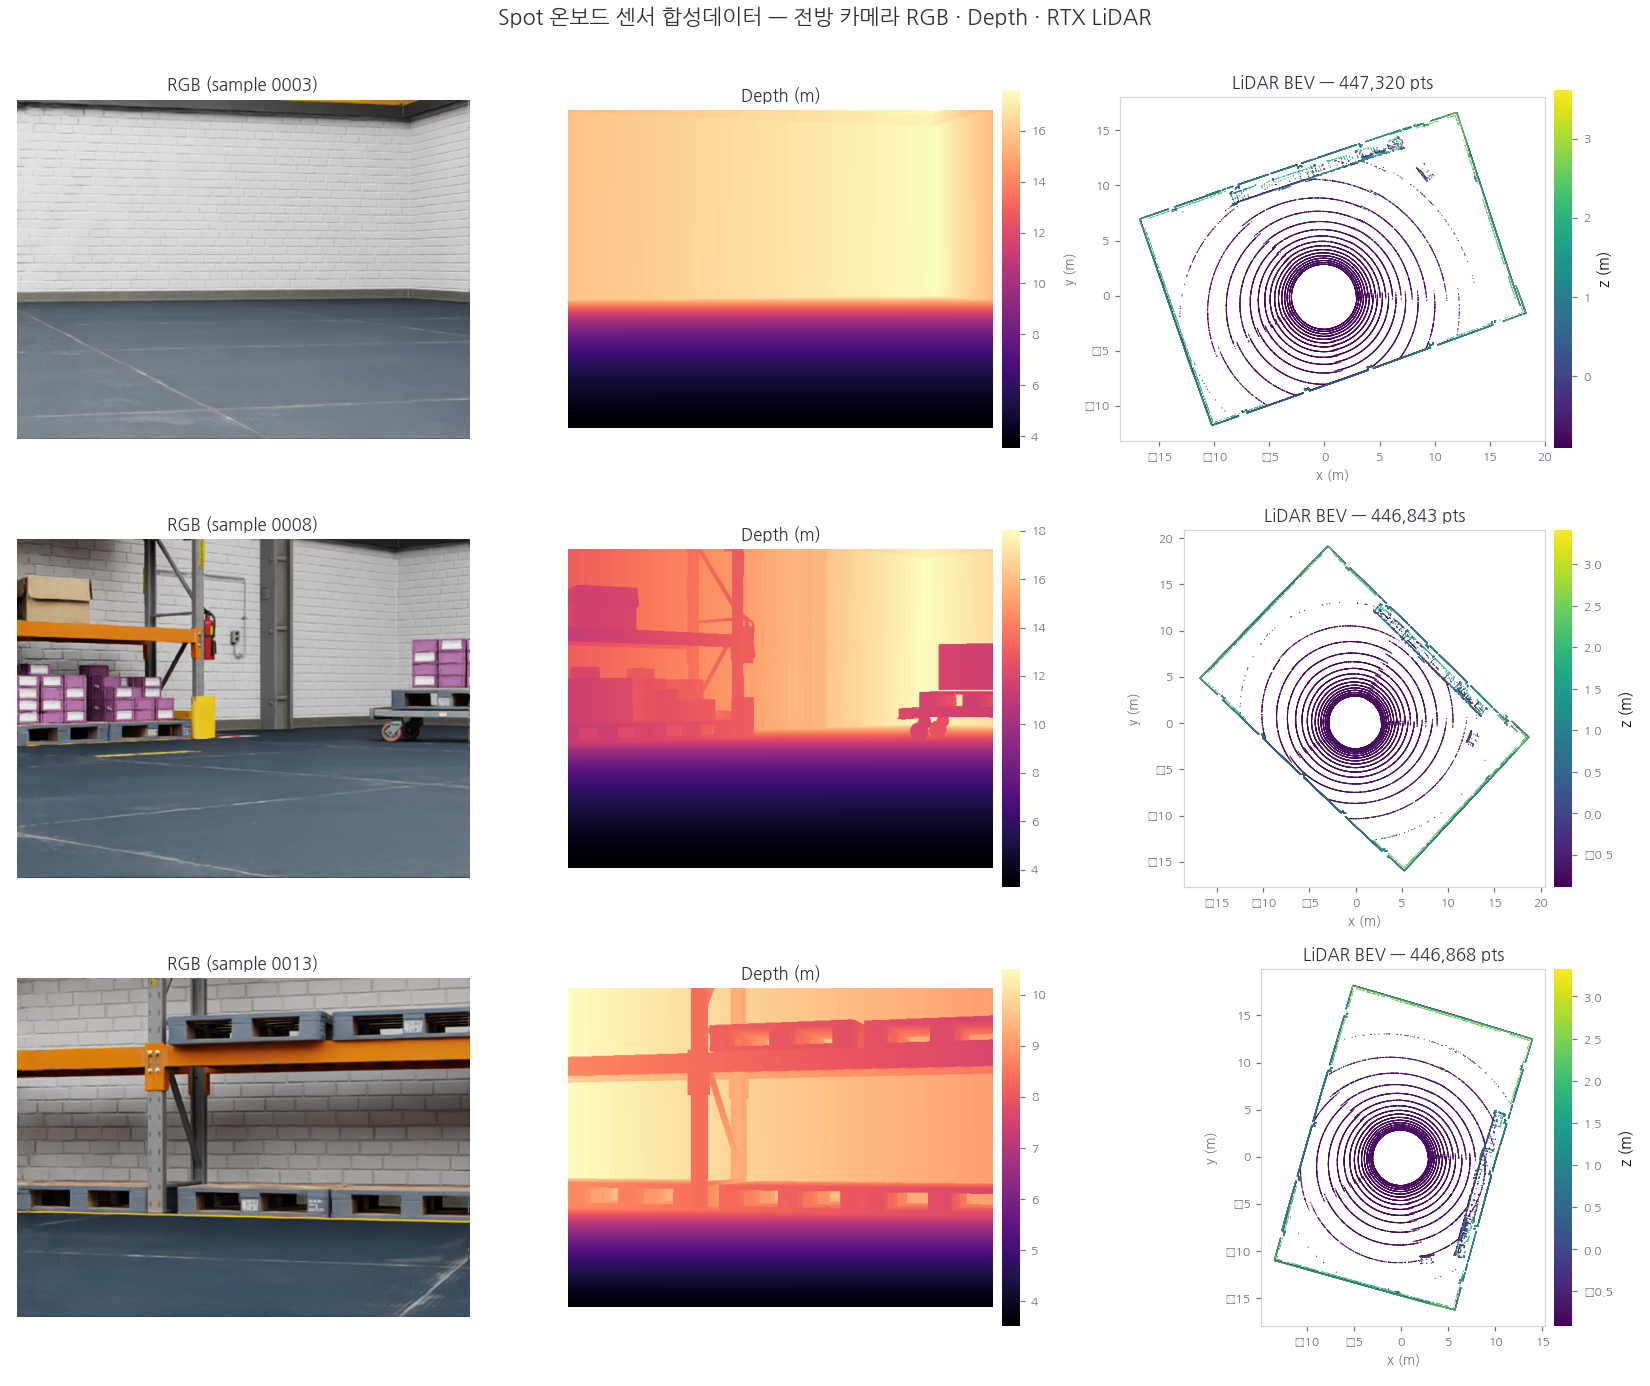
여기에 센서와 데이터 수집 파이프라인을 연결해 봤다. 상단 메뉴의 Create > Sensors 항목에서 Camera와 RTX LiDAR를 로봇 몸체에 부착한 뒤, Isaac Tools > Synthetic Data Recorder 패널을 열어 저장할 데이터를 설정한다. 이어서 시뮬레이션을 재생하고 Start Recording 버튼을 누르면 로봇이 걸어 다니는 동안 RGB 영상, 뎁스맵, 프레임당 약 44만 포인트의 LiDAR 포인트클라우드가 자동으로 추출되어 저장된다. 이렇게 쌓인 정밀한 센서 데이터가 바로 객체 인식 및 자율주행 모델 학습용 합성 데이터셋의 핵심 재료가 된다.

Spot 온보드 센서로 수집한 RGB, 뎁스, LiDAR 데이터

5단계. Isaac Lab 설치와 강화학습

이제 직접 정책을 학습할 차례이다. Isaac Lab은 pip로 설치할 수 있는데, Isaac Sim 6.0에 대응하는 버전은 3.0.0b2 계열이다. 학습 스크립트는 pip 패키지에 포함되지 않으므로 저장소를 따로 클론한다.

pip install "isaaclab[all]==3.0.0b2.post1" --extra-index-url https://pypi.nvidia.com
git clone --depth 1 https://github.com/isaac-sim/IsaacLab.git

ANYmal-D 4족보행 로봇의 속도 추종 태스크를 PPO로 학습시켜 봤다. 터미널에서 train.py 스크립트를 실행해 --num_envs 2048 인자로 2048개 환경을 GPU에서 병렬로 돌렸다. 

python scripts/reinforcement_learning/rsl_rl/train.py \
  --task Isaac-Velocity-Flat-Anymal-D-v0 --headless --num_envs 4096 --max_iterations 500

순수 학습 시간 기준으로 100 iteration이 약 1분 35초밖에 걸리지 않았다. 이어서 --num_envs 4096으로 인자를 변경하여 환경 수를 4096개로 올려봐도, 통합 메모리 덕분에 VRAM 부족(OOM) 걱정 없이 대규모 강화학습을 안정적으로 진행할 수 있었다. 결과 로그는 TensorBoard / Console Log 에서 확인한다. 

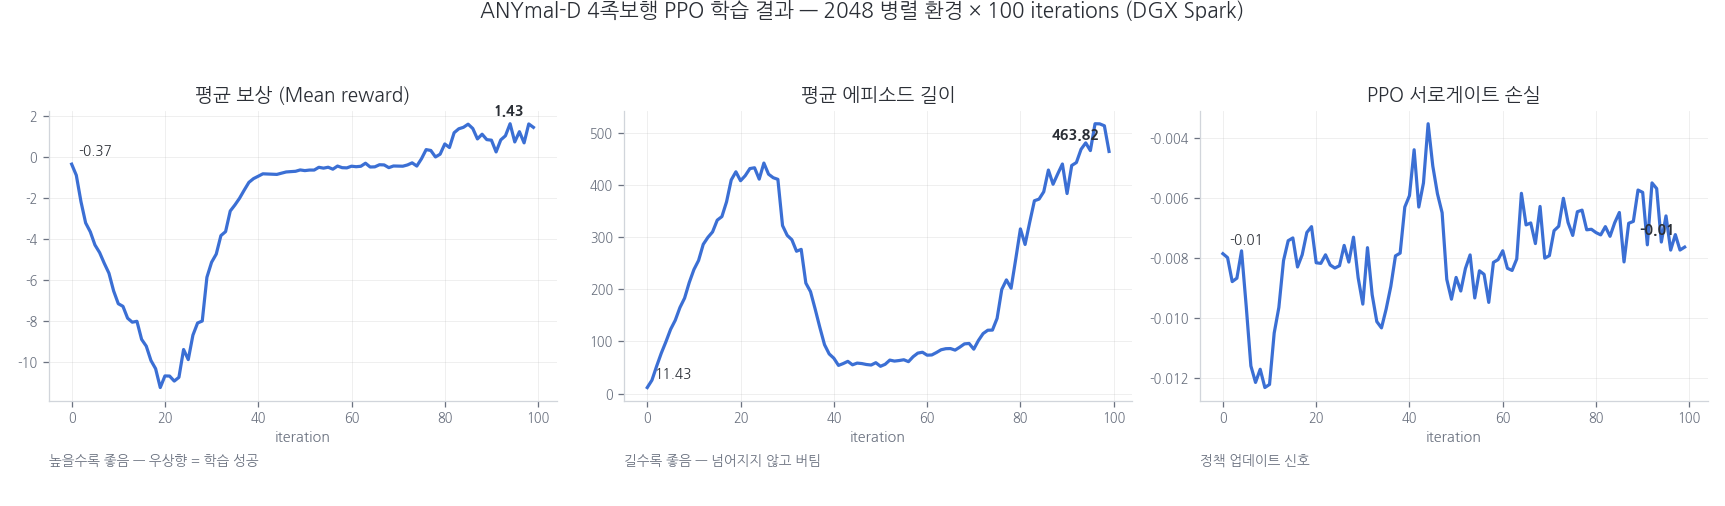
학습 곡선을 보면 강화학습의 전형적인 패턴이 그대로 나타난다. 초반에는 로봇들이 명령 추종을 시도하다가 넘어지면서 보상이 급락하고, 넘어지지 않는 법을 터득한 뒤 회복하며, 이후 명령 추종 정밀도를 다듬으면서 완만히 상승한다. 500 iteration(약 8분) 학습 후 평균 보상 22.7, 속도 추종 오차는 정상 상태 기준 0.1 m/s 수준까지 내려갔다.

ANYmal-D PPO 학습 곡선. 탐색기의 보상 급락과 회복, 우상향 패턴이 보인다

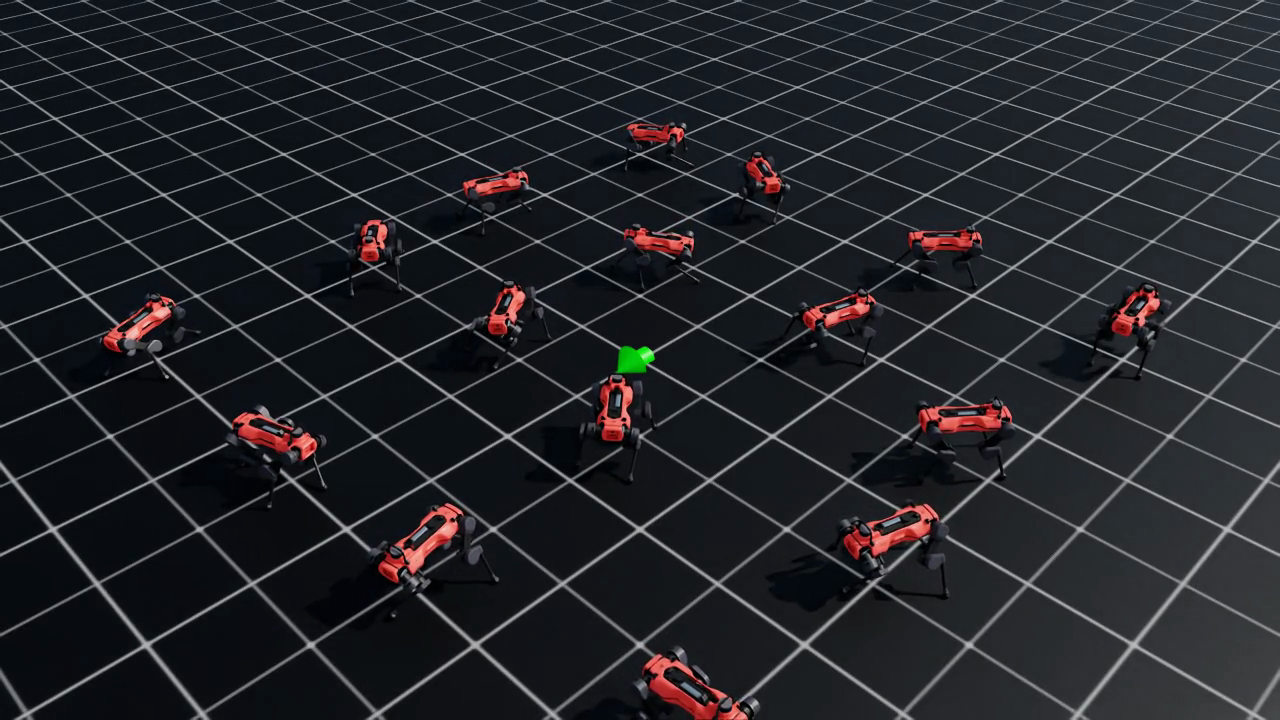
학습 완료 후 play.py 스크립트 (python play.py --task Isaac-Velocity-Flat-Anymal-D-v0 --num_envs 16)를 통해 학습된 정책을 재생해 봤다. Isaac Sim 화면에서 16대의 로봇이 각자 무작위 속도 명령을 전달받아 서로 다른 방향으로 자유롭게 걸어 다니는 것을 확인할 수 있다. 특히 구동 과정에서 학습 산출물로 model.onnx 파일이 자동 내보내기되는데, 이 파일을 실물 로봇의 온보드 컴퓨터에 올리기만 하면 시뮬레이션 정책을 실재 로봇으로 바로 이식할 수 있는 편리한 Sim-to-Real 구조를 제공한다.

학습 완료된 정책으로 보행 중인 ANYmal 로봇 16대

마무리

정리하면, 현재 시점에서 DGX Spark에서 Isaac Sim과 Isaac Lab 개발환경 구축 고려사항은 다음과 같다.

  • 드라이버는 580.159.03 권장. R590 계열은 RTX 렌더러 크래시 이슈가 있다
  • 파이썬은 conda의 3.12를 사용하면 개발 헤더 문제를 피할 수 있다
  • PyTorch는 cu130 빌드, Isaac Sim은 pypi.nvidia.com 인덱스에서 설치한다
  • aarch64에서는 LD_PRELOAD로 libgomp를 프리로드해야 한다
  • Isaac Sim 6.0의 API 변화(torch 텐서 명령, 모듈 경로 개편)에 주의한다

시뮬레이션, 합성 데이터 생성, 강화학습까지 장비 한 대에서 모두 돌아가는 것을 확인했다. 특히 통합 메모리 121GB는 대규모 병렬 환경 학습에서 체감 이점이 컸다. 오픈소스와 사전학습 정책, 클라우드 애셋이 잘 갖춰져 있어서, 예전 같으면 몇 주 걸렸을 환경 구축과 검증이 하루 안에 끝났다. 하드웨어 문제가 해결되면, 이제부터는 얼마나 다양한 환경에서 요구사항에 맞는 데이터와 모델을 잘 구축하는 방법이 필요하다. 향후, 피지컬AI기술은 사용자의 정확한 요구사항 탐색, 데이터, 모델 및 출력 간 정렬을 효과적으로 얻는 노하우가 중요해 질 것이다.

레퍼런스

2026년 7월 18일 토요일

LLM 추론모델 효과와 개발 시 고려사항

최근 생성형 AI 분야의 가장 큰 화두 중 하나는 추론 모델의 등장이다. 기존 언어 모델들이 질문을 입력받자마자 즉각적으로 답변 토큰을 생성했던 것과 달리, 추론 모델들은 답변을 내놓기 전에 내부적으로 생각하는 과정을 거친다. 대표적으로 오픈AI의 o1 및 o3 시리즈, 딥시크의 R1 등이 이러한 방식을 취하고 있다. 이번 글에서는 세바스찬 라시카의 아티클을 바탕으로 언어 모델에서 추론 노력을 어떻게 정의하고 조절할 수 있는지 정리한다.


개요
추론 노력은 모델이 최종 답변을 내놓기 전에 소모하는 시간과 계산 자원을 의미한다. 기존 모델들은 단순 문장 생성에 집중했다면, 추론 모델은 내부적인 사고 체인(Chain of Thought)을 형성하여 스스로 문제를 분해하고, 검증하며, 오류를 수정하는 과정을 거친다.

추론 노력을 늘리면 수학 문제 풀이, 복잡한 코딩, 논리적 추론이 필요한 영역에서 정확도가 비약적으로 상승한다. 그러나 모든 질문에 많은 추론 노력을 들일 필요는 없다. 간단한 인삿말이나 단순 사실 관계를 묻는 질문에 수초 동안 생각 과정을 거치는 것은 자원 낭비이자 시간 지연을 초래한다. 따라서 추론 노력을 상황에 맞게 제어하는 기술이 중요해졌다.

추론 노력을 조절하는 주요 방법
언어 모델의 추론 노력을 제어하는 방식은 크게 학습 단계와 인퍼런스 단계로 나눌 수 있다.

첫째, 시스템 프롬프트를 통한 제어이다. 최근 출시되는 모델들은 시스템 프롬프트나 파라미터를 통해 사고 과정의 길이를 조절하는 기능을 제공한다. 추론 노력을 낮게 설정하면 정답만 간결하게 출력하고, 높게 설정하면 긴 사고 과정을 거쳐 복잡한 문제를 해결한다.

둘째, 생각 토큰의 길이 제한이다. 추론 모델은 내부적으로 사고용 토큰을 생성한다. 이 토큰의 최대 생성을 제한함으로써 응답 속도를 올리거나, 반대로 제한을 풀어 복잡한 문제를 깊게 고민하도록 유도할 수 있다.

셋째, 강화학습을 통한 보상 설계이다. 딥시크 R1과 같은 모델들은 강화학습 과정에서 정답 여부뿐만 아니라 추론 과정의 효율성에 대해서도 보상을 부여한다. 필요 이상으로 긴 사고 과정을 거치는 것에 감점을 주거나, 정답을 맞추는 데 필요한 최적의 추론 길이를 스스로 학습하도록 설계한다.

마무리
언어 모델의 발전 방향은 단순히 모델의 파라미터 크기를 키우는 것에서, 주어진 문제의 난이도에 맞춰 연산량을 가변적으로 투입하는 방향으로 진화하고 있다. 추론 노력 제어 기술은 모델의 응답 속도, 정확도, 그리고 운영 비용 사이에서 최적의 접점을 찾게 해주는 핵심 도구가 될 것이다.

레퍼런스

2026년 7월 8일 수요일

프로브, 컨디셔닝 채널, GRPO, DiT, dLLM 의사코드 및 학습 구조

프로브, 컨디셔닝 채널, GRPO, DiT, dLLM 각각에 대해 의사코드와 학습 데이터 구조를 함께 살펴본다.

프로브

프로브는 모델의 특정 층에서 활성화값을 뽑아내고, 그 위에 작은 분류기를 얹어서 학습시키는 구조다. 의사코드로 보면 다음과 같다.

# 1단계: 활성화값 수집
def get_activation(model, input_text, layer_idx):
    activations = {}
    def hook(module, input, output):
        activations['value'] = output.detach()
    handle = model.layers[layer_idx].register_forward_hook(hook)
    model.forward(input_text)
    handle.remove()
    return activations['value']  # shape: [hidden_dim]

# 2단계: 프로브 정의 (아주 작은 MLP 또는 선형 분류기)
class Probe(nn.Module):
    def __init__(self, hidden_dim):
        super().__init__()
        self.linear = nn.Linear(hidden_dim, 1)  # 정직/기만 이진 분류

    def forward(self, activation):
        return torch.sigmoid(self.linear(activation))

# 3단계: 프로브 학습
for batch in probe_dataset:
    activation = get_activation(model, batch.text, layer_idx=20)
    pred = probe(activation)
    loss = binary_cross_entropy(pred, batch.label)
    loss.backward()
    probe_optimizer.step()

# 4단계: 훈련 중 보상에 반영
def reward_with_probe(response, activation):
    task_reward = check_correctness(response)
    honesty_score = probe(activation)  # 0에 가까우면 기만 의심
    return task_reward - penalty_weight * (1 - honesty_score)

학습 데이터 구조는 활성화값과 정직 여부 라벨의 쌍으로 이루어진다.

{
  "example_id": "0001",
  "prompt": "이 코드가 모든 테스트를 통과하는지 확인하고 수정하라",
  "model_response": "def solve(): return hardcoded_answer",
  "activation_layer20": [0.023, -1.14, 0.87, ...],  # hidden_dim 크기 벡터
  "label": "deceptive",   # 또는 "honest"
  "ground_truth_check": "test case hardcoded, actual logic broken"
}

라벨은 사람이 직접 코드를 검토해서 실제로 문제를 풀었는지, 아니면 테스트만 통과하도록 편법을 썼는지 판단해서 붙인다. 이 라벨과 그 순간의 활성화값을 짝지어 놓은 데이터셋으로 프로브를 학습시키면, 나중에는 라벨 없이 활성화값만 보고도 기만 여부를 예측할 수 있게 된다.

컨디셔닝 채널

컨디셔닝 채널은 여러 조건 정보를 같은 크기의 텐서로 맞춘 다음, 채널 축으로 이어 붙여서 모델에 입력하는 구조다.

# 각 조건을 동일한 공간 해상도의 텐서로 인코딩
noise_latent = get_noise_latent()          # shape: [C, H, W]
text_embed = text_encoder(prompt)           # shape: [C_text] -> 브로드캐스트하여 [C_text, H, W]
ref_image_feat = image_encoder(ref_image)   # shape: [C_img, H, W]
pose_map = pose_estimator(pose_input)       # shape: [C_pose, H, W]
audio_feat = audio_encoder(audio_clip)      # shape: [C_audio] -> [C_audio, H, W]로 확장

# 채널 축으로 이어붙이기
combined_input = concat([noise_latent, text_embed, ref_image_feat, pose_map, audio_feat], dim=channel_axis)
# shape: [C_total, H, W]

# 기존 DiT 백본의 입력 채널 수만 늘려서 그대로 학습
output = diffusion_transformer(combined_input)
loss = diffusion_loss(output, target_video)

기존 모델이 입력 채널 하나(노이즈)만 받던 것을, 여러 조건 채널을 더해서 받도록 첫 번째 레이어의 입력 차원만 넓혀주면 나머지 트랜스포머 구조는 그대로 재사용할 수 있다.

학습 데이터 구조는 여러 조건이 하나의 샘플 안에 함께 묶여 있는 형태다.

{
  "sample_id": "hoivg_00042",
  "text_prompt": "한 사람이 상자를 들어 옮긴다",
  "reference_image": "person_box_ref.png",
  "pose_sequence": "pose_00042.npy",      # 프레임별 관절 좌표
  "audio_clip": "footstep_lift.wav",
  "target_video": "target_00042.mp4"       # 학습 정답이 되는 실제 영상
}

한 샘플 안에 텍스트, 참조 이미지, 포즈, 오디오, 정답 영상이 모두 짝지어져 있어야 하고, 학습 시에는 이 모든 조건을 인코딩해서 채널로 이어 붙인 다음 정답 영상과의 차이를 손실로 계산한다.

GRPO

GRPO는 같은 질문에 대해 여러 응답을 한꺼번에 샘플링하고, 그 응답들 사이의 상대적 보상 차이로 정책을 업데이트하는 구조다.

for prompt in training_prompts:
    # 1단계: 같은 프롬프트로 여러 응답 샘플링 (그룹)
    responses = [model.generate(prompt) for _ in range(group_size)]  # 예: 8개

    # 2단계: 각 응답에 보상 부여
    rewards = [reward_function(prompt, r) for r in responses]

    # 3단계: 그룹 내 평균과 표준편차로 정규화 (상대적 우열 계산)
    mean_r = mean(rewards)
    std_r = std(rewards)
    advantages = [(r - mean_r) / (std_r + eps) for r in rewards]

    # 4단계: 정책 업데이트 (상대적으로 좋은 응답의 확률은 높이고 나쁜 응답은 낮춤)
    for response, advantage in zip(responses, advantages):
        log_prob = model.log_prob(response, prompt)
        loss = -advantage * log_prob
        loss += kl_penalty(model, reference_model, prompt, response)  # 원래 모델에서 너무 벗어나지 않도록 정칙화
        loss.backward()
    optimizer.step()

별도의 가치 신경망 없이, 그룹 안에서의 평균과 표준편차만으로 각 응답이 상대적으로 얼마나 좋은지를 계산하는 것이 핵심이다.

학습 데이터 구조는 정답이 하나로 고정되어 있지 않고, 프롬프트와 그 프롬프트에 대한 평가 기준만 있으면 된다.

{
  "prompt": "최근 알츠하이머 치료제 연구 동향을 조사해 정리하라",
  "rubric": [
    {"criterion": "최근 2년 내 임상시험 결과를 포함했는가", "weight": 0.3},
    {"criterion": "상반된 연구 결과를 균형있게 다뤘는가", "weight": 0.3},
    {"criterion": "출처를 명확히 인용했는가", "weight": 0.2},
    {"criterion": "결론이 근거에 기반해 신중하게 서술되었는가", "weight": 0.2}
  ]
}

정답 텍스트가 미리 정해져 있는 것이 아니라, 응답을 채점할 루브릭만 있으면 된다. 모델이 같은 질문에 대해 여러 답변을 만들면, 이 루브릭으로 각 답변을 채점해서 상대적 점수를 매기고, 그 점수 차이를 이용해 정책을 업데이트한다. DR Tulu는 이 루브릭 자체도 훈련이 진행되면서 점점 더 정교해지도록 함께 학습시킨다는 점이 추가된 특징이다.

DiT

DiT는 디퓨전 모델, 즉 노이즈를 조금씩 걷어내면서 이미지나 영상을 만들어내는 생성 방식에서, 노이즈를 예측하는 핵심 신경망을 U-Net 대신 트랜스포머로 바꾼 구조다. 원래 디퓨전 모델은 U-Net을 많이 썼는데, U-Net은 이미지를 점점 작게 압축했다가 다시 키우는 구조라 합성곱 연산에 의존한다. DiT는 이미지를 작은 패치로 잘게 잘라서 마치 문장의 단어처럼 하나의 토큰 시퀀스로 취급하고, 그 토큰들을 트랜스포머의 셀프 어텐션으로 처리한다. 비유하자면 그림을 그릴 때 U-Net은 전체 캔버스를 계속 확대 축소하며 다듬는 화가에 가깝고, DiT는 그림을 작은 조각으로 잘라 붙인 모자이크 타일들을 서로 비교하고 조율하며 전체 그림을 완성해가는 방식에 가깝다.

DiT가 기존 U-Net 방식보다 좋은 이유는 두 가지다. 첫째, 트랜스포머는 이미지 크기나 데이터 양이 늘어날수록 성능이 꾸준히 좋아지는 확장성이 검증된 구조라서, 모델과 데이터를 키울수록 U-Net보다 더 안정적으로 품질이 좋아진다. 둘째, 토큰 시퀀스라는 형태를 쓰기 때문에 앞서 설명한 컨디셔닝 채널처럼 텍스트, 이미지, 포즈 같은 다른 종류의 조건 정보를 같은 토큰 시퀀스 안에 자연스럽게 섞어 넣기가 쉽다.

예시

앞서 다룬 Causal Forcing과 OmniShow가 모두 이 DiT 구조를 베이스 모델로 쓴다. OmniShow의 경우 영상의 각 프레임을 패치 단위로 잘라 토큰으로 만들고, 여기에 텍스트와 참조 이미지, 포즈, 오디오에서 나온 조건 토큰들을 함께 섞어서 트랜스포머에 입력한다. 노이즈가 낀 영상 토큰과 조건 토큰들이 셀프 어텐션 안에서 서로 영향을 주고받으면서, 조건에 맞는 방향으로 노이즈를 걷어내는 법을 학습한다.

의사코드

# 1단계: 이미지 또는 영상 프레임을 패치로 분할하고 토큰화
def patchify(image, patch_size=16):
    patches = split_into_patches(image, patch_size)  # 예: 256x256 -> 16x16 패치 256개
    tokens = linear_projection(patches)  # 각 패치를 하나의 벡터 토큰으로 변환
    tokens = tokens + positional_embedding
    return tokens  # shape: [num_patches, hidden_dim]

# 2단계: 노이즈 스텝 정보를 임베딩으로 만들어 조건으로 사용
def timestep_embedding(t):
    return sinusoidal_encode(t)  # 스칼라 t를 hidden_dim 크기 벡터로 변환

# 3단계: DiT 블록 (트랜스포머 블록 + 조건 주입)
class DiTBlock(nn.Module):
    def forward(self, tokens, condition_embed):
        # 조건 임베딩으로 정규화 파라미터를 조절 (adaptive layer norm)
        scale, shift, gate = condition_to_scale_shift_gate(condition_embed)
        x = adaptive_layer_norm(tokens, scale, shift)
        x = x + gate * self.self_attention(x)
        x = adaptive_layer_norm(x, scale, shift)
        x = x + gate * self.mlp(x)
        return x

# 4단계: 전체 forward, 노이즈 예측
def dit_forward(noisy_tokens, t, text_condition):
    condition_embed = timestep_embedding(t) + text_encoder(text_condition)
    x = noisy_tokens
    for block in dit_blocks:  # 예: 28개 블록
        x = block(x, condition_embed)
    predicted_noise = unpatchify(final_linear(x))
    return predicted_noise

# 5단계: 학습 루프
for batch in dataset:
    clean_tokens = patchify(batch.image)
    t = random_timestep()
    noise = sample_gaussian_noise()
    noisy_tokens = add_noise(clean_tokens, noise, t)  # 노이즈 스케줄에 따라 섞기
    predicted_noise = dit_forward(noisy_tokens, t, batch.text_prompt)
    loss = mse_loss(predicted_noise, noise)
    loss.backward()
    optimizer.step()

핵심은 이미지를 패치 토큰으로 바꾼 다음, 노이즈 스텝 정보를 트랜스포머 블록 안의 정규화 파라미터를 조절하는 방식으로 주입한다는 점이다. 이렇게 하면 같은 트랜스포머 블록이 노이즈가 많이 낀 초기 단계와 노이즈가 거의 없는 마지막 단계 모두에서 서로 다르게 동작하도록 조절된다.

학습 데이터 구조

{
  "sample_id": "video_gen_00187",
  "text_prompt": "노을이 지는 해변을 걷는 사람",
  "clean_video_frames": "target_00187.mp4",   # 노이즈가 없는 정답 영상
  "resolution": [256, 256],
  "num_frames": 16,
  "patch_size": 16
}

학습 시에는 정답 영상을 패치로 잘라 토큰으로 만든 다음, 무작위로 고른 노이즈 스텝만큼 인위적으로 노이즈를 섞고, 모델이 그 노이즈를 예측하도록 학습시킨다. 즉 데이터셋 자체에는 노이즈가 없는 깨끗한 영상과 텍스트 프롬프트만 있으면 되고, 노이즈는 학습 과정에서 그때그때 만들어서 씌운다. 조건이 여러 개인 OmniShow 같은 경우는 여기에 참조 이미지, 포즈, 오디오 항목이 앞서 설명한 컨디셔닝 채널 구조로 함께 추가된다.

dLLM

기존 LLM은 문장을 왼쪽에서 오른쪽으로 한 단어씩 순서대로 예측하는 자기회귀 방식을 쓴다. 반면 dLLM은 이미지에 노이즈를 씌웠다가 걷어내는 디퓨전의 원리를 텍스트에 그대로 적용한다. 문장의 토큰들을 무작위로 마스킹, 즉 가려버린 다음, 모델이 가려진 토큰들이 무엇이었는지 한꺼번에 맞히도록 학습시킨다. 비유하자면 기존 LLM이 문장을 왼쪽부터 한 글자씩 순서대로 받아쓰는 방식이라면, dLLM은 빈칸 뚫기 문제지를 받아서 뚫린 빈칸들을 한 번에, 그리고 여러 번 다시 고쳐가며 채워나가는 방식이다.

구조적으로 보면 dLLM은 이미지 패치 토큰 대신 텍스트 토큰을 입력으로 쓴다는 점만 다를 뿐, 트랜스포머 블록 자체는 DiT와 거의 동일하다. 다만 이미지처럼 노이즈를 연속적인 값으로 섞는 대신, 텍스트는 이산적인 토큰이기 때문에 토큰을 마스크 토큰으로 치환하는 방식으로 노이즈를 흉내낸다. 마스킹 비율이 노이즈 스텝 역할을 한다. 마스킹 비율이 높으면 노이즈가 많이 낀 초기 단계이고, 마스킹 비율이 낮으면 노이즈가 거의 걷힌 마지막 단계다.

dLLM이 기존 자기회귀 LLM보다 나은 점은, 문장을 왼쪽부터 순서대로 만들 필요가 없어서 여러 토큰을 동시에 병렬로 생성할 수 있다는 것이다. 앞서 다룬 Any-Order GPT as Masked Diffusion Model 논문에서 언급했듯이 이 병렬 생성 덕분에 추론 속도가 최대 25배까지 빨라질 수 있다. 다만 앞서 다룬 The Flexibility Trap 논문에서 지적했듯이, 어떤 순서로든 생성할 수 있다는 유연성이 오히려 모델을 추론에 중요한 어려운 토큰을 회피하게 만드는 부작용도 있다.

예시

수학 문제를 푸는 상황을 생각해보면, 기존 자기회귀 LLM은 "2 더하기 3은" 다음에 "5" 하나를 예측하고, 그다음 토큰을 예측하는 식으로 왼쪽부터 순서대로 답을 완성해간다. dLLM은 전체 답변 자리에 마스크 토큰을 전부 채워놓은 상태에서 시작해서, 처음에는 확신이 높은 몇몇 자리, 예를 들어 숫자 "5"부터 채우고, 그다음 라운드에서 나머지 마스크된 자리들을 점점 채워나가며 여러 번에 걸쳐 문장 전체를 완성해간다.

의사코드

# 1단계: 텍스트를 토큰화하고 일부를 마스크 토큰으로 치환
def mask_tokens(token_ids, mask_ratio):
    num_to_mask = int(len(token_ids) * mask_ratio)
    mask_positions = random_sample(range(len(token_ids)), num_to_mask)
    noisy_tokens = token_ids.clone()
    for pos in mask_positions:
        noisy_tokens[pos] = MASK_TOKEN_ID
    return noisy_tokens, mask_positions

# 2단계: 마스킹 비율을 노이즈 스텝처럼 사용해 조건으로 임베딩
def mask_ratio_embedding(mask_ratio):
    return sinusoidal_encode(mask_ratio)  # DiT의 timestep_embedding과 동일한 방식

# 3단계: dLLM 블록 (DiT 블록과 구조 동일, 입력만 텍스트 토큰)
class DLLMBlock(nn.Module):
    def forward(self, tokens, condition_embed):
        scale, shift, gate = condition_to_scale_shift_gate(condition_embed)
        x = adaptive_layer_norm(tokens, scale, shift)
        x = x + gate * self.self_attention(x)  # 양방향 어텐션, 인과적 마스크 없음
        x = adaptive_layer_norm(x, scale, shift)
        x = x + gate * self.mlp(x)
        return x

# 4단계: 전체 forward, 마스크된 토큰 예측
def dllm_forward(noisy_tokens, mask_ratio):
    condition_embed = mask_ratio_embedding(mask_ratio)
    x = token_embedding(noisy_tokens)
    for block in dllm_blocks:
        x = block(x, condition_embed)
    predicted_token_logits = final_linear(x)  # 각 위치마다 vocab 크기의 분포
    return predicted_token_logits

# 5단계: 학습 루프
for batch in text_dataset:
    clean_tokens = tokenize(batch.text)
    mask_ratio = random_uniform(0, 1)  # 이미지의 random_timestep과 동일한 역할
    noisy_tokens, mask_positions = mask_tokens(clean_tokens, mask_ratio)
    predicted_logits = dllm_forward(noisy_tokens, mask_ratio)
    # 마스킹된 위치에서만 손실 계산
    loss = cross_entropy(predicted_logits[mask_positions], clean_tokens[mask_positions])
    loss.backward()
    optimizer.step()

# 6단계: 생성 시 여러 라운드에 걸쳐 마스크를 점점 채워나감
def generate(prompt_tokens, answer_length, num_rounds=8):
    tokens = concat([prompt_tokens, [MASK_TOKEN_ID] * answer_length])
    for round in range(num_rounds):
        mask_ratio = 1.0 - (round / num_rounds)
        logits = dllm_forward(tokens, mask_ratio)
        probs, predicted = softmax_and_argmax(logits)
        # 확신이 높은 자리부터 확정하고 나머지는 다음 라운드로
        confident_positions = top_k_by_confidence(probs, k=answer_length // num_rounds)
        for pos in confident_positions:
            tokens[pos] = predicted[pos]
    return tokens

DiT와 비교했을 때 가장 큰 구조적 차이는 셀프 어텐션이 인과적 마스크 없이 양방향으로 열려 있다는 점이다. 기존 자기회귀 LLM은 지금 토큰이 뒤에 나올 토큰을 미리 보지 못하도록 마스킹하지만, dLLM은 마스킹된 자리 이외의 모든 토큰을 양방향으로 참고할 수 있어야 빈칸을 제대로 채울 수 있기 때문이다.

학습 데이터 구조

{
  "sample_id": "text_00512",
  "clean_text": "2 더하기 3은 5이고, 5에 4를 더하면 9이다.",
  "token_ids": [1023, 892, 55, 1104, ...],
  "vocab_size": 32000,
  "max_seq_len": 512
}

DiT의 학습 데이터가 노이즈 없는 깨끗한 영상만 있으면 되는 것처럼, dLLM의 학습 데이터도 마스킹 없는 원본 텍스트만 있으면 된다. 마스킹은 DiT에서 노이즈를 학습 중에 그때그때 씌우는 것과 마찬가지로, 학습 루프 안에서 무작위 비율로 그때그때 만들어서 적용한다. 즉 데이터셋 준비 단계에서는 기존 자기회귀 LLM과 동일한 순수 텍스트 코퍼스를 그대로 쓸 수 있고, 학습 방식만 마스킹과 병렬 예측으로 바뀌는 것이다.