이 글은 오픈소스 에이전트인 헤르메스(Hermes Agent)와 오픈 웨이트 모델(Qwen3.8 27B)을 GPU있는 컴퓨터에 설치하고, 클로드 코드(Claude Code)나 코덱스(Codex) 같은 상용 바이브 코딩 도구와 비교해 정확도 차이가 거의 없도록 최적화한 방법을 기록해 남긴다. 코드와 대화가 외부 클라우드로 나가지 않는 온프레미스(on-premise) 환경이 목표다. 보안 때문에 상용 AI 코딩 도구를 쓰기 어려운 조직에서 쓸 만하다.

우선, 비교 기준은 직접 만든 코딩 과제 9개(숨은 테스트 119개)다. 단일 파일 모듈 작성부터 7개 모듈로 된 기존 패키지 수정까지 포함했다. 같은 과제를 클로드 코드와 헤르메스에 똑같이 주고 결과를 채점했다. 최종 설정에서 헤르메스는 9개 모두 통과했고(클로드 코드도 9개 모두 통과), 시간은 48분(클로드 코드 13분)이 걸렸다. 정확도는 같고 속도는 3~4배 느린 수준이다.
헤르메스는 Nous Research에서 만든 오픈소스 에이전트로, 터미널에서 클로드 코드처럼 쓸 수도 있고 텔레그램 같은 메신저와 연결해 휴대폰에서 개발을 시킬 수도 있다. 다만 기본 설정 그대로 로컬 모델을 붙이면 9개 과제 중 1개만 통과할 정도로 성능이 낮다. 모델, 추론 엔진, 에이전트 하네스(도구 구성, 작업 절차, 검증 훅)를 단계별로 바꿔 가며 최적화한 결과를 정리한다.
설치 과정 전체는 깃허브에 하나의 마크다운 파일로 올려 두었다. 이 파일을 클로드 코드나 코덱스에 읽혀 자동 설치하는 방법부터 설명하고, 그 다음 각 단계가 무엇을 왜 하는지 설명한다.
헤르메스 바이브 코딩 환경 구성
최종 구성은 다음과 같다.
- 모델: Qwen3.8 27B NVFP4 (21.9GB) + DSpark 보조 모델 (4.0GB, 추측 디코딩용)
- 추론 엔진: vLLM 0.27.1 (포트 8000, 컨텍스트 65,536 토큰)
- 예비 엔진: Ollama qwen3.8 q4 (vLLM이 꺼지면 헤르메스가 자동 전환)
- 에이전트: Hermes Agent v0.21 이상, 코딩용 coder 프로필과 텔레그램 봇용 기본 프로필
- 입력: 텍스트, 사진(모델이 직접 인식), 음성(faster-whisper 로컬 음성 인식)
- 출력: 실시간 스트리밍 텍스트, 선택적으로 음성(MeloTTS 로컬 음성 합성)
모델, 음성 인식, 음성 합성이 모두 장비 안에서 돈다. 인터넷은 설치할 때 모델을 받는 것과 텔레그램 메시지 전달에만 쓴다.
준비사항
장비 스펙은 다음과 같다. 핵심은 GPU 메모리다.
- GPU: NVIDIA, 메모리 96GB 이상 권장 (RTX PRO 6000 Blackwell 96GB에서 검증). DGX Spark 같은 128GB 통합메모리 장비, 64GB급 장비도 설정을 낮춰 쓸 수 있다(아래 메모리 등급 참고)
- 드라이버: CUDA 13 지원 (검증 장비 595.99, CUDA 13.2)
- OS: Ubuntu 24.04 (x86_64). DGX Spark(arm64)는 vLLM 설치 방법만 다르다
- 디스크: 여유 60GB 이상 (모델 26GB, 예비 모델 17GB, 음성 모델 등)
- RAM: 64GB 이상 권장
- 기타: 인터넷(설치 시), 텔레그램 봇을 쓸 경우 텔레그램 계정
GPU 메모리에 따라 추측 디코딩용 보조 모델을 쓸 수 있는지가 갈린다. 64K 토큰 입력을 넣고 실측한 값은 다음과 같다.
| 등급 | 장비 | 보조 모델 | KV 캐시 | 최대 메모리 | 코드 생성 속도 |
|---|---|---|---|---|---|
| gpu96 | 전용 GPU 90GB 이상 | DSpark | 12GiB | 약 77GB | 약 246 tok/s |
| unified128 | 128GB 통합메모리 (DGX Spark) | DSpark | 8GiB | 약 76GB | 메모리 대역폭에 비례해 낮음 |
| mem64 | 48~110GB (80GB GPU 포함) | 없음 | 5GiB | 약 30GB | 약 58 tok/s |
| small | 48GB 미만 | vLLM 없이 Ollama만 사용 (약 22GB, 약 75 tok/s) | |||
보조 모델을 켜면 메모리를 많이 쓰는 이유가 있다. vLLM 0.27.1은 추측 디코딩을 켠 상태에서 긴 입력을 나눠 처리(chunked prefill)하면 CUDA illegal memory access로 죽는다. 그래서 64K 입력을 한 번에 처리해야 하고, 이때 계산용 메모리가 약 16GiB 더 든다. 반면 KV 캐시는 생각보다 작다. Qwen3.8은 64개 층 중 16개만 전체 어텐션을 쓰는 하이브리드 구조라 5GiB에 약 14만 토큰이 들어간다. 통합메모리 장비는 운영체제, 헤르메스, 음성 모델과 메모리를 나눠 쓰므로 KV 캐시와 동시 요청 수를 줄였다. 참고로 unified128과 mem64 값은 검증 장비에서 같은 설정으로 측정해 정한 것이다.
깃허브 설정 파일로 한 번에 설치하기
가장 쉬운 방법은 깃허브의 HERMES_SETUP.md 파일을 클로드 코드나 코덱스에 읽혀 설치를 맡기는 것이다. 이 파일 하나에 설치 순서, 단계별 확인 명령과 기대값, 필요한 스크립트 18개가 모두 들어 있다. 장비 메모리를 감지해 위 등급에 맞는 설정도 자동으로 고른다.
1) 새 장비에서 저장소를 받는다.
git clone https://github.com/mac999/hermes_vibe_dev.git
cd hermes_vibe_dev
2) 그 폴더에서 클로드 코드나 코덱스를 다음 프롬프트로 실행한다.
claude "Read HERMES_SETUP.md and set up this machine by following it section by section. Follow section 0 exactly: ask me before sudo, GPU choice or deleting anything, and never ask me for the Telegram token in chat."
codex "Read HERMES_SETUP.md and set up this machine by following it section by section. Follow section 0 exactly: ask me before sudo, GPU choice or deleting anything, and never ask me for the Telegram token in chat."
3) 에이전트가 먼저 몇 가지를 묻는다. 모델 서버에 쓸 GPU 번호, 텔레그램 봇이 작업할 폴더, 텔레그램과 음성 기능 사용 여부다. 이후 스크립트 생성, 메모리 등급 판별, vLLM 설치, 모델 다운로드(약 26GB, sha256 확인), Ollama, 헤르메스, 프로필 설정까지 순서대로 진행하고 마지막에 검증표를 채워 보고한다. sudo 명령, GPU 선택, 파일 삭제 전에는 반드시 사람에게 확인을 받도록 파일 첫 장에 규칙을 넣어 두었다.
4) 텔레그램 봇 토큰만 사람이 직접 넣는다. 토큰이 AI 대화 기록에 남지 않게 하기 위해서다. 텔레그램 @BotFather에서 봇을 만들어 토큰을 받고, @userinfobot에서 내 숫자 ID를 확인한 뒤 다음을 실행한다. 토큰을 숨긴 채 입력받아 텔레그램에 실제로 확인한 뒤 저장한다.
bash ~/hermes-coder-kit/telegram/setup-telegram.sh
파일의 각 단계는 사람이 직접 따라 해도 된다. 아래는 그 단계들이 무엇을 왜 하는지에 대한 설명이다.
단계별 설치 및 최적화 방법
1) 모델 선정. 같은 하네스로 로컬 모델 5종을 비교했다. 9개 과제의 숨은 테스트 통과율 기준이다.
- Qwen3.8 27B: 100% (3회 반복 모두 9개 통과)
- Laguna XS 2.1 33B-A3B: 98%
- Qwen3.5 122B-A10B: 96%
- Qwen3 Coder Next 80B-A3B: 94%
- Qwen3.6 35B-A3B: 91%
파라미터를 일부만 쓰는 MoE 모델이 빠르지만 요구사항을 놓치는 경우가 많았다. 생각(thinking) 모드가 있는 모델이 중요했다. 생각 모드가 없는 qwen3-coder는 파일을 읽지 않고 내용을 지어낸 사례가 있었다.
2) 추론 엔진을 vLLM으로 바꾼다. 처음에는 Ollama를 썼는데, 시간의 93~98%가 모델 응답 대기였다. 헤르메스는 도구를 호출할 때마다 대화 전체를 다시 보내기 때문에 입력 처리(prefill) 속도가 체감 속도를 좌우한다.
- Ollama q4 + MTP: 입력 554 tok/s, 생성 75 tok/s, 9개 과제 89.5분
- vLLM NVFP4 + MTP: 입력 7,695 tok/s, 코드 생성 152 tok/s, 58.5분
- vLLM NVFP4 + DSpark 보조 모델: 입력 7,304 tok/s, 코드 생성 246 tok/s, 48.0분
NVFP4는 블랙웰 GPU가 하드웨어로 계산하는 4비트 형식이라 정확도 손실 없이 입력 처리가 14배 빨라졌다. DSpark는 본 모델 대신 다음 토큰들을 미리 써 보는 5층짜리 작은 모델이다. 본 모델이 검사해 맞는 것만 받아들이므로 결과는 같고 속도만 오른다. 코드처럼 형태가 정해진 출력에서 효과가 크다.
3) 헤르메스 coder 프로필을 튜닝한다. 정확도를 1/9에서 9/9로 올린 것은 대부분 이 단계다.
- 도구를 terminal, file, todo 3개만 남긴다. 기본으로 켜진 웹, 브라우저, 이미지, 음성 등 도구 정의가 매 요청 약 14K 토큰을 차지했다
- 메모리를 끈다. 이전 세션 메모가 다음 작업을 엉뚱한 폴더로 끌고 가는 사례가 있었다
- 작업 절차(SOUL.md)를 7단계로 바꾼다. 탐색, 계획, 테스트 먼저, 최소 구현, 검증, 요구사항 재확인, 짧은 보고 순이다. "도구로 읽지 않은 파일 내용은 말하지 말 것", "직접 실행해 본 결과만 보고할 것"이 핵심이다
- 테스트 확인 훅을 건다. 코드를 고친 턴이 끝나기 전에 pytest, node --test를 자동 실행하고, 실패하면 계속 일하게 한다
- 패키지 설치 승인 훅을 건다. 금지했는데도 패키지를 설치하려 한 모델이 있었다
- 작업 폴더를 실행한 위치로 둔다. 클로드 코드처럼 프로젝트 폴더에서 hermes -p coder chat으로 실행한다
- 생각 강도를 xhigh로 고정한다. Qwen3.8 템플릿은 low, medium, xhigh만 받고 헤르메스 기본값 high를 HTTP 400으로 거부한다
4) 예비 서버를 둔다. vLLM이 꺼져 있으면 헤르메스가 경고 한 줄을 띄우고 Ollama qwen3.8로 넘어가 답한다. 재부팅 뒤 vLLM을 아직 안 띄웠어도 봇은 동작한다.
5) 텔레그램 봇을 연결한다. 기본 프로필에 coder와 같은 설정을 입히고, 텔레그램에는 현재 폴더 개념이 없으므로 작업 폴더만 고정한다. 이렇게 하면 휴대폰에서 "계산기 앱 만들어줘"라고 보내면 장비에서 개발, 테스트, 서버 실행까지 진행하고 결과를 알려준다.
6) 사진, 음성, 실시간 출력을 켠다.
- 사진: Qwen3.8은 이미지를 직접 이해하지만, 헤르메스는 로컬 서버 모델의 비전 지원을 모른다. supports_vision과 image_input_mode native를 설정해야 모델이 원본 이미지를 본다. 화면 캡처를 보내며 "겹치는 UI 고쳐줘"라고 할 수 있다
- 음성 인식: faster-whisper large-v3-turbo를 별도 환경에 설치해 연결했다. 10초 한국어 음성이 약 8초에 정확히 변환됐다
- 음성 답장: 헤르메스 기본 TTS는 답변 글을 외부 서버로 보낸다. 그래서 로컬 MeloTTS 한국어 모델을 CPU로 돌렸다. /voice on으로 켠다
- 실시간 출력: 헤르메스는 기본값으로 답을 다 만든 뒤에 한 번에 보낸다. streaming.enabled를 켜면 텔레그램에 글이 써지는 모습이 그대로 보인다
성능 비교 결과
| 구성 | 완전 해결 | 숨은 테스트 통과율 | 시간 |
|---|---|---|---|
| 클로드 코드 (클라우드) | 9/9 | 100% | 13분 |
| 헤르메스 기본 설정 + qwen3-coder 30B | 1/9 | 56% | - |
| 헤르메스 튜닝 + Qwen3.8 27B (Ollama) | 9/9 | 100% | 89.5분 |
| 헤르메스 튜닝 + Qwen3.8 27B NVFP4 (vLLM + DSpark) | 9/9 | 100% | 48.0분 |
정리하면, 요구사항이 명확한 중소 규모 개발에서는 클로드 코드와 결과물 정확도가 같았다. 차이는 세 가지다. 속도가 3~4배 느리다. 도구 호출이 약 5배 많다(9개 과제 약 320회 대 63회). 화면 결과물을 스스로 확인하는 능력이 약하다. 공개 벤치마크로 보면 Qwen3.8 27B는 클로드 Opus 4.6급에 근접한다는 업체 발표가 있다. 체감으로는 1년쯤 전 상용 도구 수준이다. 수천 줄 이상의 대형 코드베이스, 몇 시간짜리 장기 작업, 모호한 요구사항은 측정하지 않았으므로 그런 작업에서는 차이가 더 날 수 있다.
그럼에도 이 방식을 쓰는 이유
속도는 상용 도구보다 느리다. 그래도 이 방식을 쓸 이유는 충분하다.
- 코드가 밖으로 나가지 않는다. 소스 코드, 로그, 고객 데이터, 화면 캡처, 음성까지 모두 내 GPU 안에서 처리된다. 국방, 금융, 의료, 공공, 기밀 유지 계약이 걸린 프로젝트에서는 AI 코딩 도구를 쓸 수 있느냐 없느냐를 가르는 차이다
- 인터넷이 끊긴 망에서도 쓴다. 처음 모델을 받은 뒤에는 텔레그램 메시지 전달을 빼면 모두 오프라인으로 돈다. 모델 파일과 저장소를 반입해 폐쇄망에 설치할 수 있다
- 사용량 제한과 과금이 없다. 토큰당 요금, 호출 제한, 주간 한도가 없다. 밤새 긴 작업을 돌리거나 실험을 마음껏 반복하거나 팀이 GPU 서버 하나를 같이 써도 된다. 비용은 이미 가진 장비와 전기료뿐이다
- 측정한 과제에서는 결과가 같았다. 클로드 코드가 푼 과제를 모두 풀었다. 차이는 정확도가 아니라 속도이고, 속도는 장비와 보조 모델이 좋아지면 따라 오른다
- 내가 통제한다. 모델 버전이 고정되어 있어 어느 날 갑자기 동작이 바뀌지 않는다. 프롬프트, 도구, 훅, 정책이 모두 파일이라 감사하고 고칠 수 있다. 업체 장애, 정책 변경, 가격 인상에 작업이 멈추지 않는다
- 더 좋은 모델로 바로 갈아탈 수 있다. 오픈 웨이트 모델은 최첨단을 대략 6개월에서 1년 간격으로 따라왔고 그 간격은 줄고 있다. 모델만 바꾸고 벤치마크를 다시 돌리면 된다
- 어디서든 개발을 시킨다. 텔레그램으로 휴대폰에서 글, 사진, 음성으로 일을 맡기고 자리를 비운 사이에 결과를 받는다
결국 보안, 비용, 통제가 속도보다 중요한 곳에서 쓸 도구다. 가장 어렵고 크고 모호한 작업은 여전히 상용 클라우드 에이전트가 빠르다. 그래서 둘을 상황에 따라 나눠 쓰는 것이 현실적이다.
텔레그램으로 바이브 코딩한 결과
다음 두 앱은 휴대폰 텔레그램으로만 요청해 헤르메스가 로컬 모델로 개발한 것이다. 첫 번째는 공학용 계산기이며, 사용한 프롬프트는 다음과 같다.
좋아. 그럼 웹뷰 기반 공학용 계산기 개발해. 다크모드 지원. 영어 ux기반. 함수 그래프 출력 지원.
헤르메스는 할 일 목록으로 계획을 세웠다. 이어 계산 엔진 테스트(pytest 5개, node 11개)를 먼저 쓰고 Flask 앱을 만들어 검증했다. 모델 호출 29번, 약 10분이 걸렸다. 다만 첫 버전은 테스트를 모두 통과했는데도 키패드에 + 버튼이 없었다. 테스트가 계산 엔진만 보고 화면 구성은 보지 않았기 때문이다. 후속 요청 한 번으로 고쳤다.
더하기 버튼 추가후 개선. 재실행
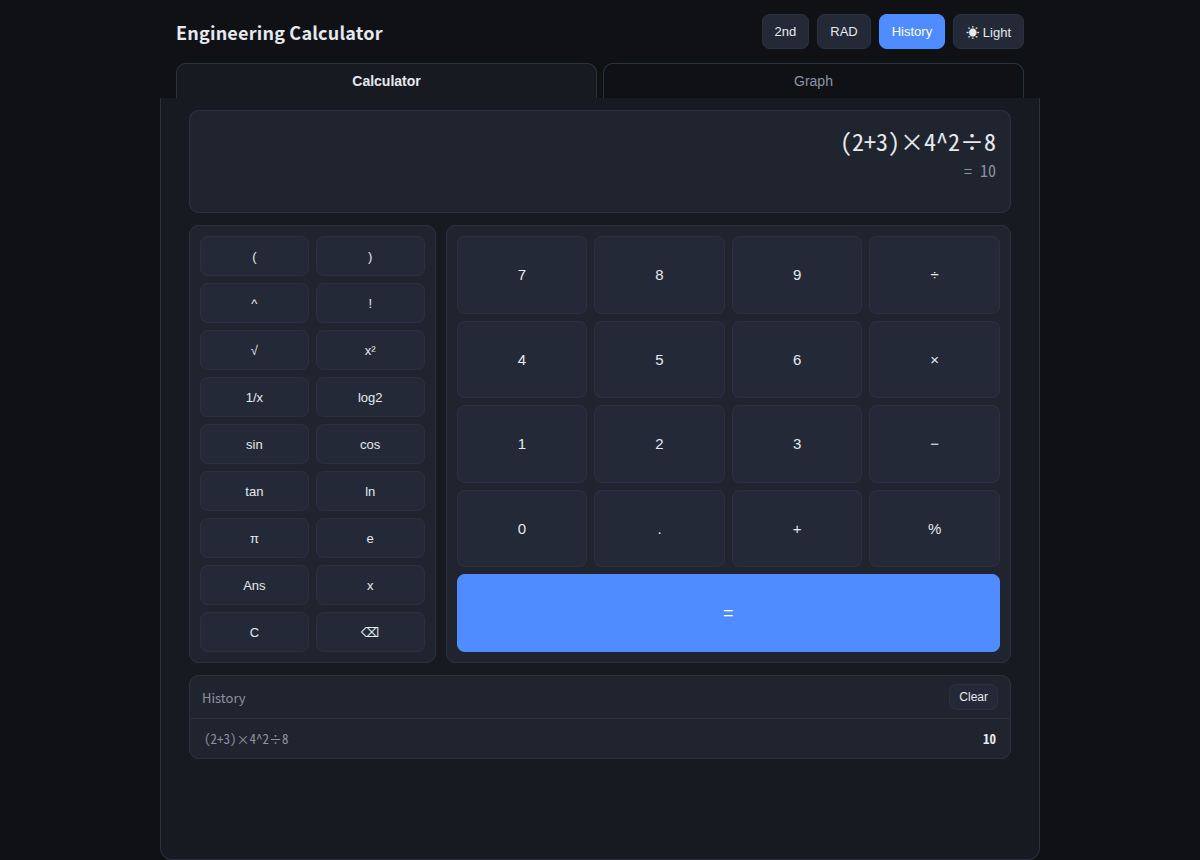
공학용 계산기 (다크 모드, 2nd, RAD/DEG, Ans, 히스토리)
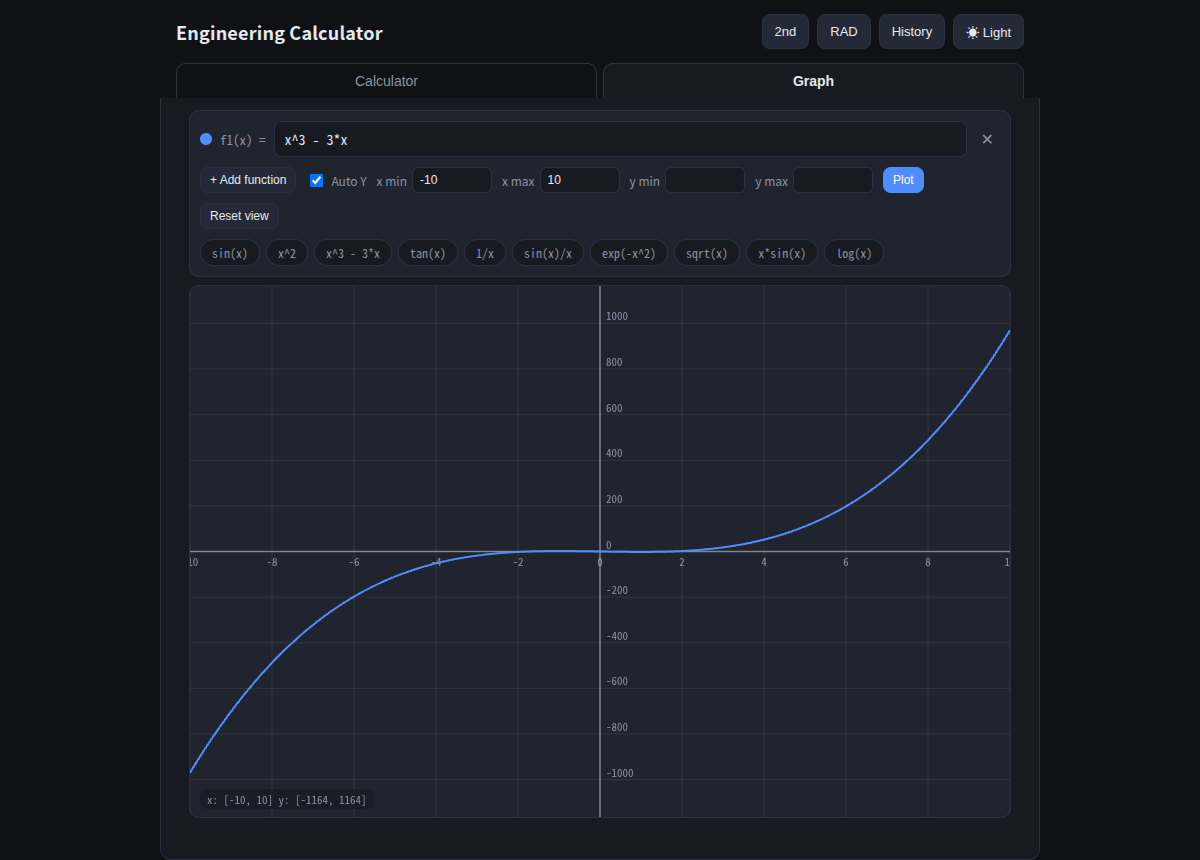
함수 그래프 탭 (x^3 - 3x, 프리셋 함수, 자동 Y축)
두 번째는 항성계 여행 시뮬레이터(Stellar Drift)다. 프롬프트는 두 번 보냈다.
이제 우수 항성계를 여행하는 시뮬레이터 개발. 파이썬 플라스크 기반 웹뷰 앱. 다크모드. 영문. 성운. 거대 항성. 아름다운 성운과 화려한 이팩트. 잔잔한 우주선 음향. 테스트 후 링크줘.
3d 일인칭 시점 뷰. 아이폰에서도 실행 가능하게 적절히 뷰 처리.
헤르메스는 작업을 다음과 같이 나눴다.
- 순수 로직(spacecore.js, 노드 테스트 포함)
- 캔버스 렌더러(별, 성운, 거대 항성, 행성, 파티클)
- Web Audio로 만든 우주선 배경음
- 아이폰용 가상 조이스틱과 WARP 버튼
그 다음 헤드리스 크롬에서 데스크톱과 아이폰 화면을 각각 확인했다.
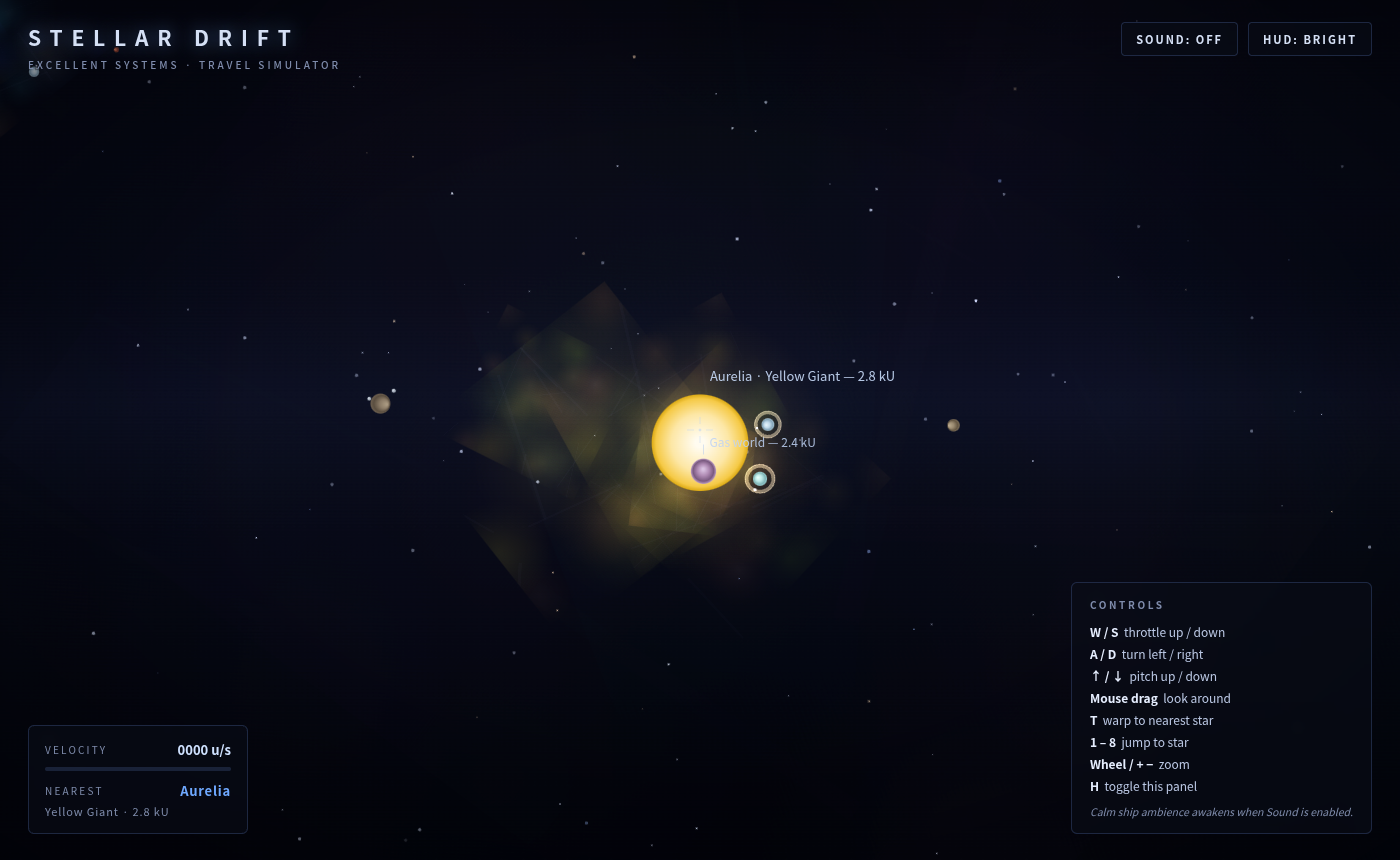
Stellar Drift 데스크톱 화면 (성운과 황색 거성 Aurelia)
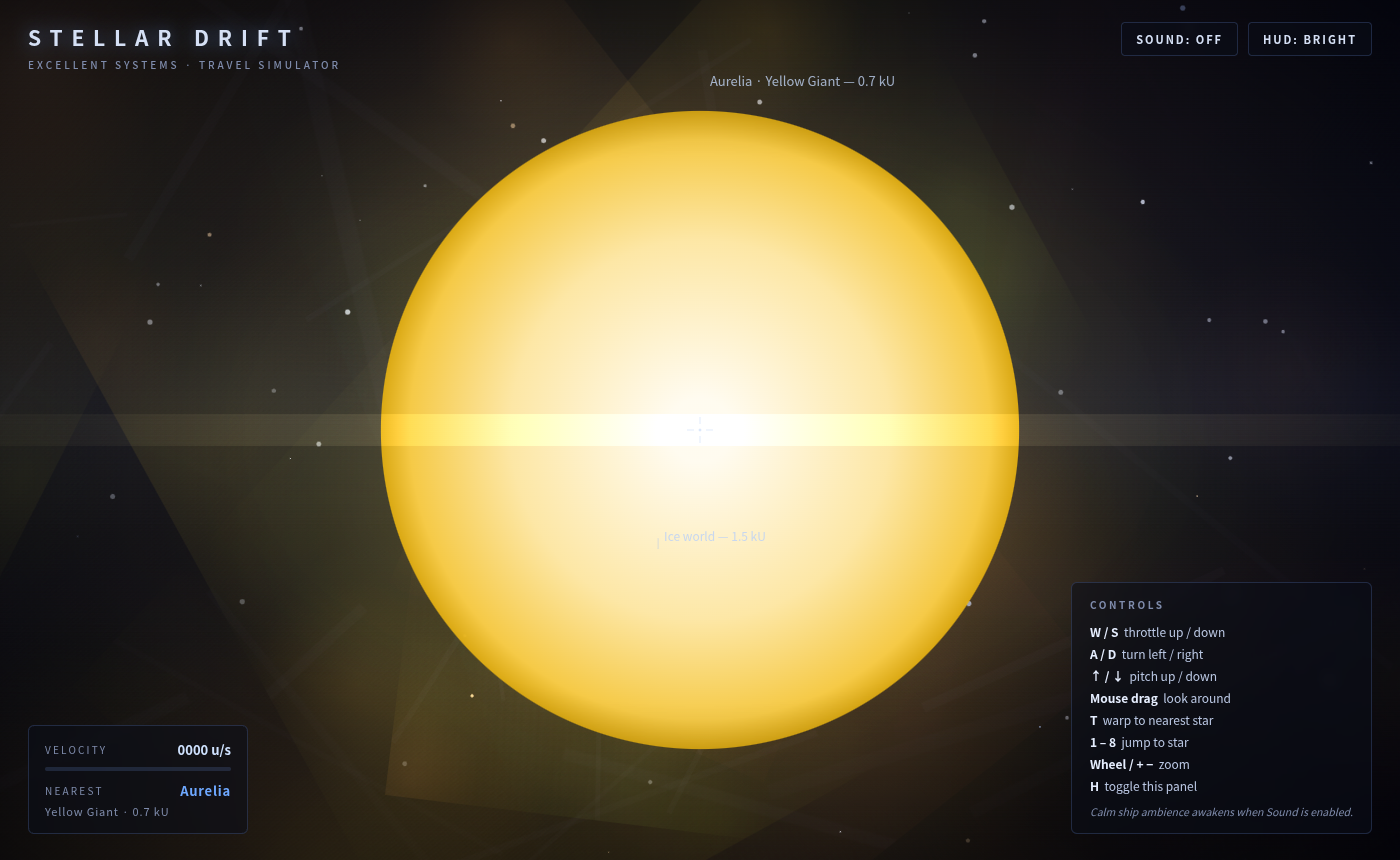
워프 후 거성에 도착한 화면
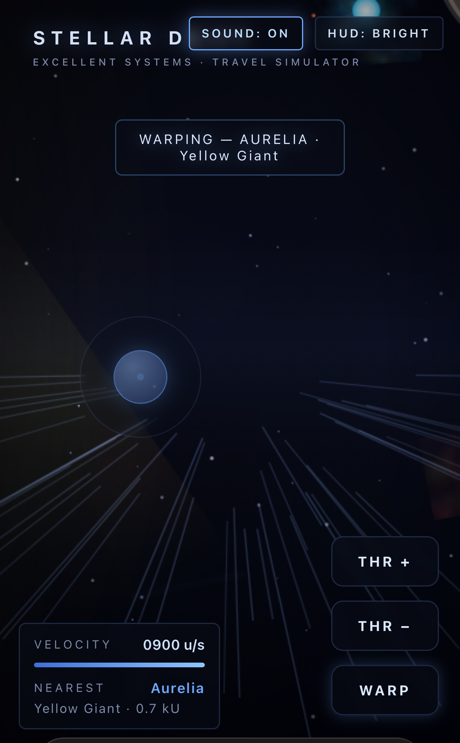
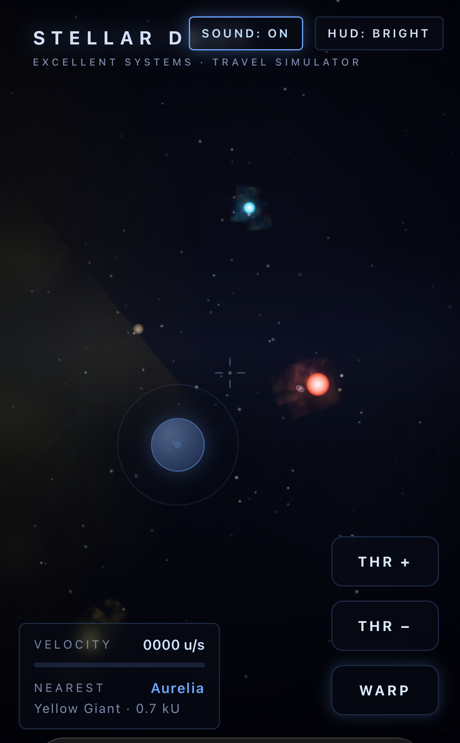
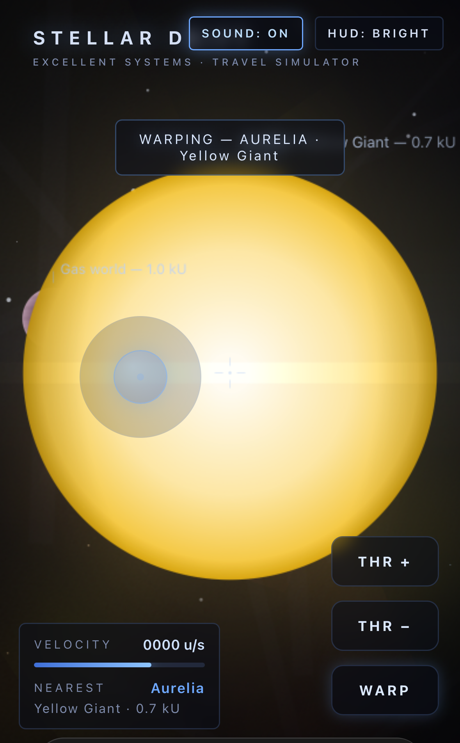
아이폰 실행 화면 (워프 중, 순항, 도착)
보다시피 꽤 그럴듯하게 동작한다. 다만 아이폰 화면에서 제목이 SOUND 버튼에 가려지고, 도착 후에도 WARPING 배너가 남는 문제가 보인다. 로컬 모델의 약점이 그대로 드러나는 부분이다. 이 화면을 캡처해 텔레그램으로 보내며 고쳐 달라고 하면 모델이 이미지를 직접 보고 문제를 찾는다. 시험해 보니 세 가지 문제를 정확히 짚었다.
개발 중 만난 문제들
- vLLM이 CUDA illegal memory access로 죽음: 추측 디코딩과 입력 분할 처리가 충돌. max-num-batched-tokens를 컨텍스트 길이와 같게 해 해결
- HTTP 400 Unexpected reasoning effort high: Qwen3.8 템플릿이 high를 거부. 모델별 생각 강도를 xhigh로 지정해 해결
- Ollama가 헤르메스의 컨텍스트 설정을 무시하고 26만 토큰으로 올라감: 컨텍스트를 고정한 파생 모델을 만들어 해결
- 허깅페이스 다운로드가 초당 2MB: aria2c 16개 연결로 받아 초당 45~50MB로 해결
- 텔레그램 사진을 모델이 직접 못 봄: 별도 사진 설명용 모델 설정이 우선 적용되고 있었음. image_input_mode를 native로 고정해 해결
- 음성 인식 오류(metadata_errors): PyAV 19와 faster-whisper 충돌. av를 16으로 고정해 해결
- MeloTTS 설치 오류: setuptools 70 미만 고정, unidic 사전 다운로드로 해결
- 텔레그램 답이 한 번에 옴: 헤르메스 스트리밍 기본값이 꺼져 있었음. streaming.enabled로 해결
- pkill -f로 프로세스를 끄다가 자기 셸까지 종료: 패턴이 셸 명령줄과 겹침. PID로 종료하도록 변경
마무리
이 글에서는 헤르메스와 오픈 웨이트 모델로 클로드 코드급 정확도의 로컬 바이브 코딩 환경을 만드는 방법을 정리했다. 성능을 좌우한 것은 모델 크기보다 세 가지였다. 생각 모드가 있는 모델 선택, 입력 처리가 빠른 추론 엔진, 그리고 도구를 줄이고 테스트로 검증하게 만든 하네스다. 깃허브의 HERMES_SETUP.md를 쓰면 새 장비에서도 클로드 코드나 코덱스에 맡겨 같은 환경을 재현할 수 있다.
다만 속도는 여전히 상용 도구보다 3~4배 느리고, 화면 결과물처럼 테스트로 잡기 어려운 부분은 사람이 확인해야 한다. 요구사항을 명확히 쓰고 핵심 합격 기준을 정하는 일, 결과를 검수하는 일은 여전히 사람이 챙겨야 할 몫이다. 그래도 코드가 밖으로 나가지 않는다는 점에서, 보안이 중요한 조직이라면 지금 수준으로도 충분히 쓸 만하다.
부록: 공개된 유사 구성과 비교
글을 정리한 뒤 Qwen 27B급 모델을 단일 GPU에서 돌려 헤르메스나 코딩 에이전트에 붙인 공개 사례를 찾아 비교했다. 수치는 각 글의 측정값이라 측정 조건이 서로 다르다. 대략의 위치를 보는 용도로만 참고하길 바란다.
| 구성 | 생성 속도 | 입력 처리 | 컨텍스트 | 장점 | 단점 |
|---|---|---|---|---|---|
| 이 글: vLLM + NVFP4 + DSpark (RTX PRO 6000) | 코드 246 tok/s | 약 7,300 tok/s | 64K | 원본 모델 사용. 클로드 코드와 같은 과제로 정확도 검증. 설치 파일 하나로 재현 | 추측 디코딩 사용 시 입력을 나눠 처리하지 못해 메모리 16GiB 추가, 컨텍스트 64K로 제한 |
| SGLang + DFlash 2 (RTX PRO 6000) | 에이전트 30K 기준 220 tok/s, 코드 320 tok/s | 11,000~12,000 tok/s | 262K, 동시 8개 | 입력 처리가 약 1.6배 빠름. 추측 디코딩을 켠 채 8K씩 나눠 처리. 긴 컨텍스트 | 검열 해제 모델과 자체 양자화 사용. SGLang 패치 6개 필요. 구조화 출력 요청은 400 오류 |
| vLLM + MTP (RTX PRO 6000) | 114 tok/s | 미공개 | 262K | 모델 내장 MTP만 써서 설정이 간단 | 생성 속도가 절반 수준 |
| vLLM + MTP 2 (DGX Spark / RTX 6000) | 미공개 | 미공개 | 1M (YaRN) | 초장문 컨텍스트, KV 용량 실측 | 속도 측정 없음. 짧은 입력에서 품질이 약간 떨어질 수 있음 |
| vLLM + GPTQ 4bit + 헤르메스 (24GB RTX 3090) | 30~45 tok/s | 미공개 | 131K | 24GB 보급형 GPU로 가능. 운영 노하우(요청 1개씩, 긴 타임아웃)가 실용적 | MTP를 켜면 메모리 부족과 오류로 끄고 사용. 느림 |
정리하면 다음과 같다.
- 생성 속도와 정확도 검증 면에서는 이 글의 구성이 공개 사례 중 앞선 편이다. 다른 글들은 대부분 속도나 연결 방법만 다루고, 상용 도구와 같은 과제로 정확도를 비교한 사례는 찾지 못했다.
- 입력 처리 속도와 컨텍스트 길이는 SGLang + DFlash 2 구성이 낫다. 헤르메스는 도구 호출마다 대화 전체를 다시 보내므로 입력 처리 속도가 전체 작업 시간에 크게 영향을 준다. 원본 모델로 이 조합을 검증하는 것이 다음 개선 후보다.
- vLLM이 추측 디코딩과 분할 입력 처리를 함께 지원하도록 고쳐지면, 같은 메모리로 더 긴 컨텍스트를 쓸 수 있다.
- 공통된 운영 교훈도 있다. 요청을 한 번에 하나씩 보내고, 타임아웃을 길게 잡고, 프롬프트 앞부분을 고정해 접두 캐시를 살리고, 로컬 모델에게 최종 검수까지 맡기지 않는 것이다.
레퍼런스
- hermes_vibe_dev: 설정 파일, 벤치마크, 결과 (GitHub)
- Hermes Agent 문서: 로컬 모델
- nvidia/Qwen3.8-27B-NVFP4
- RedHatAI/Qwen3.8-27B-speculator.dspark
- vLLM on the DGX Spark
- Qwen3.8 27B on DGX Spark (kubesimplify)
- faster-whisper
- MeloTTS
- NVIDIA: Run Hermes Agent with a Local LLM (DGX Spark 플레이북)
- Hermes Agent 문서: LLM and Model Providers
- Qwen3.8-27B + SGLang + DFlash 2 on RTX PRO 6000 (GitHub)
- Qwen3.8 27B for DGX Spark / RTX 6000 PRO, vLLM 설정 (GitHub)
- Qwen3.6-27B + vLLM + Hermes on 24GB VRAM (DEV Community)
- Building a Reliable Local Coding Agent with Qwen 3.6, OpenCode, Hermes, and Codex (Substack)
- Run Qwen3.8-27B Locally: VRAM and Speed Tested (ComputingForGeeks)
- RTX 6000 Pro Wiki: PCIe GPU에서 대형 LLM 운영 (GitHub)

댓글 없음:
댓글 쓰기