레이블이 머신러닝인 게시물을 표시합니다. 모든 게시물 표시

2026년 7월 8일 수요일

프로브, 컨디셔닝 채널, GRPO, DiT, dLLM 의사코드 및 학습 구조

프로브, 컨디셔닝 채널, GRPO, DiT, dLLM 각각에 대해 의사코드와 학습 데이터 구조를 함께 살펴본다.

프로브

프로브는 모델의 특정 층에서 활성화값을 뽑아내고, 그 위에 작은 분류기를 얹어서 학습시키는 구조다. 의사코드로 보면 다음과 같다.

# 1단계: 활성화값 수집
def get_activation(model, input_text, layer_idx):
    activations = {}
    def hook(module, input, output):
        activations['value'] = output.detach()
    handle = model.layers[layer_idx].register_forward_hook(hook)
    model.forward(input_text)
    handle.remove()
    return activations['value']  # shape: [hidden_dim]

# 2단계: 프로브 정의 (아주 작은 MLP 또는 선형 분류기)
class Probe(nn.Module):
    def __init__(self, hidden_dim):
        super().__init__()
        self.linear = nn.Linear(hidden_dim, 1)  # 정직/기만 이진 분류

    def forward(self, activation):
        return torch.sigmoid(self.linear(activation))

# 3단계: 프로브 학습
for batch in probe_dataset:
    activation = get_activation(model, batch.text, layer_idx=20)
    pred = probe(activation)
    loss = binary_cross_entropy(pred, batch.label)
    loss.backward()
    probe_optimizer.step()

# 4단계: 훈련 중 보상에 반영
def reward_with_probe(response, activation):
    task_reward = check_correctness(response)
    honesty_score = probe(activation)  # 0에 가까우면 기만 의심
    return task_reward - penalty_weight * (1 - honesty_score)

학습 데이터 구조는 활성화값과 정직 여부 라벨의 쌍으로 이루어진다.

{
  "example_id": "0001",
  "prompt": "이 코드가 모든 테스트를 통과하는지 확인하고 수정하라",
  "model_response": "def solve(): return hardcoded_answer",
  "activation_layer20": [0.023, -1.14, 0.87, ...],  # hidden_dim 크기 벡터
  "label": "deceptive",   # 또는 "honest"
  "ground_truth_check": "test case hardcoded, actual logic broken"
}

라벨은 사람이 직접 코드를 검토해서 실제로 문제를 풀었는지, 아니면 테스트만 통과하도록 편법을 썼는지 판단해서 붙인다. 이 라벨과 그 순간의 활성화값을 짝지어 놓은 데이터셋으로 프로브를 학습시키면, 나중에는 라벨 없이 활성화값만 보고도 기만 여부를 예측할 수 있게 된다.

컨디셔닝 채널

컨디셔닝 채널은 여러 조건 정보를 같은 크기의 텐서로 맞춘 다음, 채널 축으로 이어 붙여서 모델에 입력하는 구조다.

# 각 조건을 동일한 공간 해상도의 텐서로 인코딩
noise_latent = get_noise_latent()          # shape: [C, H, W]
text_embed = text_encoder(prompt)           # shape: [C_text] -> 브로드캐스트하여 [C_text, H, W]
ref_image_feat = image_encoder(ref_image)   # shape: [C_img, H, W]
pose_map = pose_estimator(pose_input)       # shape: [C_pose, H, W]
audio_feat = audio_encoder(audio_clip)      # shape: [C_audio] -> [C_audio, H, W]로 확장

# 채널 축으로 이어붙이기
combined_input = concat([noise_latent, text_embed, ref_image_feat, pose_map, audio_feat], dim=channel_axis)
# shape: [C_total, H, W]

# 기존 DiT 백본의 입력 채널 수만 늘려서 그대로 학습
output = diffusion_transformer(combined_input)
loss = diffusion_loss(output, target_video)

기존 모델이 입력 채널 하나(노이즈)만 받던 것을, 여러 조건 채널을 더해서 받도록 첫 번째 레이어의 입력 차원만 넓혀주면 나머지 트랜스포머 구조는 그대로 재사용할 수 있다.

학습 데이터 구조는 여러 조건이 하나의 샘플 안에 함께 묶여 있는 형태다.

{
  "sample_id": "hoivg_00042",
  "text_prompt": "한 사람이 상자를 들어 옮긴다",
  "reference_image": "person_box_ref.png",
  "pose_sequence": "pose_00042.npy",      # 프레임별 관절 좌표
  "audio_clip": "footstep_lift.wav",
  "target_video": "target_00042.mp4"       # 학습 정답이 되는 실제 영상
}

한 샘플 안에 텍스트, 참조 이미지, 포즈, 오디오, 정답 영상이 모두 짝지어져 있어야 하고, 학습 시에는 이 모든 조건을 인코딩해서 채널로 이어 붙인 다음 정답 영상과의 차이를 손실로 계산한다.

GRPO

GRPO는 같은 질문에 대해 여러 응답을 한꺼번에 샘플링하고, 그 응답들 사이의 상대적 보상 차이로 정책을 업데이트하는 구조다.

for prompt in training_prompts:
    # 1단계: 같은 프롬프트로 여러 응답 샘플링 (그룹)
    responses = [model.generate(prompt) for _ in range(group_size)]  # 예: 8개

    # 2단계: 각 응답에 보상 부여
    rewards = [reward_function(prompt, r) for r in responses]

    # 3단계: 그룹 내 평균과 표준편차로 정규화 (상대적 우열 계산)
    mean_r = mean(rewards)
    std_r = std(rewards)
    advantages = [(r - mean_r) / (std_r + eps) for r in rewards]

    # 4단계: 정책 업데이트 (상대적으로 좋은 응답의 확률은 높이고 나쁜 응답은 낮춤)
    for response, advantage in zip(responses, advantages):
        log_prob = model.log_prob(response, prompt)
        loss = -advantage * log_prob
        loss += kl_penalty(model, reference_model, prompt, response)  # 원래 모델에서 너무 벗어나지 않도록 정칙화
        loss.backward()
    optimizer.step()

별도의 가치 신경망 없이, 그룹 안에서의 평균과 표준편차만으로 각 응답이 상대적으로 얼마나 좋은지를 계산하는 것이 핵심이다.

학습 데이터 구조는 정답이 하나로 고정되어 있지 않고, 프롬프트와 그 프롬프트에 대한 평가 기준만 있으면 된다.

{
  "prompt": "최근 알츠하이머 치료제 연구 동향을 조사해 정리하라",
  "rubric": [
    {"criterion": "최근 2년 내 임상시험 결과를 포함했는가", "weight": 0.3},
    {"criterion": "상반된 연구 결과를 균형있게 다뤘는가", "weight": 0.3},
    {"criterion": "출처를 명확히 인용했는가", "weight": 0.2},
    {"criterion": "결론이 근거에 기반해 신중하게 서술되었는가", "weight": 0.2}
  ]
}

정답 텍스트가 미리 정해져 있는 것이 아니라, 응답을 채점할 루브릭만 있으면 된다. 모델이 같은 질문에 대해 여러 답변을 만들면, 이 루브릭으로 각 답변을 채점해서 상대적 점수를 매기고, 그 점수 차이를 이용해 정책을 업데이트한다. DR Tulu는 이 루브릭 자체도 훈련이 진행되면서 점점 더 정교해지도록 함께 학습시킨다는 점이 추가된 특징이다.

DiT

DiT는 디퓨전 모델, 즉 노이즈를 조금씩 걷어내면서 이미지나 영상을 만들어내는 생성 방식에서, 노이즈를 예측하는 핵심 신경망을 U-Net 대신 트랜스포머로 바꾼 구조다. 원래 디퓨전 모델은 U-Net을 많이 썼는데, U-Net은 이미지를 점점 작게 압축했다가 다시 키우는 구조라 합성곱 연산에 의존한다. DiT는 이미지를 작은 패치로 잘게 잘라서 마치 문장의 단어처럼 하나의 토큰 시퀀스로 취급하고, 그 토큰들을 트랜스포머의 셀프 어텐션으로 처리한다. 비유하자면 그림을 그릴 때 U-Net은 전체 캔버스를 계속 확대 축소하며 다듬는 화가에 가깝고, DiT는 그림을 작은 조각으로 잘라 붙인 모자이크 타일들을 서로 비교하고 조율하며 전체 그림을 완성해가는 방식에 가깝다.

DiT가 기존 U-Net 방식보다 좋은 이유는 두 가지다. 첫째, 트랜스포머는 이미지 크기나 데이터 양이 늘어날수록 성능이 꾸준히 좋아지는 확장성이 검증된 구조라서, 모델과 데이터를 키울수록 U-Net보다 더 안정적으로 품질이 좋아진다. 둘째, 토큰 시퀀스라는 형태를 쓰기 때문에 앞서 설명한 컨디셔닝 채널처럼 텍스트, 이미지, 포즈 같은 다른 종류의 조건 정보를 같은 토큰 시퀀스 안에 자연스럽게 섞어 넣기가 쉽다.

예시

앞서 다룬 Causal Forcing과 OmniShow가 모두 이 DiT 구조를 베이스 모델로 쓴다. OmniShow의 경우 영상의 각 프레임을 패치 단위로 잘라 토큰으로 만들고, 여기에 텍스트와 참조 이미지, 포즈, 오디오에서 나온 조건 토큰들을 함께 섞어서 트랜스포머에 입력한다. 노이즈가 낀 영상 토큰과 조건 토큰들이 셀프 어텐션 안에서 서로 영향을 주고받으면서, 조건에 맞는 방향으로 노이즈를 걷어내는 법을 학습한다.

의사코드

# 1단계: 이미지 또는 영상 프레임을 패치로 분할하고 토큰화
def patchify(image, patch_size=16):
    patches = split_into_patches(image, patch_size)  # 예: 256x256 -> 16x16 패치 256개
    tokens = linear_projection(patches)  # 각 패치를 하나의 벡터 토큰으로 변환
    tokens = tokens + positional_embedding
    return tokens  # shape: [num_patches, hidden_dim]

# 2단계: 노이즈 스텝 정보를 임베딩으로 만들어 조건으로 사용
def timestep_embedding(t):
    return sinusoidal_encode(t)  # 스칼라 t를 hidden_dim 크기 벡터로 변환

# 3단계: DiT 블록 (트랜스포머 블록 + 조건 주입)
class DiTBlock(nn.Module):
    def forward(self, tokens, condition_embed):
        # 조건 임베딩으로 정규화 파라미터를 조절 (adaptive layer norm)
        scale, shift, gate = condition_to_scale_shift_gate(condition_embed)
        x = adaptive_layer_norm(tokens, scale, shift)
        x = x + gate * self.self_attention(x)
        x = adaptive_layer_norm(x, scale, shift)
        x = x + gate * self.mlp(x)
        return x

# 4단계: 전체 forward, 노이즈 예측
def dit_forward(noisy_tokens, t, text_condition):
    condition_embed = timestep_embedding(t) + text_encoder(text_condition)
    x = noisy_tokens
    for block in dit_blocks:  # 예: 28개 블록
        x = block(x, condition_embed)
    predicted_noise = unpatchify(final_linear(x))
    return predicted_noise

# 5단계: 학습 루프
for batch in dataset:
    clean_tokens = patchify(batch.image)
    t = random_timestep()
    noise = sample_gaussian_noise()
    noisy_tokens = add_noise(clean_tokens, noise, t)  # 노이즈 스케줄에 따라 섞기
    predicted_noise = dit_forward(noisy_tokens, t, batch.text_prompt)
    loss = mse_loss(predicted_noise, noise)
    loss.backward()
    optimizer.step()

핵심은 이미지를 패치 토큰으로 바꾼 다음, 노이즈 스텝 정보를 트랜스포머 블록 안의 정규화 파라미터를 조절하는 방식으로 주입한다는 점이다. 이렇게 하면 같은 트랜스포머 블록이 노이즈가 많이 낀 초기 단계와 노이즈가 거의 없는 마지막 단계 모두에서 서로 다르게 동작하도록 조절된다.

학습 데이터 구조

{
  "sample_id": "video_gen_00187",
  "text_prompt": "노을이 지는 해변을 걷는 사람",
  "clean_video_frames": "target_00187.mp4",   # 노이즈가 없는 정답 영상
  "resolution": [256, 256],
  "num_frames": 16,
  "patch_size": 16
}

학습 시에는 정답 영상을 패치로 잘라 토큰으로 만든 다음, 무작위로 고른 노이즈 스텝만큼 인위적으로 노이즈를 섞고, 모델이 그 노이즈를 예측하도록 학습시킨다. 즉 데이터셋 자체에는 노이즈가 없는 깨끗한 영상과 텍스트 프롬프트만 있으면 되고, 노이즈는 학습 과정에서 그때그때 만들어서 씌운다. 조건이 여러 개인 OmniShow 같은 경우는 여기에 참조 이미지, 포즈, 오디오 항목이 앞서 설명한 컨디셔닝 채널 구조로 함께 추가된다.

dLLM

기존 LLM은 문장을 왼쪽에서 오른쪽으로 한 단어씩 순서대로 예측하는 자기회귀 방식을 쓴다. 반면 dLLM은 이미지에 노이즈를 씌웠다가 걷어내는 디퓨전의 원리를 텍스트에 그대로 적용한다. 문장의 토큰들을 무작위로 마스킹, 즉 가려버린 다음, 모델이 가려진 토큰들이 무엇이었는지 한꺼번에 맞히도록 학습시킨다. 비유하자면 기존 LLM이 문장을 왼쪽부터 한 글자씩 순서대로 받아쓰는 방식이라면, dLLM은 빈칸 뚫기 문제지를 받아서 뚫린 빈칸들을 한 번에, 그리고 여러 번 다시 고쳐가며 채워나가는 방식이다.

구조적으로 보면 dLLM은 이미지 패치 토큰 대신 텍스트 토큰을 입력으로 쓴다는 점만 다를 뿐, 트랜스포머 블록 자체는 DiT와 거의 동일하다. 다만 이미지처럼 노이즈를 연속적인 값으로 섞는 대신, 텍스트는 이산적인 토큰이기 때문에 토큰을 마스크 토큰으로 치환하는 방식으로 노이즈를 흉내낸다. 마스킹 비율이 노이즈 스텝 역할을 한다. 마스킹 비율이 높으면 노이즈가 많이 낀 초기 단계이고, 마스킹 비율이 낮으면 노이즈가 거의 걷힌 마지막 단계다.

dLLM이 기존 자기회귀 LLM보다 나은 점은, 문장을 왼쪽부터 순서대로 만들 필요가 없어서 여러 토큰을 동시에 병렬로 생성할 수 있다는 것이다. 앞서 다룬 Any-Order GPT as Masked Diffusion Model 논문에서 언급했듯이 이 병렬 생성 덕분에 추론 속도가 최대 25배까지 빨라질 수 있다. 다만 앞서 다룬 The Flexibility Trap 논문에서 지적했듯이, 어떤 순서로든 생성할 수 있다는 유연성이 오히려 모델을 추론에 중요한 어려운 토큰을 회피하게 만드는 부작용도 있다.

예시

수학 문제를 푸는 상황을 생각해보면, 기존 자기회귀 LLM은 "2 더하기 3은" 다음에 "5" 하나를 예측하고, 그다음 토큰을 예측하는 식으로 왼쪽부터 순서대로 답을 완성해간다. dLLM은 전체 답변 자리에 마스크 토큰을 전부 채워놓은 상태에서 시작해서, 처음에는 확신이 높은 몇몇 자리, 예를 들어 숫자 "5"부터 채우고, 그다음 라운드에서 나머지 마스크된 자리들을 점점 채워나가며 여러 번에 걸쳐 문장 전체를 완성해간다.

의사코드

# 1단계: 텍스트를 토큰화하고 일부를 마스크 토큰으로 치환
def mask_tokens(token_ids, mask_ratio):
    num_to_mask = int(len(token_ids) * mask_ratio)
    mask_positions = random_sample(range(len(token_ids)), num_to_mask)
    noisy_tokens = token_ids.clone()
    for pos in mask_positions:
        noisy_tokens[pos] = MASK_TOKEN_ID
    return noisy_tokens, mask_positions

# 2단계: 마스킹 비율을 노이즈 스텝처럼 사용해 조건으로 임베딩
def mask_ratio_embedding(mask_ratio):
    return sinusoidal_encode(mask_ratio)  # DiT의 timestep_embedding과 동일한 방식

# 3단계: dLLM 블록 (DiT 블록과 구조 동일, 입력만 텍스트 토큰)
class DLLMBlock(nn.Module):
    def forward(self, tokens, condition_embed):
        scale, shift, gate = condition_to_scale_shift_gate(condition_embed)
        x = adaptive_layer_norm(tokens, scale, shift)
        x = x + gate * self.self_attention(x)  # 양방향 어텐션, 인과적 마스크 없음
        x = adaptive_layer_norm(x, scale, shift)
        x = x + gate * self.mlp(x)
        return x

# 4단계: 전체 forward, 마스크된 토큰 예측
def dllm_forward(noisy_tokens, mask_ratio):
    condition_embed = mask_ratio_embedding(mask_ratio)
    x = token_embedding(noisy_tokens)
    for block in dllm_blocks:
        x = block(x, condition_embed)
    predicted_token_logits = final_linear(x)  # 각 위치마다 vocab 크기의 분포
    return predicted_token_logits

# 5단계: 학습 루프
for batch in text_dataset:
    clean_tokens = tokenize(batch.text)
    mask_ratio = random_uniform(0, 1)  # 이미지의 random_timestep과 동일한 역할
    noisy_tokens, mask_positions = mask_tokens(clean_tokens, mask_ratio)
    predicted_logits = dllm_forward(noisy_tokens, mask_ratio)
    # 마스킹된 위치에서만 손실 계산
    loss = cross_entropy(predicted_logits[mask_positions], clean_tokens[mask_positions])
    loss.backward()
    optimizer.step()

# 6단계: 생성 시 여러 라운드에 걸쳐 마스크를 점점 채워나감
def generate(prompt_tokens, answer_length, num_rounds=8):
    tokens = concat([prompt_tokens, [MASK_TOKEN_ID] * answer_length])
    for round in range(num_rounds):
        mask_ratio = 1.0 - (round / num_rounds)
        logits = dllm_forward(tokens, mask_ratio)
        probs, predicted = softmax_and_argmax(logits)
        # 확신이 높은 자리부터 확정하고 나머지는 다음 라운드로
        confident_positions = top_k_by_confidence(probs, k=answer_length // num_rounds)
        for pos in confident_positions:
            tokens[pos] = predicted[pos]
    return tokens

DiT와 비교했을 때 가장 큰 구조적 차이는 셀프 어텐션이 인과적 마스크 없이 양방향으로 열려 있다는 점이다. 기존 자기회귀 LLM은 지금 토큰이 뒤에 나올 토큰을 미리 보지 못하도록 마스킹하지만, dLLM은 마스킹된 자리 이외의 모든 토큰을 양방향으로 참고할 수 있어야 빈칸을 제대로 채울 수 있기 때문이다.

학습 데이터 구조

{
  "sample_id": "text_00512",
  "clean_text": "2 더하기 3은 5이고, 5에 4를 더하면 9이다.",
  "token_ids": [1023, 892, 55, 1104, ...],
  "vocab_size": 32000,
  "max_seq_len": 512
}

DiT의 학습 데이터가 노이즈 없는 깨끗한 영상만 있으면 되는 것처럼, dLLM의 학습 데이터도 마스킹 없는 원본 텍스트만 있으면 된다. 마스킹은 DiT에서 노이즈를 학습 중에 그때그때 씌우는 것과 마찬가지로, 학습 루프 안에서 무작위 비율로 그때그때 만들어서 적용한다. 즉 데이터셋 준비 단계에서는 기존 자기회귀 LLM과 동일한 순수 텍스트 코퍼스를 그대로 쓸 수 있고, 학습 방식만 마스킹과 병렬 예측으로 바뀌는 것이다.


ICML 2026 주요 연구 논문 기술, 실용성 및 수준 분석

이 글은 ICML(International Conference on Machine Learning) 2026 주요 논문을 간략히 기술 분석하고, 연구 수준 및 실용성을 정리해 나눔한다.

ICML 2026은 2026년 7월 6일부터 11일까지 서울 코엑스에서 열리는 국제머신러닝학회다. 올해는 23918건이 제출되어 6352편이 채택되었고, 채택률은 26.6%였다. 그런데 학회에서 발표되었다고 해서 모든 논문이 실제로 재현 가능한 것은 아니다. 

최근 연구에 따르면 ICML, NeurIPS, ICLR 세 학회의 평균 코드 공개율은 19.5퍼센트에 불과하다. 이번 글에서는 GitHub 저장소가 실제로 공개되어 있고, 실용적으로 가능한 경우만 추려서, 별도의 프로젝트 웹사이트까지 함께 공개된 논문들만 확인해 보았다(개인적으론 아무리 대단한 연구라 주장해도 코드와 모델을 직접 보고 실행하거나 응용해볼 수 없다면 ICML 조상 컨퍼런스에 발표되었다고 해도 무의미하다 생각한다).

각 논문은 연구목적과 사용 알고리즘, 베이스 모델을 하나의 문단으로 서술했고, 나머지 정보인 데이터셋, 연구 기술 수준, 구현 수준, 관련 링크는 목록 형태로 정리했다.

프로젝트 페이지와 GitHub를 모두 공개한 논문

Causal Forcing, 실시간 대화형 비디오 생성

이 논문은 양방향 확산모델을 소수 스텝의 자기회귀 학생 모델로 증류할 때 발생하는 이론적 결함을 규명하는 연구다. 기존 방법들이 프레임 단위 단사성 조건을 위반한다는 점을 이론적으로 증명하고, 이를 해결하기 위해 자기회귀 교사 모델 기반의 ODE 초기화와 분포 매칭 증류를 결합한 Causal Forcing을 제안했다. 후속 연구인 Causal Forcing플러스플러스에서는 ODE 대신 인과적 일관성 증류 방식을 도입했다. 베이스 모델로는 Wan2.1과 훈위안비디오의 HY1.5-TI2V-8B 비디오 확산 모델을 사용했다.

  • 사용 데이터셋: 대형 비디오 확산모델 사전학습 데이터 기반 자체 증류용 데이터
  • 연구 기술 수준: 최상급. 생성모델 이론 증명과 대규모 비디오 디퓨전 증류가 결합되어 있다
  • 구현 수준: 중간이다. 공개된 8B급 체크포인트로 추론 데모는 GPU 한 대로 바로 실행할 수 있지만, 증류 학습 자체를 재현하려면 대규모 인프라가 필요하다
  • 프로젝트 페이지: thu-ml.github.io/CausalForcing.github.io
  • GitHub: github.com/thu-ml/Causal-Forcing

Hibiki-Zero, 정렬 데이터 없는 동시 음성통역

이 논문은 단어 단위 정렬 데이터 없이도 실시간 다국어 동시 음성통역을 가능하게 하는 모델을 다룬 연구다. 프랑스어, 스페인어, 포르투갈어, 독일어에서 영어로의 통역을 대상으로, 먼저 문장 단위로 정렬된 데이터로 지도학습을 진행한 뒤 GRPO 기반 강화학습으로 통역 지연시간을 최적화하는 방식을 사용했다. 베이스 모델은 모시와 히비키 계열의 멀티스트림 디코더이며 파라미터 수는 3B다.

  • 사용 데이터셋: 자체 공개한 15시간 분량의 다국어 벤치마크
  • 연구 기술 수준: 최상급. 음성 파운데이션 모델을 처음부터 학습해야 한다
  • 구현 수준: 쉬움이다. 명령어 한 줄로 8기가에서 12기가 VRAM급 GPU에서 즉시 실시간 데모를 구동할 수 있다. 웹 UI로 감싸는 정도의 응용은 매우 용이하다
  • 프로젝트 페이지: hibiki-zero-s2st.github.io
  • GitHub: github.com/kyutai-labs/hibiki-zero

DR Tulu, 심층 리서치 에이전트

이 논문은 정답이 명확하지 않은 장문 심층 리서치 과제, 예를 들어 과학이나 의료 분야 질의에 대해 정책 모델과 함께 진화하는 루브릭으로 강화학습을 진행하는 최초의 완전 오픈 모델을 다룬 연구다. 핵심 알고리즘은 진화하는 루브릭을 활용한 강화학습이라는 뜻의 RLER이며, 멀티 롤아웃과 도구 증강 생성을 지원하는 GRPO 변형을 사용한다. 베이스 모델은 Qwen3-8B-Base다.

  • 사용 데이터셋: 과학, 의료, 일반 도메인의 장문 리서치 벤치마크 네 종류와 서치아레나, 오픈스칼라 데이터
  • 연구 기술 수준: 상급. 다만 모델과 데이터, 학습 코드, 평가 하네스까지 전부 오픈소스로 공개되어 있다
  • 구현 수준: 쉬움. 허깅페이스에서 체크포인트를 내려받은 뒤 vLLM 서버 두 대와 MCP 서버를 구동하는 것만으로 즉시 데모를 실행할 수 있다
  • 프로젝트 및 블로그 페이지: allenai.org/blog/dr-tulu
  • GitHub: github.com/rlresearch/dr-tulu
  • 모델 페이지: huggingface.co/rl-research/DR-Tulu-8B

The Obfuscation Atlas, RLVR 기만 및 정직성 탐지 연구

이 논문은 검증가능보상 강화학습, 즉 RLVR로 훈련할 때 모델이 화이트박스 거짓말 탐지기를 회피하는 현상을 실증적, 이론적으로 규명한 연구다. 리워드 해킹이 자연스럽게 발생하는 실제 코딩 환경을 구성하고, GRPO와 활성화 기반 기만 탐지 프로브를 결합해 정직한 정책과 은폐된 정책을 구분하는 분류체계를 제시했다. 베이스 모델로는 젬마3-12B-IT를 비롯한 네 개 모델을 사용했다.

  • 사용 데이터셋: 테스트 케이스 하드코딩 시나리오가 포함된 실제 코딩 문제, 그리고 500개 이상 학습된 모델 체크포인트를 허깅페이스에 공개했다
  • 연구 기술 수준: 상급. 정렬 연구와 메커니즘 해석, 강화학습 인프라가 결합되어 있다
  • 구현 수준: 중간. 코드가 설정, 학습, 탐지기 모듈로 나뉘어 있어 소규모 모델로 프로브 학습과 평가 파이프라인을 재현해볼 수 있다
  • 연구기관 페이지: far.ai/research/the-obfuscation-atlas-mapping-where-honesty-emerges-in-rlvr-with-deception-probes
  • GitHub: github.com/AlignmentResearch/obfuscation-atlas

GitHub 저장소가 상세히 공개된 논문

OmniAgent, 능동 비디오 지각 옴니모달 에이전트

이 논문은 긴 비디오나 여러 모달리티를 이해할 때 전체 영상을 다 보는 대신 필요한 프레임만 능동적으로 탐색하는 에이전트를 다룬다. 72B 모델보다 73퍼센트 적은 프레임으로도 더 나은 성능을 보였다. 비디오 이해 문제를 부분관측 마르코프 결정과정으로 정식화하고, 턴 단위 불확실성을 반영한 TAURA라는 강화학습 기법으로 정책을 학습한다. 베이스 모델은 Qwen2.5-Omni-7B다.

  • 사용 데이터셋: 비디오엠엠이, LV벤치를 포함한 열 개 벤치마크
  • 연구 기술 수준: 상급. 비디오 에이전트를 위한 강화학습 설계가 핵심이다
  • 구현 수준: 중간. 코드와 짐 형태의 능동지각 환경, 강화학습 및 지도학습 체크포인트가 모두 공개되어 있어 7B급 모델 기준으로 로컬 파인튜닝을 시도해볼 수 있다
  • GitHub: github.com/HarryHsing/OmniAgent

OmniShow, 인간과 사물 상호작용을 통합한 비디오 생성

바이트댄스가 발표한 이 논문은 텍스트, 참조 이미지, 오디오, 포즈 조건을 하나의 모델로 통합한 최초의 인간과 사물 상호작용 비디오 생성 올인원 모델을 제안한다. 채널 단위로 조건들을 통합해 주입하는 방식을 사용했으며, 베이스 모델은 Wan 기반의 DiT 비디오 확산 모델이다.

  • 사용 데이터셋: 자체 구축한 HOIVG벤치
  • 연구 기술 수준: 최상급. 대규모 비디오 확산 모델 학습이 필요한 산업 연구다
  • 구현 수준: 중간. 추론 코드와 체크포인트가 공개되어 데모 실행은 가능하지만 요구되는 GPU 자원이 크다
  • GitHub: github.com/Correr-Zhou/OmniShow

RLAnything과 AutoTool, 에이전틱 강화학습 오픈소스 레시피

젠버스 연구팀이 공개한 이 두 논문은 에이전틱 강화학습을 데이터, 알고리즘, 추론 모드라는 세 축으로 체계적으로 분석한 연구다. 실제 엔드투엔드 궤적 기반의 지도학습과 강화학습을 결합하고, 리워드 클리핑과 엔트로피 유지 기법을 적용해 소형 모델이 대형 모델을 능가하는 학습 레시피를 완성했다. 베이스 모델은 Qwen2.5-7B와 Qwen3-4B이며, 4B 규모의 DemyAgent 체크포인트를 공개했다.

  • 사용 데이터셋: AIME 2024와 2025, GPQA다이아몬드, LiveCodeBench-v6
  • 연구 기술 수준: 상급. 에이전틱 강화학습 파이프라인을 다룬다
  • 구현 수준: 쉬움. DemyAgent-4B 체크포인트가 허깅페이스에 공개되어 있어 로컬 평가와 소규모 파인튜닝을 바로 시도할 수 있다
  • GitHub: github.com/Gen-Verse/Open-AgentRL

S2L-PO, 작은 모델이 GRPO에서 정책 다양성을 더 잘 탐색한다

이 논문은 LLM 추론용 강화학습인 GRPO에서 오히려 작은 모델이 정책 수준의 다양성 탐색에 유리하다는 점을 규명하고, 이를 활용하는 학습 기법을 제안한 연구다. Qwen3 계열 모델을 소형과 대형으로 나누어 비교 실험을 진행했다.

  • 사용 데이터셋: 수학 추론 벤치마크
  • 연구 기술 수준: 상급. RL 알고리즘에 대한 실증 연구다
  • 구현 수준: 쉬움. 소형 모델 기준으로 GRPO 코드를 일부 수정하는 수준이라 재현이 비교적 간단하다
  • GitHub: github.com/qishisuren123/S2L-PO

NT-SSM, 그래프 협업 필터링의 대조학습 재고

이 논문은 그래프 기반 추천시스템, 즉 협업 필터링에서 대조학습의 한계를 지적하고 간단한 대안을 제시한 연구다. 기존 표준 모델인 LightGCN을 베이스 모델로 삼아 새로운 정규화 기반 대안 기법을 적용했다.

  • 사용 데이터셋: 아마존, 옐프 등으로 추정되는 표준 추천시스템 벤치마크
  • 연구 기술 수준: 중상급. 그래프 신경망 기반 추천시스템을 다룬다
  • 구현 수준: LightGCN 기반의 비교적 경량 모델이라 로컬 실험 재현이 용이하다
  • GitHub: github.com/geon0325/NT-SSM

해마 내후각피질 영감 세계모델

이 논문은 뇌의 해마와 내후각피질 구조에서 영감을 받아 구조적 추상화와 일반화가 가능한 세계모델을 설계한 연구다. 계산신경과학 기반의 구조학습 알고리즘을 사용했으며, 사전학습된 파운데이션 모델을 쓰지 않고 커스텀 순환신경망 기반 인지 모델을 처음부터 구성했다.

  • 사용 데이터셋: 인지과학 실험용 합성 환경
  • 연구 기술 수준: 난이도 높은 수준. 계산신경과학과 세계모델이 결합되어 있다
  • 구현 수준: 중간. 주피터 노트북으로 공개되어 있어 소규모 실험을 재현하고 수정해보기가 비교적 수월하다
  • GitHub: github.com/senngadaisuki/hpc-mec-worldmodel

CaDRe, 기후 분석을 위한 인과 구조 학습

이 논문은 은닉 동적 과정을 고려한 일반적인 인과 구조 학습 기법을 기후 데이터 분석에 적용한 연구다. 비선형 독립성분분석 기반의 인과 표현 학습과 인과 발견 알고리즘을 사용하며, 사전학습 모델 없이 커스텀 인과표현학습 신경망을 사용한다.

  • 사용 데이터셋: 기후과학 시계열 데이터
  • 연구 기술 수준: 높은 수준. 인과추론과 시계열 분석이 결합되어 있다
  • 구현 수준: 중간. 공개된 코드로 자체 시계열 데이터에 적용해볼 수 있지만 인과추론 이론에 대한 이해가 선행되어야 한다
  • GitHub: github.com/MinghaoFu/CaDRe

LatentTSF, 관측에서 상태로 이어지는 잠재 시계열 예측

이 논문은 원시 관측치가 아니라 잠재 상태 공간에서 시계열을 예측하는 프레임워크를 다룬다. 잠재공간 상태추정과 시계열 예측을 결합한 방식이며, 파이토치 기반의 커스텀 상태공간모델을 베이스로 사용한다.

  • 사용 데이터셋: 표준 시계열 예측 벤치마크
  • 연구 기술 수준: 중상급이다. 
  • 구현 수준: 파이토치 공식 구현체가 공개되어 있어 자체 데이터를 적용하기가 비교적 쉽다
  • GitHub: github.com/Muyiiiii/LatentTSF

FiSeR, 크로스 도메인 AI 이미지 탐지를 위한 세밀한 출처 표현

이 논문은 디퓨전이나 GAN 등 서로 다른 생성모델이 만든 AI 이미지를 도메인이 달라도 탐지할 수 있는 세밀한 출처 특징 추출 기법을 다룬다. 표준 CNN과 ViT 백본을 기반으로 한 출처 특화 표현학습 방식을 사용한다.

  • 사용 데이터셋: 다양한 생성모델 출처의 AI 이미지 벤치마크
  • 연구 기술 수준: 포렌식과 탐지 모델을 다룬다
  • 구현 수준: 이미지 분류기 수준의 모델이라 재현 난이도가 상대적으로 낮다
  • GitHub: github.com/heyongxin233/FiSeR

CoopEval, 협력 유지 메커니즘과 LLM 에이전트 벤치마킹

이 논문은 죄수의 딜레마류의 사회적 딜레마 상황에서 협력을 지속시키는 메커니즘과 LLM 에이전트의 협력 행동을 벤치마킹한 연구다. 게임이론 기반의 다중 에이전트 시뮬레이션을 사용하며, 별도의 파운데이션 모델 학습 없이 GPT와 클로드 계열 API 기반 LLM 에이전트를 그대로 활용한다.

  • 사용 데이터셋: 자체 구축한 사회적 딜레마 게임 환경
  • 연구 기술 수준: 게임이론과 LLM 에이전트가 결합되어 있다
  • 구현 수준: LLM API 호출 기반의 게임 시뮬레이션이라 AI 코딩 도구로 비교적 쉽게 재현하고 확장할 수 있다
  • GitHub: github.com/Xiao215/CoopEval

SubspacePathPruner, 추론 시점 LLM 구조적 프루닝

이 논문은 별도의 재학습 없이 추론 시점에 프로브 기반의 표현과 파라미터 결합을 활용해 LLM을 구조적으로 경량화하는 기법을 다룬다. 라마와 Qwen 등 공개된 LLM에 바로 적용할 수 있도록 설계되었다.

  • 사용 데이터셋: 표준 LLM 압축 벤치마크
  • 연구 기술 수준: 모델 압축을 다룬 수준 높은 기술
  • 구현 수준: 재학습이 필요 없는 방식이라 기존 오픈소스 LLM에 바로 적용해볼 수 있다
  • GitHub: github.com/GongZhiren/SubspacePathPruner

정리

이번에 정리한 논문들을 살펴보면 몇 가지 흐름이 보인다.

첫째, 공개 수준이다. Causal Forcing, Hibiki-Zero, DR Tulu, Obfuscation Atlas 네 편은 프로젝트 페이지와 GitHub를 모두 갖추고 있어 데모와 체크포인트까지 즉시 사용할 수 있는 최고 수준의 공개도를 보인다. 나머지 논문들은 대부분 GitHub 저장소만 공개되어 있지만 README와 체크포인트가 상세해서 실질적으로 재현이 가능한 수준이다.

둘째, 베이스 모델 관점이다. 처음부터 새로 학습한 파운데이션 모델을 다루는 연구는 Causal Forcing, Hibiki-Zero, CaDRe, 해마 내후각피질 세계모델 등이며 대체로 기술 난이도가 최상급이다. 반면 기존에 공개된 LLM이나 VLM 위에 파인튜닝, 프롬프트, 경량 어댑터를 얹는 방식의 연구, 예를 들어 DR Tulu의 Qwen3-8B, OmniAgent의 Qwen2.5-Omni-7B, RLAnything과 AutoTool의 Qwen 계열, GR-LoRA와 AREA와 HypCL의 CLIP 등은 구현 난이도가 가장 낮고 응용 확장성이 크다. 베이스 모델 없이 알고리즘이나 이론 자체가 기여인 연구, 예를 들어 린 라이브러리나 CaDRe, Learning to Emulate Chaos 같은 경우는 코드가 공개되어 있어도 이론적 배경을 먼저 이해해야 정확하게 활용할 수 있다.

셋째, 구현 수준 관점이다. 명령어 한 줄로 실행되는 Hibiki-Zero, 서버만 띄우면 되는 DR Tulu, 허깅페이스 체크포인트만 내려받으면 되는 Causal Forcing처럼 설치, 실행, 커스터마이징 흐름을 그대로 따라갈 수 있는 논문들이 실질적인 구현 후보다. LoRA 계열이나 활성화 함수 교체, 재학습이 필요 없는 프루닝 기법처럼 기존 모델에 얹는 방식의 연구도 코드 복잡도가 낮아 구현 성공률이 높다. 반대로 형식수학 증명이나 쌍곡기하학 기반 모델처럼 특수한 수학적 프레임워크를 요구하는 연구는 코드가 공개되어 있어도 정확히 재현하기가 쉽지 않다.

이 글은 2026년 7월 9일 기준으로 웹 검색을 통해 개별 확인한 GitHub 저장소와 프로젝트 페이지 링크를 바탕으로 작성했다. 저장소는 계속 업데이트되므로 실제 활용 전에 최신 링크를 다시 확인하는 것이 좋다.

레퍼런스

2026년 3월 11일 수요일

오픈클로(Openclaw) 설치 및 사용기

이 글은 Openclaw 설치 및 사용 방법을 간략히 공유한다. 오픈클로는 다양한 스킬(파일 정리, 웹 검색, 코딩, 추론 등등)을 사용 및 확장할 수 있는 AI에이전트 플랫폼으로 오픈소스 프로젝트로 시작되었다. 최근 개발자가 OpenAI팀에 합류했다. 

설치 시 주의사항
윈도우에서는 오픈클로 사용해보기 위해 여러번 시도해보았으나 잘 설치 안된다(시간낭비). 그냥 우분투, 리눅스 PC 나 애플 미니, 맥북, NVIDIA DGX 스파크에서 설치하길 바란다. 
요즘 히트하고 있는 애플 맥 미니, NVIDIA DGX 스파크

설치는 다음 링크를 참고한다.
참고로, 본인은 다음 설치 명령을 사용했다. 
curl -fsSL https://openclaw.ai/install.sh | bash

본인은 우분투에서 설치했다. 메뉴얼 따라 설치하면, 스킬 설정하는 단계가 나오는 데, 미리 openai, gemini, discord(옵션) 등 외부 api 이용해야 할 스킬들은 미리 api token을 메모했다가 이때 입력하길 바란다.
오픈클로 스킬 설정화면 예시(설치할 각 스킬들 리스트를 보여준다. OpenClaw, makeuseof)

설치 후, 다음 명령을 실행하면, 오픈클로 진단 등이 가능하다. 
openclaw doctor              # check for config issues
openclaw status               # gateway status
openclaw dashboard       # open the browser UI
openclaw configure         # 오픈클로 재설정

사용하기
모두 설치 및 설정 후 다음 명령을 터미널에 입력한다. 
openclaw dashboard

그럼, 오픈클로 데쉬보드 웹사이트를 다음 링크에서 확장할 수 있다. 
데쉬보드의 메뉴 중 채팅 선택 후 채팅창에 프롬프트를 입력해 본다. 

처음에는 에이전트와 서로 소개하는 시간을 갖는다(이름, 별명, 취미 등등). 끝나면, 파일을 정리해 달라던가 하는 등의 명령을 입력하면 된다. 스킬들을 연결했으면 해당 스킬을 사용해 명령을 수행할 것이다. 다음처럼 보다시피 파일 정리, 날씨 확인, 코딩 등 다양한 명령들을 잘 처리해 준다. 
내 컴퓨터 파일 알아서 정리해줘

코딩해줘

모니터링하기
오픈클로 이용시 지출한 토큰량, 사용 정보 등을 모니터링하는 기능도 다음과 같이 제공된다. 


스킬 기능이 잘 구현되면서 에이전트가 더욱 강력해 진 느낌이다. 오픈소스라 오픈클로를 자체 서버에서 서비스할 수 있다. 코드는 공개되어 있으니, 구현이 궁금하다면 분석해 살펴보길 바란다.

2026년 2월 24일 화요일

ViT 메커니즘 이해 및 코드 스크래치하기

이 글은 ViT 모델을 스크래치하는 방법을 정리한다.
VLM 개념도

현재 시점(2026.3)에서 최상위 오픈소스 소형 VLM 중 가성비 제일 좋은 것은 gemma-4, qwen vlm 모델이다. 단 gemma-4 는 아무리 작은 모델도 파인튜닝을 위해선는 32GB 이상 VRAM이 필요하다. 
개인 로컬 GPU 에서는 SmolVLM, nanoVLM, 팔마 등이 그나마 적절한 VRAM(16GB) 에서 동작한다.

여기서는 VLM의 기반이 되는 ViT모델을 프롬 스크래치해본다. 가장 일반적인 예제인 CIFAR10 이미지 데이터셋을 이용해 VIT를 학습해 보기로 한다. 이 예시는 적은 VRAM(8GB)이내에서 가볍게 학습 방법을 알아보기 위한 목적으로 프롬 스크래치한다. 각 단계별로 주요 부분을 다음과 같이 코딩한다. 

모델 하이퍼파라메터 설정
import os, torch
import matplotlib.pyplot as plt
import numpy as np
import torch.nn as nn
from torch.nn import functional as F
import torchvision
import torchvision.transforms as transforms

# 1. 하이퍼파라미터 설정
batch_size = 128        # 범위(32~128),
learning_rate = 1e-4    # Adam 추천값(0.001~0.0001)
epochs = 50             # 범위(10~50)
device = 'cuda' if torch.cuda.is_available() else 'cpu'

# 모델 아키텍처 사이즈  
img_size = 96
patch_size = 16
n_embd = 256        # 표현력 (n_head=8로 나눠떨어짐)
n_head = 8
num_blks = 6        
emb_dropout = blk_dropout = 0.2  
num_classes = 10    # CIFAR-10이므로 10개 클래스


데이터셋 로딩
# CIFAR-10 원본은 32x32 사이즈지만, 우리가 만든 VLM 구조(96x96)와
# 완벽하게 호환시키기 위해 Resize(96)을 적용.
# 학습 데이터에는 데이터 증강(Augmentation)을 추가하여 일반화 성능 향상
train_transform = transforms.Compose([
    # CIFAR-10(32x32)을 96x96으로 업스케일: LANCZOS 보간으로 경계(edge) 흐림 최소화
    transforms.Resize((img_size, img_size), interpolation=transforms.InterpolationMode.LANCZOS),
    transforms.RandomCrop(img_size, padding=12),     #  패딩 후 랜덤 크롭: 위치 변화에 강건
    transforms.RandomHorizontalFlip(p=0.5),          # 좌우 반전
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),  # 색상 증강
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
    transforms.RandomErasing(p=0.2, scale=(0.02, 0.2)),  # 랜덤 패치 제거: 특정 영역 과의존 방지
])

# 테스트 데이터는 증강 없이 원본 그대로 사용 (동일한 LANCZOS 보간 적용)
test_transform = transforms.Compose([
    transforms.Resize((img_size, img_size), interpolation=transforms.InterpolationMode.LANCZOS),
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])

print("데이터셋을 다운로드하고 준비합니다...")
trainset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=train_transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=batch_size, shuffle=True)

testset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=test_transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=batch_size, shuffle=False)

classes = ('plane', 'car', 'bird', 'cat', 'deer', 'dog', 'frog', 'horse', 'ship', 'truck')

# 데이터셋 샘플 몇개 저장
dataiter = iter(trainloader)
images, labels = next(dataiter)
fig, axes = plt.subplots(1, 5, figsize=(15, 3))
for i in range(5):
    img = images[i].numpy()
    img = img * 0.5 + 0.5
    img = np.transpose(img, (1, 2, 0))
    axes[i].imshow(img)
    axes[i].set_title(f"Label: {classes[labels[i]]}")
    axes[i].axis('off')
   
ouptut_fname = "./cifar10_samples.png"
plt.savefig(ouptut_fname)
plt.show()


로딩된 데이터셋 일부 예시는 다음과 같다. 

ViT 모델 구조 정의
# 이미지 패치를 임베딩
class PatchEmbeddings(nn.Module):
    def __init__(self, img_size, patch_size, hidden_dim):
        super().__init__()
        self.conv = nn.Conv2d(in_channels=3, out_channels=hidden_dim, kernel_size=patch_size, stride=patch_size)

    def forward(self, X):
        X = self.conv(X)            # shape = (B, hidden_dim, H/patch_size, W/patch_size). (128, 256, 6, 6)
        X = X.flatten(2)            # flatten(2) means flattening the last two dimensions. shape = (128, 256, 36)
        X = X.transpose(1, 2)       # shape = (128, 36, 256)
        return X

patch_emb = PatchEmbeddings(img_size, patch_size, n_embd).to(device)
print("입력 이미지 크기:", images.shape)
print("패치 임베딩 출력 크기:", patch_emb.forward(images.to(device)).shape)

ViT는 트랜스포머 구조를 그대로 활용한다. 이를 아래 ViT와 연계해 사용한다. 
class ViT(nn.Module): # 비전 트랜스포머 모델
    def __init__(self, img_size, patch_size, num_hiddens, num_heads, num_blks, emb_dropout, blk_dropout, num_classes):
        super().__init__()
        self.patch_embedding = PatchEmbeddings(img_size, patch_size, num_hiddens)   # 이미지 패치를 임베딩 벡터로 변환
        self.cls_token = nn.Parameter(torch.zeros(1, 1, num_hiddens))               # 클래스 토큰 초기화 (학습 가능한 파라미터)
        num_patches = (img_size // patch_size) ** 2
        self.pos_embedding = nn.Parameter(torch.randn(1, num_patches + 1, num_hiddens))     # 위치 임베딩 초기화 (학습 가능한 파라미터)
        self.dropout = nn.Dropout(emb_dropout)                                      
       
        self.blocks = nn.ModuleList([Block(num_hiddens, num_heads, blk_dropout, is_decoder=False) for _ in range(num_blks)]) # 트랜스포머 블록 여러 개 쌓기
        self.layer_norm = nn.LayerNorm(num_hiddens) # 최종 레이어 정규화
        self.classifier = nn.Linear(num_hiddens, num_classes) # 분류기(클래스 토큰을 최종적으로 클래스 확률로 변환)

    def forward(self, X):
        x = self.patch_embedding(X)     # shape = (B, num_patches, num_hiddens) from patch embedding. (128, 3, 96, 96) -> (128, 36, 256)
        cls_tokens = self.cls_token.expand(x.shape[0], -1, -1)  # shape = (B, 1, 256)
        x = torch.cat((cls_tokens, x), dim=1)                   # shape = (B, num_patches + 1, num_hiddens). (128, 37, 256)
        x += self.pos_embedding     # 위치 임베딩 추가. 초기값은 랜덤이지만 학습을 통해 최적화됨. (128, 37, 256)
        x = self.dropout(x)
       
      for block in self.blocks:
            x = block(x)
           
        cls_output = self.layer_norm(x[:, 0])   # 클래스 토큰의 최종 표현을 추출 (shape = (B, num_hiddens). (128, 256))
        logits = self.classifier(cls_output)    # 클래스 토큰을 최종적으로 클래스 확률로 변환 (shape = (B, num_classes). (128, 10))
        return logits  

모델 학습
print(f"1. 모델 초기화 (디바이스: {device})")
model = ViT(img_size, patch_size, n_embd, n_head, num_blks, emb_dropout, blk_dropout, num_classes).to(device)
# Adam에 weight decay 추가 (일반화 성능 향상)
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate, weight_decay=1e-4)
criterion = nn.CrossEntropyLoss()

# [개선] CosineAnnealingLR: 코사인 곡선으로 학습률 감소 → ReduceLROnPlateau 대비 안정적 수렴
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=epochs, eta_min=1e-6)

print("2. CIFAR-10 학습 시작")
best_val_loss = float('inf')
patience = 10  # [개선] 3→10: 코사인 스케줄러 환경에서 일시적 val loss 증가 허용
patience_counter = 0
for epoch in range(epochs):
    model.train()
    running_loss = 0.0
    for i, data in enumerate(trainloader, 0):
        inputs, labels = data
        inputs, labels = inputs.to(device), labels.to(device)

        optimizer.zero_grad()
        outputs = model(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        # 100 미니배치마다 로그 출력
        if i % 100 == 99:    
            print(f"[Epoch {epoch + 1}, Batch {i + 1}] Loss: {running_loss / 100:.3f}")
            running_loss = 0.0

    # validation loss 계산 (테스트 데이터 사용)
    model.eval()
    val_loss = 0.0
    with torch.no_grad():
        for val_inputs, val_labels in testloader:
            val_inputs, val_labels = val_inputs.to(device), val_labels.to(device)
            val_outputs = model(val_inputs)
            val_loss += criterion(val_outputs, val_labels).item()
    val_loss /= len(testloader)
    print(f"[Epoch {epoch + 1}] Validation Loss: {val_loss:.4f}")
   
    # CosineAnnealingLR 스케줄러 업데이트 (매 epoch 호출)
    scheduler.step()

    # early stopping
    if val_loss < best_val_loss:
        best_val_loss = val_loss
        patience_counter = 0
        # 모델 저장 (optional)
        torch.save(model.state_dict(), 'best_vit_model.pth')
    else:
        patience_counter += 1
        if patience_counter >= patience:
            print("Early stopping triggered.")
            break


학습 결과
학습된 결과는 다음과 같다. 
1. 모델 초기화 (디바이스: cuda)
2. CIFAR-10 학습 시작
[Epoch 1, Batch 100] Loss: 2.161
[Epoch 1, Batch 200] Loss: 2.026
[Epoch 1, Batch 300] Loss: 1.967
[Epoch 1] Validation Loss: 1.8028
[Epoch 2, Batch 100] Loss: 1.856
[Epoch 2, Batch 200] Loss: 1.797
[Epoch 2, Batch 300] Loss: 1.745

유사하게 정답을 맞추는 것을 확인할 수 있다. 자세한 코드 구현은 다음 링크에서 확인할 수 있다. 

VLM 파인튜닝 레퍼런스
VLM 스크래치 레퍼런스
오픈소스 라이브러리

ViT 개념 설명 레퍼런스

2025년 9월 15일 월요일

노코드 도구 flowise 사용기

AI 채팅 플로우를 만드는 데 최적화된 노코드 도구입니다. LLM, RAG, 에이전트 등 AI 관련 기능을 시각적으로 쉽게 조합할 수 있다.


AI 개발에 최적화: RAG(문서 기반 답변) 챗봇이나 AI 에이전트를 매우 쉽고 빠르게 만들 수 있다.
  • 직관적인 UI: AI 모델과 프롬프트를 연결하는 과정이 시각적이고 간단하여 입문자가 사용하기 좋다.
  • 빠른 프로토타이핑: AI 챗봇 아이디어를 몇 분 만에 테스트 가능한 프로토타입으로 만들 수 있다.
  • 제한적인 자동화 기능: 다른 앱(슬랙, 구글 시트 등)과 연동하여 복잡한 업무 자동화를 구현하는 기능은 약하다.
  • 챗봇 외 기능 부족: 사용자와 상호작용하는 챗봇이나 채팅 API 외의 다른 종류의 앱을 만들기 어렵다.
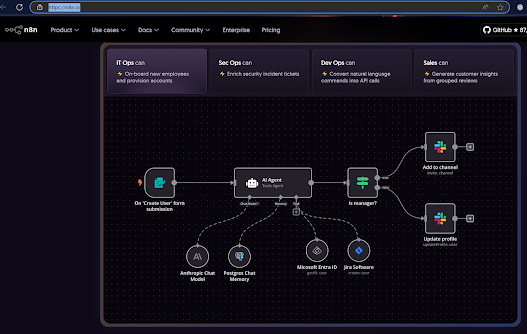
반면 n8n은 서로 다른 앱과 서비스들을 연결하여 반복적인 업무를 자동화하는 워크플로우를 만드는 데 강력하다. AI 모델을 자동화의 한 단계로 사용할 수는 있지만, Flowise처럼 RAG나 에이전트 같은 복잡한 AI 로직을 설계하기는 어렵다. 사용자 화면을 만드는 기능이 없어 순수하게 백엔드 자동화에만 집중한다.

2025년 3월 28일 금요일

인공지능 AI 에이전트 표준 프로토콜 MCP 개념, 사용, 개발 및 동작 구조 분석하기

이 글은 앤트로픽(Anthropic. 클로드 개발사)의 인공지능 AI 에이전트 표준 프로토콜 MCP(Model Context Protocol) 개념, 사용, 개발 방법 및 내부 동작 원리를 알아본다. MCP 사용 환경을 설치한 후, MCP 계산기, 날씨 조회 및 MCP 클라이언트 등을 개발하고 MCP 도구로 호출하는 과정을 직접 실습해본다. 
개념

MCP는 애플리케이션이 LLM에 컨텍스트를 제공하는 방식을 표준화한 개방형 프로토콜이다. USB-C 포트처럼, 다양한 도구와 데이터를 LLM에 연결하는 통합된 인터페이스 역할을 한다. LLM 기반 에이전트와 워크플로우 구축을 지원하며, 유연한 통합, 데이터 보호, 공급업체 간 전환성을 제공한다.  
애트로픽 MCP 소개

이 글은 주로 다음 문서를 참고하였다.
MCP 서버 리스트(MCP Servers, MCP Awesome Servers)

MCP 개념과 아키텍처 구조
MCP는 호스트-클라이언트-서버 구조로 구성되며, 로컬 및 원격 데이터를 안전하게 연결할 수 있는 아키텍처를 따른다. 호스트는 서버에서 제공해 주는 파일관리, 웹서칭, 계산 등의 도구를 연결해 LLM을 통해 추론, CoT, 도구 호출, 생성 등의 역할을 담당한다.   
MCP 서버-클라이언트 구조

각 구성요소의 역할은 다음과 같다.
  • MCP 호스트는 MCP 프로토콜을 통해 서비스에 액세스할 수 있는 애플리케이션이다. Claude 데스크톱 앱, AI 에이전트/CLI, 커서 IDE 등이 이에 해당하며, LLM(로컬 또는 원격)을 활용하여 다양한 작업을 수행한다.  
  • MCP 클라이언트는 MCP 서버와 연결하기 위해 호스트 애플리케이션과 통합된 클라이언트이다.  
  • MCP 서버는 MCP 프로토콜을 통해 특정 기능을 노출하는 응용 프로그램 또는 프로그램이다. 서버는 Docker 컨테이너, JVM, Node.js(UV/UVX) 프로세스에서 실행될 수 있으며, MCP 커뮤니티에서 제공하는 사전 구축된 서버를 활용할 수도 있다.  
  • 로컬 데이터 소스는 로컬 시스템에 존재하는 데이터베이스 또는 파일 시스템이다.  
  • 원격 서비스는 웹 API를 통해 액세스할 수 있는 GitHub, Brave Search와 같은 외부 리소스이다.
MCP를 이용하면, 서버, 클랑이언트, 로컬에 있는 파일, 폴더, 앱에 접근해 이를 LLM(Large Language Model)으로 컨트롤할 수 있다. 

MCP 구조를 구성하는 호스트와 서버는 다음과 같은 도구들을 통해 구성해 활용한다.
MCP는 전형적인 호스트-서버 프로토콜(TCP/IP와 유사)을 따른다. 서버의 실행 모드는  SSE(server sent event)와 stdio(표준입출력) 모드가 있다. SSE는 네트웍으로 연결해 도구를 호출할 수 잇도록 한다. stdio는 로컬 자체에서 도구를 호출할 수 있도록 한다.
MCP 프로토콜 명령 전송 개념

도구 호출 및 정보 교환 프로토콜은 JSON-RPC 포맷을 따르며, 예를 들어 도구 호출 시 다음과 같이 호스트-서버 간 정보를 주고 받는다. 
# 호출
{
  "jsonrpc": "2.0",
  "id": "call-1",
  "method": "callTool",
  "params": {
    "name": "create_record",
    "arguments": {
      "title": "New record",
      "content": "Record content"
    }
  }
}

# 응답
{
  "jsonrpc": "2.0",
  "id": "call-1",
  "result": {
    "content": [
      {
        "type": "text",
        "text": "Created New Record"
      }
    ]
  }
}

MCP 사용 및 개발
기본 MCP 사용 환경 준비
파이썬 MCP Claude 기반 실습을 위해 다음을 설치한다. 
터미널에서 다음을 패키지들을 설치한다.
pip install mcp pydantic-ai fastmcp tavily-python 

이제, MCP 실행 방법을 살펴본다. 일단, 다음 MCP Quickstart에 있는 파일 system 도구를 설치해 본다. 
설치는 해당 MCP 도구 설명 링크에 다음처럼 나와 있다.
파일 관리 MCP 서버 도구의 경우
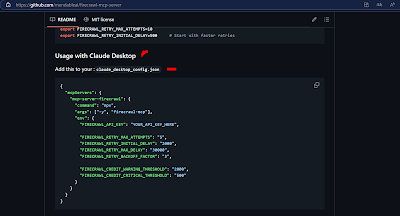
Firecrawl 클롤러 MCP 서버 도구의 경우

해당 MCP 서버 설정하는 메뉴를 선택한다. 이는 클로드 데스크탑 실행 후 파일>설정>개발자>설정편집 메뉴에 있다.
클로드 데스크탑의 해당 설정 메뉴
MCP 설정 JSON 파일

다음과 같이 클로드 데스크탑의 MCP 설정 파일인 claude_desktop_config.json을 편집기로 오픈한 후, 다음과 같이 MCP 도구를 추가하고, 클로드를 다시 리부팅한다(참고 - 예시). 
{
"mcpServers": {
"filesystem": {
"command": "npx",
"args": [
"-y",
"@modelcontextprotocol/server-filesystem",
"C:\\Users\\<사용자계정 폴더명>\\Desktop",
"C:\\Users\\<사용자계정 폴더명>\\Downloads"
]
},
}
}

참고로, 설치된 서버 도구의 경로는 절대 경로를 입력하고, 사용자 계정별로 정확한 폴더명을 사용한다. 경로 상 '\'는 '\\'로 입력하도록 한다.  

재부팅하면, 해당 MCP 도구가 다음과 같이 활성화되어 있을 것이다.

혹시 제대로 실행되지 않으면, 클로드 데스크탑이 설치된 폴더 아래 log파일을 확인한다. 그럼, 서버 도구 별로 에러 원인을 확인할 수 있다(보통 잘못된 경로, 키, 토큰 한계 오버플로우 등 문제).

이제 다음과 같이 클로드에서 파일을 생성, 추가, 삭제하는 등의 프롬프트를 입력해 본다.

난 톰이야. 개발자야. 요즘 시티팝에 대해 흥미가 있어. 유명한 시티팝 가수를 알려줘. 그 정보를 리스트해서 REPORT.TXT 란 이름으로 내 폴더에 저장해줘.

다음과 같이 바탕화면에 REPORT.TXT 가 내용 정리되 저장된다. 

firecrawl MCP 도구를 이용해 여행 뉴스를 결과는 다음과 같다. 

토큰 한계로 인해 에러가 발생할 수도 있으니 이때는 이를 고려해 프롬프트를 다시 수정 입력한다.  
예. 이제 여름이야. firecrawl 를 이용해서 여행 뉴스를 한개 검색해 알려줘.

파이썬 MCP Claude 기반 계산기 도구 개발
mcp-simple-calc.py란 이름으로 서버를 다음과 같이 코딩한다(참고 - Github 코드)
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("simple-calc")

# Add an addition tool
@mcp.tool()
def add(a: int, b: int) -> int:
    """Calc and Add two numbers"""
    return a + b

다음과 같이 Claude 서버에 설치한다. 
mcp install mcp-simple-calc.py

MCP 검사기로 테스트한다.
mcp dev mcp-simple-calc.py

Claude 데스크탑을 재부팅하고, 도구 표시가 있는 지 확인한다.

다음과 같이 개발자 도구가 제대로 설치되었는지 확인한다. 없다면, 컴퓨터 재부팅한후 다시 Claude 데스크탑 실행한다. 
설정 편집 버튼(파일>설정>개발자>설정편집)을 클릭하면, 다음과 같이 설치된 것을 확인할 수 있다. 
설정편집
참고로, 에러가 발생한 도구는 느낌표로 표시되므로 로그를 확인해 본다. 그리고, 아래 설정파일에서 에러를 수정하면 된다. 
에러로그 확인
수정 후 정상 동작되는 서버

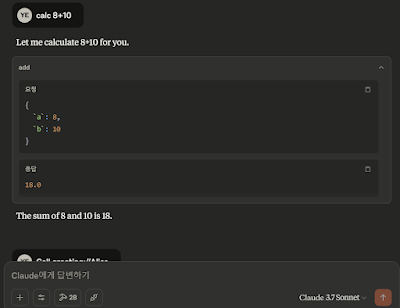
이제 프롬프트를 입력해 제대로 실행되는 지 확인한다. MCP 도구를 검색해 계산 결과를 출력해 준다.

네이버 날씨 MCP 도구 개발
다음과 같이 코딩하고, mcp-weather.py 로 저장한다(참고 - Github 코드).
from typing import Any
import requests
from bs4 import BeautifulSoup
from mcp.server.fastmcp import FastMCP
import sys

mcp = FastMCP("weather")

# 네이버 날씨 정보 도구
@mcp.tool()
def get_naver_weather(region: str) -> str:
    """
    네이버 날씨에서 특정 지역 날씨 정보를 가져옴.

    Args:
        region: 조회할 지역명 (예: 서울, 부산)
    """
    try:
        search_url = f"https://search.naver.com/search.naver?query={region}+날씨"
        headers = {
            "User-Agent": "Mozilla/5.0"
        }
        response = requests.get(search_url, headers=headers, verify=False)
        soup = BeautifulSoup(response.text, "html.parser")

        temperature = soup.select_one(".temperature_text > strong")
        status = soup.select_one(".weather_main")

        if not temperature or not status:
            return f"[{region}]의 날씨 정보를 불러올 수 없습니다. 지역명을 확인해 주세요."

        temp_text = temperature.get_text(strip=True)
        status_text = status.get_text(strip=True)

        return f"{region}의 현재 날씨는 '{status_text}'이며, 기온은 {temp_text}입니다."

    except Exception as e:
        print(e)
        return f"[오류] 날씨 정보를 가져오는 중 문제가 발생했습니다: {str(e)}"

# get_naver_weather('서울')

if __name__ == "__main__":
    print("MCP 서버 시작", file=sys.stderr)
    mcp.run()


클로드 파일>설정>개발자>설정편집에서 다음과 같이 해당 weather도구를 추가한다. 참고로, 파이썬 경로는 where 명령을 이용해 경로 확인 후 설정한다. 소스파일도 해당 경로 확인 후 설정한다.
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "C:\\Users\\MAC\\Desktop",
        "C:\\Users\\MAC\\Downloads"
      ]
    },
    "weather": {
      "command": "C:\\Users\\MAC\\.conda\\envs\\venv_lmm\\python.exe",
  "args": [
    "F:\\projects\\ai\\5-1.agent\\mcp-weather.py"
  ]
    }
  }
}

클로드를 재부팅하고, 프롬프트를 입력한다.
"네이버로 서울의 날씨를 검색해"

그럼 다음과 같이 도구가 검색된다. 허용을 클릭하면 개발된 도구가 실행되어 정보를 얻고 적절히 답해준다.

결과는 다음과 같다.

별도 MCP 서버 클라이언트 개발
MCP는 오픈소스이므로, 서버 클라이언트를 별도 개발해 클로드 데스크탑 같은 호스트 프로그램 같은 것도 개발할 수 있다. 
mcp-simple-calc-server.py란 이름으로 서버를 다음과 같이 코딩한다.
from mcp.server.fastmcp import FastMCP
import math

# instantiate an MCP server client
mcp = FastMCP("Hello World")

@mcp.tool()
def add(a: int, b: int) -> int:
"""Add two numbers"""
return int(a + b)

@mcp.resource("greeting://{name}")
def get_greeting(name: str) -> str:
"""Get a personalized greeting"""
return f"Hello, {name}!"

if __name__ == "__main__":
mcp.run(transport="stdio")

터미널에서 다음과 같이 MCP 서버 명령을 실행한다.
mcp dev mcp-simple-calc-server.py

만약, npm error code SELF_SIGNED_CERT_IN_CHAIN 에러가 발생한다면, 방화벽 때문이니 다른 네트웍에서 시도하거나, 해당 방화벽 옵션을 꺼야 한다. 서버가 제대로 실행되면, 다음 명령이 성공할 것이다.
curl -i http://localhost:5173/sse

서버가 실행되었다면, http://localhost:5173/#roots 링크에 접속한다. 접속에 성공했다면 MCP 기반 등록된 도구들 리스트 확인 및 도구 호출이 가능하다.
MCP 기반 등록된 도구들 리스트 확인 및 호출 모습

다음과 같이 mcp_client.py 클라이언트를 코딩한다.
from mcp import ClientSession, StdioServerParameters, types
from mcp.client.sse import sse_client
from mcp.client.stdio import stdio_client

async def run():
    async with sse_client(url="http://localhost:5173/sse") as streams:
        async with ClientSession(*streams) as session:
            await session.initialize()
            tools = await session.get_tools()
            print(tools)

            result = await session.run("calculate power 2, 4?")
            print(result.data)

if __name__ == "__main__":
    import asyncio
    asyncio.run(run())

만약 stdio 방식을 사용하면, 다음과 같이 서버를 지정하고 stdio_client를 사용한다.
server_params = StdioServerParameters(
    command="python",  # Executable
    args=["F:\\projects\\mcp_agent\\mcp-server-client\\mcp_server.py"],  # Optional command line arguments
    env=None,  # Optional environment variables
)

...
    async with stdio_client(server_params) as streams:

pydantic_ai를 이용한 클라이언트 코드는 다음과 같다. 
from pydantic_ai import Agent
from pydantic_ai.mcp import MCPServerHTTP
from dotenv import load_dotenv
import os, asyncio

load_dotenv()

server = MCPServerHTTP(url='http://localhost:5173/sse')  # Ensure the server URL is correct and supports SSE 
agent = Agent('openai:gpt-4o', mcp_servers=[server])  

result = agent.run_sync('calculate power 2, 4?')
print(result.data)

클라이언트가 정상적으로 실행된다면, 해당 프롬프트에 대한 적절한 도구를 LLM이 MCP 프로토콜을 통해 찾고 호출해 결과를 리턴할것이다.

호스트와 서버 도구 간 검색 및 호출 방법
좀 더 MCP 동작 과정을 상세히 살펴보기 위해 호스터와 서버 간 호출 방법을 확인해 본다.
MCP의 도구는 서버가 호스트에 연결된 클라이언트 요청을 받아 실행 가능한 기능을 외부에 노출하고, LLM이 작업을 수행하는 데 활용할 수 있도록 설계된 요소이다. 도구는 클라이언트를 통해 검색 가능하며(`tools/list`), 작업 수행 요청은 `tools/call` 엔드포인트를 통해 전달된다. 

다음은 도구를 기술하는 메타데이터이다.
{
  name: string;          // Unique identifier for the tool
  description: string;  // Human-readable description
  inputSchema: {         // JSON Schema for the tool's parameters
    type: "object",
    properties: { ... }  // Tool-specific parameters
  }
}
 
도구는 단순한 계산부터 복잡한 API 연동까지 다양할 수 있고, 고유한 이름과 설명을 통해 식별되고 사용된다.  

도구는 다음과 같이 정의, 호출된다. 
app = Server("example-server")

@app.list_tools()
async def list_tools() -> list[types.Tool]:
    return [
        types.Tool(
            name="calculate_sum",
            description="Add two numbers together",
            inputSchema={
                "type": "object",
                "properties": {
                    "a": {"type": "number"},
                    "b": {"type": "number"}
                },
                "required": ["a", "b"]
            }
        )
    ]

@app.call_tool()
async def call_tool(
    name: str,
    arguments: dict
) -> list[types.TextContent | types.ImageContent | types.EmbeddedResource]:
    if name == "calculate_sum":
        a = arguments["a"]
        b = arguments["b"]
        result = a + b
        return [types.TextContent(type="text", text=str(result))]
    raise ValueError(f"Tool not found: {name}")

MCP 도구를 구현할 때는 다음과 같은 권장사항을 따르는 것이 좋다.  

도구는 명확한 이름과 설명을 갖추고, 매개변수는 JSON 스키마로 상세히 정의하며, 사용 예제를 포함해 모델이 이해하고 활용할 수 있도록 한다. 작업의 안정성과 신뢰성을 위해 오류 처리와 유효성 검사를 구현하고, 긴 작업은 진행 상황 보고를 포함하며, 원자성을 유지해야 한다.  
반환 값 구조는 문서화하고, 적절한 시간 초과와 리소스 사용 제한을 설정하며, 디버깅 및 모니터링을 위한 로깅 기능도 포함해야 한다.

Ollama MCP-CLI 기반 실습
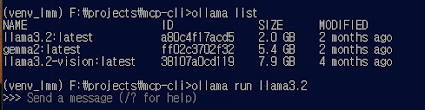
Ollama 도 MCP를 지원한다. Ollama, mcp-cli 도구를 이용해 MCP 서버에 등록된 도구를 호출하는 방법을 간략히 실습한다. 
터미널에서 다음 명령을 실행한다.

mcp서버 실헹에 필요한 UV(fast Python package and project manager)를 설치한다.
pip install uv
uv sync --reinstall

다음과 같이 Ollama를 실행한다.
ollama run llama3.2

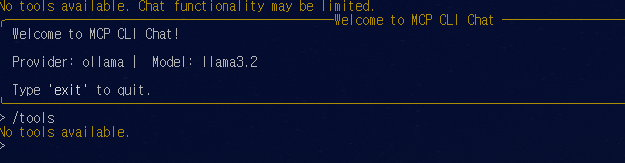
새로운 터미널 창에서 다음 명령을 실행한다.
uv run mcp-cli chat --server filesystem --provider ollama --model llama3.2

vscode github copilot MCP 설정 및 사용
최근 vscode github copilot(코파일럿)에 MCP 기능이 추가되었다. 클로드 데스크탑보다 사용이 쉬워 금방 MCP 도구를 추가 사용할 수 있다. 상세 설정 메뉴얼은 다음 링크를 참고한다.
설정은 그렇게 어렵지 않은 데, 프로젝트 설정 폴더인 .vscode를 만든 후, mcp.json파일을 다음과 같이 설정하면 된다. 클로드 데스크탑에서 설정하는 방법과 동일하다. 
{
"inputs": [
// The "inputs" section defines the inputs required for the MCP server configuration. 
{
"type": "promptString"
}
],
"servers": {
// The "servers" section defines the MCP servers you want to use.
"fetch": {
"command": "uvx",
"args": ["mcp-server-fetch"]
}, 
"filesystem": {
"command": "npx",
"args": [
"-y",
"@modelcontextprotocol/server-filesystem",
"C:\\Users\\MAC\\Desktop",
"C:\\Users\\MAC\\Downloads"
]
},
"blender": {
"command": "uvx",
"args": [
"blender-mcp"
]
}
}
}
그리고, copilot 창에서 agent mode로 설정 한 후 프롬프트로 요청을 하면 다음과 같이 해당 도구가 실행된다. 
filesystem mcp 도구 요청 실행 모습
vscode에서 블렌드 mcp 도구 실행 모습

결론
MCP는 경량 프로토콜이라 개발 및 사용이 편리하다. 향후, 이런 방식이 AI에이전트 개발 시 대세가 될 것이라 생각한다. 기업에서 자동화 등을 위한 최적화된 서비스 개발 분야에서는 LLM을 직접 조작해야 한다. 하지만, 대중적으로 사용되는 도구는 다음과 같이 MCP + 노코드(nocode) 형태가 될 것이다. 

레퍼런스
부록: Figma MCP 와 Copilot 연결
Figma MCP는 다음 링크에서 제공한다. 
설치 순서는 다음과 같다. 
  • .vscode 폴더에 mcp.json 파일 생성
  • mcp.json 파일에 다음과 같이 figma api key 설정 후 저장
{
    "servers": {
        "figma-mcp": {
            "command": "cmd",
            "args": [
                "/c", "npx", "-y",
                "figma-developer-mcp",
                "--figma-api-key=figd_xxxxxxxxxx", "--stdio"
            ]
        }
    },
    "inputs": []
}

figma key는 다음 그림과 같이 settings > security 에서 생성해 복사해 놓는다.

저장하면, 다음과 같이 run, restart 메뉴가 선택된다. 클릭해 실행하면 된다. 

Copilot의 Tools을 선택해, 해당 figma mcp를 선택한다.

이제 디자인한 Figma 페이지의 URL을 다음과 같이 복사한다. 

작업 폴더를 만들고, Copilot의 Add Context 메뉴 선택해 해당 작업 폴더를 선택한다. 그리고, 다음과 같이 복사된 URL과 함께 프롬프트를 입력한다.
create comlete html5, css, js and images using this figma "<input your figma page URL" in this figma folder, put images in the 'images' folder.

그럼 다음과 같이 에이전트 모드에서 figma mcp가 웹 페이지를 생성할 것이다. 

에이전트 모드라 다음과 같이 코드도 자동 생성된다.

생성된 웹페이지 결과는 다음과 같다.