검색어 파이토치에 대한 글을 날짜를 기준으로 정렬하여 표시합니다. 관련순 정렬 모든 글 표시

2026년 7월 8일 수요일

ICML 2026 주요 연구 논문 기술, 실용성 및 수준 분석

이 글은 ICML(International Conference on Machine Learning) 2026 주요 논문을 간략히 기술 분석하고, 연구 수준 및 실용성을 정리해 나눔한다.

ICML 2026은 2026년 7월 6일부터 11일까지 서울 코엑스에서 열리는 국제머신러닝학회다. 올해는 23918건이 제출되어 6352편이 채택되었고, 채택률은 26.6%였다. 그런데 학회에서 발표되었다고 해서 모든 논문이 실제로 재현 가능한 것은 아니다. 

최근 연구에 따르면 ICML, NeurIPS, ICLR 세 학회의 평균 코드 공개율은 19.5퍼센트에 불과하다. 이번 글에서는 GitHub 저장소가 실제로 공개되어 있고, 실용적으로 가능한 경우만 추려서, 별도의 프로젝트 웹사이트까지 함께 공개된 논문들만 확인해 보았다(개인적으론 아무리 대단한 연구라 주장해도 코드와 모델을 직접 보고 실행하거나 응용해볼 수 없다면 ICML 조상 컨퍼런스에 발표되었다고 해도 무의미하다 생각한다).

각 논문은 연구목적과 사용 알고리즘, 베이스 모델을 하나의 문단으로 서술했고, 나머지 정보인 데이터셋, 연구 기술 수준, 구현 수준, 관련 링크는 목록 형태로 정리했다.

프로젝트 페이지와 GitHub를 모두 공개한 논문

Causal Forcing, 실시간 대화형 비디오 생성

이 논문은 양방향 확산모델을 소수 스텝의 자기회귀 학생 모델로 증류할 때 발생하는 이론적 결함을 규명하는 연구다. 기존 방법들이 프레임 단위 단사성 조건을 위반한다는 점을 이론적으로 증명하고, 이를 해결하기 위해 자기회귀 교사 모델 기반의 ODE 초기화와 분포 매칭 증류를 결합한 Causal Forcing을 제안했다. 후속 연구인 Causal Forcing플러스플러스에서는 ODE 대신 인과적 일관성 증류 방식을 도입했다. 베이스 모델로는 Wan2.1과 훈위안비디오의 HY1.5-TI2V-8B 비디오 확산 모델을 사용했다.

  • 사용 데이터셋: 대형 비디오 확산모델 사전학습 데이터 기반 자체 증류용 데이터
  • 연구 기술 수준: 최상급. 생성모델 이론 증명과 대규모 비디오 디퓨전 증류가 결합되어 있다
  • 구현 수준: 중간이다. 공개된 8B급 체크포인트로 추론 데모는 GPU 한 대로 바로 실행할 수 있지만, 증류 학습 자체를 재현하려면 대규모 인프라가 필요하다
  • 프로젝트 페이지: thu-ml.github.io/CausalForcing.github.io
  • GitHub: github.com/thu-ml/Causal-Forcing

Hibiki-Zero, 정렬 데이터 없는 동시 음성통역

이 논문은 단어 단위 정렬 데이터 없이도 실시간 다국어 동시 음성통역을 가능하게 하는 모델을 다룬 연구다. 프랑스어, 스페인어, 포르투갈어, 독일어에서 영어로의 통역을 대상으로, 먼저 문장 단위로 정렬된 데이터로 지도학습을 진행한 뒤 GRPO 기반 강화학습으로 통역 지연시간을 최적화하는 방식을 사용했다. 베이스 모델은 모시와 히비키 계열의 멀티스트림 디코더이며 파라미터 수는 3B다.

  • 사용 데이터셋: 자체 공개한 15시간 분량의 다국어 벤치마크
  • 연구 기술 수준: 최상급. 음성 파운데이션 모델을 처음부터 학습해야 한다
  • 구현 수준: 쉬움이다. 명령어 한 줄로 8기가에서 12기가 VRAM급 GPU에서 즉시 실시간 데모를 구동할 수 있다. 웹 UI로 감싸는 정도의 응용은 매우 용이하다
  • 프로젝트 페이지: hibiki-zero-s2st.github.io
  • GitHub: github.com/kyutai-labs/hibiki-zero

DR Tulu, 심층 리서치 에이전트

이 논문은 정답이 명확하지 않은 장문 심층 리서치 과제, 예를 들어 과학이나 의료 분야 질의에 대해 정책 모델과 함께 진화하는 루브릭으로 강화학습을 진행하는 최초의 완전 오픈 모델을 다룬 연구다. 핵심 알고리즘은 진화하는 루브릭을 활용한 강화학습이라는 뜻의 RLER이며, 멀티 롤아웃과 도구 증강 생성을 지원하는 GRPO 변형을 사용한다. 베이스 모델은 Qwen3-8B-Base다.

  • 사용 데이터셋: 과학, 의료, 일반 도메인의 장문 리서치 벤치마크 네 종류와 서치아레나, 오픈스칼라 데이터
  • 연구 기술 수준: 상급. 다만 모델과 데이터, 학습 코드, 평가 하네스까지 전부 오픈소스로 공개되어 있다
  • 구현 수준: 쉬움. 허깅페이스에서 체크포인트를 내려받은 뒤 vLLM 서버 두 대와 MCP 서버를 구동하는 것만으로 즉시 데모를 실행할 수 있다
  • 프로젝트 및 블로그 페이지: allenai.org/blog/dr-tulu
  • GitHub: github.com/rlresearch/dr-tulu
  • 모델 페이지: huggingface.co/rl-research/DR-Tulu-8B

The Obfuscation Atlas, RLVR 기만 및 정직성 탐지 연구

이 논문은 검증가능보상 강화학습, 즉 RLVR로 훈련할 때 모델이 화이트박스 거짓말 탐지기를 회피하는 현상을 실증적, 이론적으로 규명한 연구다. 리워드 해킹이 자연스럽게 발생하는 실제 코딩 환경을 구성하고, GRPO와 활성화 기반 기만 탐지 프로브를 결합해 정직한 정책과 은폐된 정책을 구분하는 분류체계를 제시했다. 베이스 모델로는 젬마3-12B-IT를 비롯한 네 개 모델을 사용했다.

  • 사용 데이터셋: 테스트 케이스 하드코딩 시나리오가 포함된 실제 코딩 문제, 그리고 500개 이상 학습된 모델 체크포인트를 허깅페이스에 공개했다
  • 연구 기술 수준: 상급. 정렬 연구와 메커니즘 해석, 강화학습 인프라가 결합되어 있다
  • 구현 수준: 중간. 코드가 설정, 학습, 탐지기 모듈로 나뉘어 있어 소규모 모델로 프로브 학습과 평가 파이프라인을 재현해볼 수 있다
  • 연구기관 페이지: far.ai/research/the-obfuscation-atlas-mapping-where-honesty-emerges-in-rlvr-with-deception-probes
  • GitHub: github.com/AlignmentResearch/obfuscation-atlas

GitHub 저장소가 상세히 공개된 논문

OmniAgent, 능동 비디오 지각 옴니모달 에이전트

이 논문은 긴 비디오나 여러 모달리티를 이해할 때 전체 영상을 다 보는 대신 필요한 프레임만 능동적으로 탐색하는 에이전트를 다룬다. 72B 모델보다 73퍼센트 적은 프레임으로도 더 나은 성능을 보였다. 비디오 이해 문제를 부분관측 마르코프 결정과정으로 정식화하고, 턴 단위 불확실성을 반영한 TAURA라는 강화학습 기법으로 정책을 학습한다. 베이스 모델은 Qwen2.5-Omni-7B다.

  • 사용 데이터셋: 비디오엠엠이, LV벤치를 포함한 열 개 벤치마크
  • 연구 기술 수준: 상급. 비디오 에이전트를 위한 강화학습 설계가 핵심이다
  • 구현 수준: 중간. 코드와 짐 형태의 능동지각 환경, 강화학습 및 지도학습 체크포인트가 모두 공개되어 있어 7B급 모델 기준으로 로컬 파인튜닝을 시도해볼 수 있다
  • GitHub: github.com/HarryHsing/OmniAgent

OmniShow, 인간과 사물 상호작용을 통합한 비디오 생성

바이트댄스가 발표한 이 논문은 텍스트, 참조 이미지, 오디오, 포즈 조건을 하나의 모델로 통합한 최초의 인간과 사물 상호작용 비디오 생성 올인원 모델을 제안한다. 채널 단위로 조건들을 통합해 주입하는 방식을 사용했으며, 베이스 모델은 Wan 기반의 DiT 비디오 확산 모델이다.

  • 사용 데이터셋: 자체 구축한 HOIVG벤치
  • 연구 기술 수준: 최상급. 대규모 비디오 확산 모델 학습이 필요한 산업 연구다
  • 구현 수준: 중간. 추론 코드와 체크포인트가 공개되어 데모 실행은 가능하지만 요구되는 GPU 자원이 크다
  • GitHub: github.com/Correr-Zhou/OmniShow

RLAnything과 AutoTool, 에이전틱 강화학습 오픈소스 레시피

젠버스 연구팀이 공개한 이 두 논문은 에이전틱 강화학습을 데이터, 알고리즘, 추론 모드라는 세 축으로 체계적으로 분석한 연구다. 실제 엔드투엔드 궤적 기반의 지도학습과 강화학습을 결합하고, 리워드 클리핑과 엔트로피 유지 기법을 적용해 소형 모델이 대형 모델을 능가하는 학습 레시피를 완성했다. 베이스 모델은 Qwen2.5-7B와 Qwen3-4B이며, 4B 규모의 DemyAgent 체크포인트를 공개했다.

  • 사용 데이터셋: AIME 2024와 2025, GPQA다이아몬드, LiveCodeBench-v6
  • 연구 기술 수준: 상급. 에이전틱 강화학습 파이프라인을 다룬다
  • 구현 수준: 쉬움. DemyAgent-4B 체크포인트가 허깅페이스에 공개되어 있어 로컬 평가와 소규모 파인튜닝을 바로 시도할 수 있다
  • GitHub: github.com/Gen-Verse/Open-AgentRL

S2L-PO, 작은 모델이 GRPO에서 정책 다양성을 더 잘 탐색한다

이 논문은 LLM 추론용 강화학습인 GRPO에서 오히려 작은 모델이 정책 수준의 다양성 탐색에 유리하다는 점을 규명하고, 이를 활용하는 학습 기법을 제안한 연구다. Qwen3 계열 모델을 소형과 대형으로 나누어 비교 실험을 진행했다.

  • 사용 데이터셋: 수학 추론 벤치마크
  • 연구 기술 수준: 상급. RL 알고리즘에 대한 실증 연구다
  • 구현 수준: 쉬움. 소형 모델 기준으로 GRPO 코드를 일부 수정하는 수준이라 재현이 비교적 간단하다
  • GitHub: github.com/qishisuren123/S2L-PO

NT-SSM, 그래프 협업 필터링의 대조학습 재고

이 논문은 그래프 기반 추천시스템, 즉 협업 필터링에서 대조학습의 한계를 지적하고 간단한 대안을 제시한 연구다. 기존 표준 모델인 LightGCN을 베이스 모델로 삼아 새로운 정규화 기반 대안 기법을 적용했다.

  • 사용 데이터셋: 아마존, 옐프 등으로 추정되는 표준 추천시스템 벤치마크
  • 연구 기술 수준: 중상급. 그래프 신경망 기반 추천시스템을 다룬다
  • 구현 수준: LightGCN 기반의 비교적 경량 모델이라 로컬 실험 재현이 용이하다
  • GitHub: github.com/geon0325/NT-SSM

해마 내후각피질 영감 세계모델

이 논문은 뇌의 해마와 내후각피질 구조에서 영감을 받아 구조적 추상화와 일반화가 가능한 세계모델을 설계한 연구다. 계산신경과학 기반의 구조학습 알고리즘을 사용했으며, 사전학습된 파운데이션 모델을 쓰지 않고 커스텀 순환신경망 기반 인지 모델을 처음부터 구성했다.

  • 사용 데이터셋: 인지과학 실험용 합성 환경
  • 연구 기술 수준: 난이도 높은 수준. 계산신경과학과 세계모델이 결합되어 있다
  • 구현 수준: 중간. 주피터 노트북으로 공개되어 있어 소규모 실험을 재현하고 수정해보기가 비교적 수월하다
  • GitHub: github.com/senngadaisuki/hpc-mec-worldmodel

CaDRe, 기후 분석을 위한 인과 구조 학습

이 논문은 은닉 동적 과정을 고려한 일반적인 인과 구조 학습 기법을 기후 데이터 분석에 적용한 연구다. 비선형 독립성분분석 기반의 인과 표현 학습과 인과 발견 알고리즘을 사용하며, 사전학습 모델 없이 커스텀 인과표현학습 신경망을 사용한다.

  • 사용 데이터셋: 기후과학 시계열 데이터
  • 연구 기술 수준: 높은 수준. 인과추론과 시계열 분석이 결합되어 있다
  • 구현 수준: 중간. 공개된 코드로 자체 시계열 데이터에 적용해볼 수 있지만 인과추론 이론에 대한 이해가 선행되어야 한다
  • GitHub: github.com/MinghaoFu/CaDRe

LatentTSF, 관측에서 상태로 이어지는 잠재 시계열 예측

이 논문은 원시 관측치가 아니라 잠재 상태 공간에서 시계열을 예측하는 프레임워크를 다룬다. 잠재공간 상태추정과 시계열 예측을 결합한 방식이며, 파이토치 기반의 커스텀 상태공간모델을 베이스로 사용한다.

  • 사용 데이터셋: 표준 시계열 예측 벤치마크
  • 연구 기술 수준: 중상급이다. 
  • 구현 수준: 파이토치 공식 구현체가 공개되어 있어 자체 데이터를 적용하기가 비교적 쉽다
  • GitHub: github.com/Muyiiiii/LatentTSF

FiSeR, 크로스 도메인 AI 이미지 탐지를 위한 세밀한 출처 표현

이 논문은 디퓨전이나 GAN 등 서로 다른 생성모델이 만든 AI 이미지를 도메인이 달라도 탐지할 수 있는 세밀한 출처 특징 추출 기법을 다룬다. 표준 CNN과 ViT 백본을 기반으로 한 출처 특화 표현학습 방식을 사용한다.

  • 사용 데이터셋: 다양한 생성모델 출처의 AI 이미지 벤치마크
  • 연구 기술 수준: 포렌식과 탐지 모델을 다룬다
  • 구현 수준: 이미지 분류기 수준의 모델이라 재현 난이도가 상대적으로 낮다
  • GitHub: github.com/heyongxin233/FiSeR

CoopEval, 협력 유지 메커니즘과 LLM 에이전트 벤치마킹

이 논문은 죄수의 딜레마류의 사회적 딜레마 상황에서 협력을 지속시키는 메커니즘과 LLM 에이전트의 협력 행동을 벤치마킹한 연구다. 게임이론 기반의 다중 에이전트 시뮬레이션을 사용하며, 별도의 파운데이션 모델 학습 없이 GPT와 클로드 계열 API 기반 LLM 에이전트를 그대로 활용한다.

  • 사용 데이터셋: 자체 구축한 사회적 딜레마 게임 환경
  • 연구 기술 수준: 게임이론과 LLM 에이전트가 결합되어 있다
  • 구현 수준: LLM API 호출 기반의 게임 시뮬레이션이라 AI 코딩 도구로 비교적 쉽게 재현하고 확장할 수 있다
  • GitHub: github.com/Xiao215/CoopEval

SubspacePathPruner, 추론 시점 LLM 구조적 프루닝

이 논문은 별도의 재학습 없이 추론 시점에 프로브 기반의 표현과 파라미터 결합을 활용해 LLM을 구조적으로 경량화하는 기법을 다룬다. 라마와 Qwen 등 공개된 LLM에 바로 적용할 수 있도록 설계되었다.

  • 사용 데이터셋: 표준 LLM 압축 벤치마크
  • 연구 기술 수준: 모델 압축을 다룬 수준 높은 기술
  • 구현 수준: 재학습이 필요 없는 방식이라 기존 오픈소스 LLM에 바로 적용해볼 수 있다
  • GitHub: github.com/GongZhiren/SubspacePathPruner

정리

이번에 정리한 논문들을 살펴보면 몇 가지 흐름이 보인다.

첫째, 공개 수준이다. Causal Forcing, Hibiki-Zero, DR Tulu, Obfuscation Atlas 네 편은 프로젝트 페이지와 GitHub를 모두 갖추고 있어 데모와 체크포인트까지 즉시 사용할 수 있는 최고 수준의 공개도를 보인다. 나머지 논문들은 대부분 GitHub 저장소만 공개되어 있지만 README와 체크포인트가 상세해서 실질적으로 재현이 가능한 수준이다.

둘째, 베이스 모델 관점이다. 처음부터 새로 학습한 파운데이션 모델을 다루는 연구는 Causal Forcing, Hibiki-Zero, CaDRe, 해마 내후각피질 세계모델 등이며 대체로 기술 난이도가 최상급이다. 반면 기존에 공개된 LLM이나 VLM 위에 파인튜닝, 프롬프트, 경량 어댑터를 얹는 방식의 연구, 예를 들어 DR Tulu의 Qwen3-8B, OmniAgent의 Qwen2.5-Omni-7B, RLAnything과 AutoTool의 Qwen 계열, GR-LoRA와 AREA와 HypCL의 CLIP 등은 구현 난이도가 가장 낮고 응용 확장성이 크다. 베이스 모델 없이 알고리즘이나 이론 자체가 기여인 연구, 예를 들어 린 라이브러리나 CaDRe, Learning to Emulate Chaos 같은 경우는 코드가 공개되어 있어도 이론적 배경을 먼저 이해해야 정확하게 활용할 수 있다.

셋째, 구현 수준 관점이다. 명령어 한 줄로 실행되는 Hibiki-Zero, 서버만 띄우면 되는 DR Tulu, 허깅페이스 체크포인트만 내려받으면 되는 Causal Forcing처럼 설치, 실행, 커스터마이징 흐름을 그대로 따라갈 수 있는 논문들이 실질적인 구현 후보다. LoRA 계열이나 활성화 함수 교체, 재학습이 필요 없는 프루닝 기법처럼 기존 모델에 얹는 방식의 연구도 코드 복잡도가 낮아 구현 성공률이 높다. 반대로 형식수학 증명이나 쌍곡기하학 기반 모델처럼 특수한 수학적 프레임워크를 요구하는 연구는 코드가 공개되어 있어도 정확히 재현하기가 쉽지 않다.

이 글은 2026년 7월 9일 기준으로 웹 검색을 통해 개별 확인한 GitHub 저장소와 프로젝트 페이지 링크를 바탕으로 작성했다. 저장소는 계속 업데이트되므로 실제 활용 전에 최신 링크를 다시 확인하는 것이 좋다.

레퍼런스

2025년 3월 29일 토요일

딥시크(deep seek) 오픈소스 코드 및 구조 분석하기

앞서 AI에이전트 오픈 미노스를 분석해 보았는 데, 내친김에 그 동안 말 많았던 딥시크(deep seek)의 github 공개 코드를 분석해 보기로 한다. 사실, 개인적으로 언론의 기사를 잘 믿지는 않는다. 홍보성 퍼나른 기사가 많기도 하고, 특히 테크분야에서도 약장사분들? 많아, 어디까지 진실인지 아닌지 모르기 때문이다. 정말 대단한지, 아니면 지재권 완전 무시하고 기술 탈취?해 싼 제품 잘 만드는 중국 방식으로 개발된 것인지를 이들이 써낸 논문이 아닌 공개된 코드에 기반해 팩트 확인해 보고자 한다.
딥시크 (theconversation.com, 2025)

참고로, 마누스 오픈소스에 관심 있다면 다음 링크를 참고한다. 

딥시크 분석 준비
다음 링크를 방문해 코드를 클론한다.
터미널에서 다음 명령을 실행한다. 
git clone https://github.com/deepseek-ai/DeepSeek-V3.git

폴더 및 파일 구조 분석 
vscode를 띄워 보니 폴더 구조는 다음과 같다. 
  - workflows: 워크플로우 관련 폴더
  - inference: 하위 폴더
    - configs: 설정 파일 폴더
    - convert.py: Python 파일, 4KB
    - fp8_cast_b16f.py: Python 파일, 5KB
    - generate.py: Python 파일, 8KB
    - kernel.py: Python 파일, 9KB
    - model.py: Python 파일, 8KB
    - requirements.txt: 텍스트 파일, 1KB


공개된 소스 코드를 보니 굳이 실행을 위한 패키지 설치는 할 필요 없을 것 같다. 일단, 오픈소스가 아니다. 단순히, inference 추론 코드만 공개되어 있다(어그로). 오픈소스라면, 최소한, train 학습 코드와 기본 데이터셋 정도는 공개되어야 한다(언론이 왜 오픈소스라 난리였는지 사실 이해가 안되는...). 

코드는 대부분 트랜스포머 구조를 그대로 사용한다. 트랜스포머스는 구글에서 이미 2017년 개발 공개된 LLM 모델 학습 메커니즘이다. 딥시크에서 사용한 상세한 기술을 알고 싶다면, 다음 링크를 참고하길 바란다.

소스 코드 분석
공개된 코드는 주로 추론을 위해 딥시크 측에서 공개한 학습된 가중치 모델 파일을 로딩해 사용하기 위한 model.py, 양자화로 성능 가속을 위한 fp8_cast_bf16.py, 질의 프롬프트에 대한 모델 출력을 생성하는 generate.py 정도가 분석할 필요가 있어 보인다. 

model.py 분석
일단, 사용하는 라이브러리 대부분이 미국 빅테크 기업 혹은 연구소에서 개발된 것들을 임포트에 사용하고 있다. 이 분야에서 모르면 간첩인 pytorch, 심지어 triton은 NVIDIA GPU 가속 최적화를 위해 사용하는 라이브러리를 직접 사용한다(NVIDIA 종속적). 

모델의 전체 구조는 트랜스포머를 그대로 따르며, 이미 오픈소스 공개된 코드에 나오는 키워드도 다음처럼 그대로 사용하고 있다.

model.forward를 확인해보자. 일반적인 트랜스포머스 forward 루틴으로 보여진다. 
    def forward(self, tokens: torch.Tensor, start_pos: int = 0):
        seqlen = tokens.size(1)
        h = self.embed(tokens)  # 1) 입력 임베딩
        freqs_cis = self.freqs_cis[start_pos:start_pos+seqlen]  # 2) # 위치 인코딩
        mask = None
        if seqlen > 1:              # 3) 마스킹
            mask = torch.full((seqlen, seqlen), float("-inf"), device=tokens.device).triu_(1)
        for layer in self.layers:   # 4) 트랜스포머스 레이어 실행 계산
            h = layer(h, start_pos, freqs_cis, mask)
        h = self.norm(h)[:, -1]   # 5) 출력 정규화
        logits = self.head(h)     # 6) 로짓 계산
        if world_size > 1:
            all_logits = [torch.empty_like(logits) for _ in range(world_size)]
            dist.all_gather(all_logits, logits)
            logits = torch.cat(all_logits, dim=-1)
        return logits

이 함수는 입력 토큰을 받아 로짓(예측값)을 계산하는 역할을 한다. 예측값은 미리 준비된 사전에서 예측된 단어를 선택할 때 역할을 한다(입력 토큰에 대한 다음 토큰 예측 생성과정). 주요 동작은 다음과 같다.
  1. embed: 입력 임베딩 처리: 입력으로 제공된 토큰 텐서를 임베딩 레이어를 통해 변환하여 초기 입력 표현을 생성한다. 
  2. freqs_cis: 로터리 임베딩 계산:  주파수 정보를 담고 있는 로터리 임베딩 텐서를 시퀀스 길이에 맞게 선택하여, 위치 정보를 모델에 제공한다. 위치임베딩이란 기법도 이미 트랜스포머스 논문(Google, 2017)에 구현된 것이다.
  3. mask: 시퀀스 길이가 1보다 클 경우, 미래 정보가 영향을 미치지 않도록 상삼각형 형태의 마스크를 생성한다. 마스크는 모델이 언어 생성 시 현재 시점 이전의 정보만을 활용하게 한다.
  4. Transformer 레이어 통과: 모델 내부의 여러 Transformer 레이어를 입력 데이터가 순차적으로 통과하며, 각 레이어에서 입력 표현이 갱신된다. 
  5. norm: 출력 정규화 및 최종 표현 추출. 마지막 Transformer 레이어의 출력을 정규화하고, 시퀀스의 마지막 토큰에 해당하는 표현을 추출한다. 
  6. logits: 로짓 계산. 추출된 최종 표현을 출력 레이어(헤드)에 전달하여 로짓, 즉 예측값을 계산한다. 이는 각 토큰에 대한 다음 단어 또는 출력값의 확률 분포를 나타낸다.
결과적으로, 이 메서드는 입력 토큰 시퀀스를 기반으로 각 토큰에 대한 예측값을 반환하며, 이는 주로 언어 모델링 및 자연어 처리 작업에 활용된다.

모델의 전체 구조는 다음과 같다. 대부분 파이토치 기반 트랜스포머스 코드(이미 많이 공개된 코드 조각)를 사용한다(딥시크 처음 언론 보도가 실제로 얼마나 차이가 있는 지 확인할 수 있음).
딥시크-V3 모델 구조(UML)

다만, 실행 속도 등 최적화를 위해 병렬처리, torch.einsum 함수를 이용해 GPU 연산을 직접 이용해 트랜스포머 어텐션 모델 QKV 코사인 유사도 계산하는 등의 노력을 하고 있다(이 또한 이미 알려진 것).
토큰 시퀀스 임베딩 벡터 간 유사도 스코어 계산 및 학습하는 부분(일부. 트랜스포머스 모델의 전형적인 루틴임. 여기서 bshd는 batch, source seqnce, heads, feature demension 의 약자로 입력 텐서의 모양-차원을 정의함)

kernel.py 분석
이 모듈은 주로 성능과 관련된 양자화를 다룬다. triton 라이브러리를 사용해 주어진 텐서를 양자화하여, 32비트 실수 연산을 8비트 실수 연산으로 처리할 수 있게 한다. 8비트 텐서 실수 연산을 위한 함수도 같이 구현되어 있다. 예를 들어, 다음 fp8_gemm 함수는 8비트 양자화된 a, b 텐서를 입력받아 행렬곱한 후 c를 리턴한다.

convert.py 분석
이 모듈은 모델 파일 포맷을 주어진 옵션에 맞게 단순히 체크포인트 파일로 변환하는 역할을 한다. 복잡한 내용은 별로 없어 상세 설명은 생략한다.

configs 파일 분석
이 폴더 내 모델의 구조를 정의하는 주요 변수가 정의되어 있다. 예를 들어, config_16B.json 파일은 다음과 같이 정의된다. 
의미는 다음과 같다. 
1. 모델 구조  
   - vocab_size: 어휘 크기 (102,400).  
   - dim: 임베딩 차원 (2048).  
   - inter_dim: FFN의 확장 차원 (10,944).  
2. MoE 관련  
   - n_routed_experts: 총 Expert 수 (64).  
   - n_activated_experts: 활성화 Expert 수 (6).  
   - moe_inter_dim: MoE Expert의 내부 FFN 차원 (1,408).  
3. Attention 관련  
   - n_layers: Transformer 레이어 수 (27).  
   - n_heads: Attention Head 수 (16).  
   - kv_lora_rank: 키/값 벡터의 LoRA 랭크 (512).  
   - qk_nope_head_dim: NOPE 기반 헤드 차원 (128).  
   - qk_rope_head_dim: RoPE 기반 헤드 차원 (64).  
4. 기타  
   - mscale: 모델 안정성을 위한 스케일 값 (0.707).  

분석해 본 결과, 사실 LLM에서 모델 구조, 추론 구현 부분 및 양자화 모듈만 대부분 공개되어 있다는 것을 알 수 있다. 

최소한 데이터셋 모듈이라도 공개되어야 어떤 식으로 데이터를 학습했는지 확인할 수 있지만, 이런 중요 모듈은 공개되어 있지 않아, 딥시크-V3는 오픈소스를 공개했다고 말하기 어렵다(가중치와 모델 모듈만 오픈. 이건 reddit에서도 까이고 있는데, 그냥 오픈웨이트 open weights 모델 코드임).

더 파보기
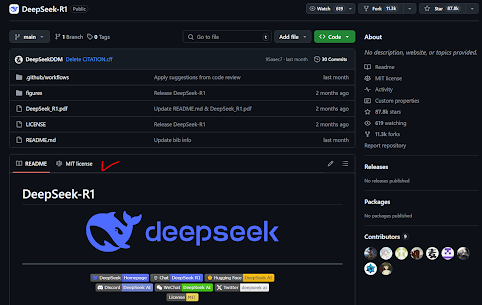
오픈소스라기에는 좀 실망이라, 무언가 더 없는 지 공개된 자료들을 파보기로 한다. 일단, 딥시크 개발사 github에서 최근 주목받고 있는 프로젝트만 다음처럼 정렬해본다.

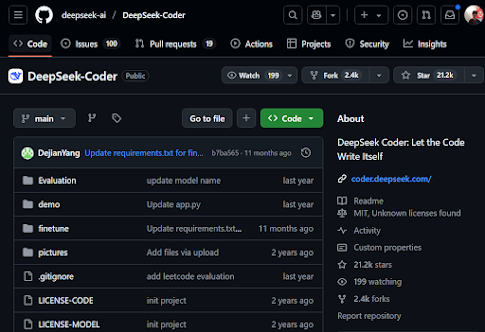
이 중 체크한 부분이 먼가 있는 듯 하여, 들어가 확인해 본다. 
MIT 라이센스라 표시만 되어 있지, 코드가 없음
딥시크 기반 코더는 평가, 데모 코드만 있고, 파인튠은 학습 데이터셋 제공 없음 
평가 코드만 있음(MIT 라이센스 표시만. 오픈소스? 무슨 의미가?)
딥시크-V3 학습모델(가중치파일) 공개된 부부(허깅페이스)

더 파보았지만, 딥시크에서 주장하는 것은 오픈소스가 아닌 오픈웨이트 모델에 더 가까워보인다. 세계적인 홍보와 언론의 관심에 비해 무늬만 MIT라이센스 오픈소스가 아닌지 의문이다.

마무리
공개된 코드에 기반해 좀 시간을 내어 분석한 후, 확인 사살한 것은 다음과 같다. 
  1. 언론에서 말하는 것과는 상당한 차이가 있는 딥시크 기술 오픈소스였다. 대부분 이미 개발된 오픈소스를 가져다 쓴 것으로 보인다. 앞에 언급한 몇몇 성능 최적화 부분은 좋은 접근인 것이나, 메타(페북)의 라마(Llama)가 공개한 기술에 비하면 비교할 만한 것이 아니다.
  2. 중국은 확실히 홍보에 큰 능력이 있다. 선진국 기술을 가져다가 가성비 있게 만드는 기술은 세계 최고 수준이다. 
의문점은 한국 언론에서 다음과 같이 패닉성 기사를 쓸 때, 왜 남이 말한 것 받아 만 쓰고 팩트 확인하지 않았냐는 것인데... 좀 생각해보니 국내 딥시크 기사는 관련 컨텐츠를 해외에서 퍼온 검증도 안된 글을 기사로 정리한 것으로 이해된다. 사실, 첨단 기술을 팩트 체크할 리소스가 있는 언론이 많지는 않다고 생각한다. 그럼에도 파급격있는 채널은 뉴스를 전할때 항상 팩트 확인하려는 노력이 필요하다.
패닉성 딥시크 언론 보도(연합, 2025.1.27, 뉴스튜데이, 2025.3.28)

자극적 기사들로 얼마 전 정부 국회는 패닉되고, 급하게 만든 인공지능 진흥전략이 판을 치게 된 트리거 역할을 했다. 여론은 인공지능분야도 우리가 중국에 뒤쳐졌다는 것을 확인하는 계기는 되었다. 긍정적 효과도 있었다고 생각되나, 부작용도 있다. 예를 들어,불필요한 일들이 벌어지고(갑작스런 GPU전수조사? 등), 갑작스런 대규모 GPU 센터 개발 계획이 발표되고, 이로 인해 세금이 비합리적으로 계획 투입되고, .. 이상한 방향으로 국가 첨단기술 연구개발 전략이 설정되고... 대규모 세금이 투입되지 않을 까라는 생각을 들게 만든다.

이 글에서 딥시크가 오픈소스 맞는지(거짓), 정말 중국 독자 기술로 개발했는지(거짓), 자국 GPU 사용해 개발했는 지(거짓. 기껏 추론 부분만 Google TPU같이 NPU 사용했을 가능성), 기술적 개선이 있었는지(성능 최적화 부분은 약간 인정), 정말 공개한 것은 무엇인지(모델만. 오픈웨이트) 등의 질문을 확인해 보았다. 

이 상황이면, GPT 학습 데이터를 증류해(카피해) 모델을 학습했다는 것이 더 신빙성 있어 보인다(가성비있게 실리콘밸리 테크 기술을 카피해 싸게 소프트웨어를 개발했다는 쪽이 더 맞는 듯. 물론 이것도 아무나 할 수 있는 건 아니다). 

딥시크 학습 방법은 오픈소스로 공유되어 있지 않아 그들만의 기술 보고서로만 확인할 수 밖에 없는데, 지금까지 분석된 내용과 Reddit에서 올라온 내용을 확인하면, 분산된 모델 학습 아키텍처로 비용을 절감할 수 있었다는 추정과 NVIDIA 기술을 사용한 것은 분명하다는 의견이 지배적이다. 
만약, NVIDIA를 deepseek 개발자가 대치할 수 있었다면, 그것으로도 큰 비지니스가 되었을 것이기 때문에, 해당 학습용 병렬처리 서비스나 제품을 출시하고 홍보하지 않을 리가 없지 않을까싶다. 

레퍼런스

2024년 3월 21일 목요일

허깅페이스 트랜스포머 라이브러리 사용법 총정리

이 글은 허깅페이스 트랜스포머 라이브러리 사용법을 정리해본다. 이 글은 QA 시스템, 문장 분류, 토큰 의미 예측 방법 등을 소개한다. 이 글은 생성AI의 핵심 아키텍처 모델인 트랜스포머를 잘 이용하고 싶은 개발자, 연구자, 학생들에게 도움이 된다. 

만약, 트랜스포머의 내부 동작 메커니즘이 궁금하다면, 다음 링크를 참고한다.

소개
허깅페이스는 트랜스포머 라이브러리를 개발하여, 관련 최신 모델을 다운로드하고, 쉽게 학습 및 사용할 수 있는 API 도구를 제공한다. 

트랜스포머를 통해 다음 기능을 구현할 수 있다. 
훈련 데이터셋 다운로드 제공 예(yelp_review_full · Datasets at Hugging Face)


지원되는 모델
아래 표를 보면 알겠지만, LLM(Large Language Model) 뿐 아니라 생성AI와 관련된 모든 사전 학습된 모델을 제공한다(상세 참고). 
모델 구조
허깅페이스는 베이스 모델의 활용성을 높이기 위해 다음과 같이 3단계 클래스 구조를 지원한다. BERT, QWEN 모델이라면 입력에 대한 특징 출력 역할을 하는 베이스 클래스에서 파생받아 특정 목적을 지원하는 헤드를 추가해 제공하는 방식으로 모델 사용성을 확장시킨다.  

계층

대표 클래스명 명명 규칙

목적 (Task)

주요 출력물 (Outputs)

사용 사례

Level 0


(Root)

PreTrainedModel

모든 모델의 공통 기능 제공 (가중치 로드, 저장, 설정 관리)

없음 (추상 베이스)

모든 모델의 기본 뼈대

Level 1


(Base)

{Model}Model


(예: BertModel, Qwen2Model)

특징 추출 (Backbone). 문맥을 이해하여 고차원 벡터로 변환

last_hidden_state


(토큰별 임베딩 벡터)

문장 유사도 비교, 커스텀 모델 제작

Level 2


(Head)

{Model}For{Task}


(예: BertForSequenceClassification)

특정 작업 수행. 베이스 모델 위에 한 층의 레이어(Head) 추가

loss, logits


(결과 점수 및 손실)

실제 서비스 적용 (분류, 생성, 추출 등)


수준 2에 해당하는 목적 별 활용되는 모델을 생성하기 위해 허깅페이스는 자동으로 클래스를 결정해주는 AutoModel (Auto Classes · Hugging Face) 을 지원한다. 그러므로, 베이스 모델을 파생받은 각각의 목적별 BERT, QWEN 클래스를 사용하지 않아도(예. BertForSequenceClassification.from_pretrained("...")), 자동으로 from_pretrained(모델명) 함수 호출시 모델명이 입력되면, 편리하게 필요한 모델의 클래스를 자동으로 생성해준다(팩토리 패턴과 유사하게 구현되어 있음). 

AutoModel 클래스명

목적 (Task)

주요 출력물 (Outputs)

사용 사례

AutoModel

특징 추출 전용 (Level 1 로드)

last_hidden_state

텍스트를 벡터로 변환하여 DB 저장

AutoModelForCausalLM

문장 생성 (LLM 핵심)

logits (다음 단어 확률)

챗봇, 소설 쓰기, 코드 생성

AutoModelForSequenceClassification

문장 단위 분류

logits (클래스별 점수)

감정 분석, 스팸 판정, 대화 의도 파악

AutoModelForTokenClassification

단어(토큰) 단위 분류

logits (단어별 태그)

개체명 인식(NER), 품사 태깅

AutoModelForVision2Seq

이미지 기반 설명 (VLM)

logits (이미지 설명 텍스트)

이미지 캡셔닝, 시각적 질의응답(VQA)

AutoModelForQuestionAnswering

지문 내 정답 찾기

start_logits, end_logits

독해 문제 풀이, 매뉴얼 내 정보 검색


이를 고려해서 클래스 구조가 다음과 같이 설계되어 있다.  
클래스 다이어그램(UML)

주요 코드는 다음과 같이 확인할 수 있다.
class BertModel(BertPreTrainedModel):
...
class LlamaPreTrainedModel(PreTrainedModel):
class LlamaModel(LlamaPreTrainedModel):
...
class LlamaPreTrainedModel(PreTrainedModel):
class LlamaForCausalLM(LlamaPreTrainedModel):
...

라이브러리 설치 방법
이 라이브러리 사용을 위해서는 NVIDIA GPU, CUDA, PyTorch, Tensorflow 사전 설치가 필요하다. 
명령행 터미널을 실행하고, 가상환경에서 다음을 입력해, 라이브러리를 설치한다.
pip install transformers[torch] datasets evaluate

설치하면, 추론 inference 등에 사용할 수 있는 파이프라인 객체를 사용할 수 있다. 파이프라인은 대부분 학습된 모델의 복잡성을 간소화한 API를 제공한다. 인식, 마스킹 언어 모델링, 특징 추출이 가능하다. 다음 코드는 그 예이다. 
import transformers, torch
from transformers import pipeline

print(transformers.__version__)
print(torch.cuda.is_available())

pipe = pipeline("text-classification", model="nlptown/bert-base-multilingual-uncased-sentiment", device=0)
msg = pipe("This restaurant is awesome")
print(msg)

다음과 같이 출력되면 성공한 것이다. 

트러블슈팅
현재 시점에서 텐서플로우 GPU버전은 패키지 의존성 에러가 발생한다. 참고로, pipeline에서 model과 device=0를 명시하면, 파이토치 GPU 버전으로 실행된다. 

방화벽으로 인해 오프라인 환경에서 실행해야 한다면 다음과 같이 설정 후 실행한다.
HF_DATASETS_OFFLINE=1 TRANSFORMERS_OFFLINE=1 \
python examples/pytorch/translation/run_translation.py --model_name_or_path google-t5/t5-small --dataset_name wmt16 --dataset_config ro-en ...

질의 응답 자료 학습
ChatGPT와 같이 질의 응답 자료를 학습 해본다. 학습된 모델은 허깅페이스의 허브에 저장해 놓고 재활용하기로 한다. 이를 위해, 다음과 같이 허깅페이스 토큰을 생성한다. 


이제, 다음과 같이 하습 데이터셋 다운로드 코딩한다. 
from huggingface_hub import notebook_login  # 허깅페이스 모델 업로드 위한 임포트
notebook_login()

from datasets import load_dataset  # squad 데이터셋 다운로드
squad = load_dataset("squad", split="train[:5000]")
squad = squad.train_test_split(test_size=0.2)
print(squad['train'][0])

다음과 같이 토크나이저에 훈련 텍스트 입력 처리를 위해, 최대 길이를 절단하는 등의 처리 함수를 코딩한다.
from transformers import AutoTokenizer  #  distilbert 토큰나이저 임포트
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased") 

def preprocess_function(examples):
    questions = [q.strip() for q in examples["question"]]
    inputs = tokenizer(
        questions,
        examples["context"],
        max_length=384,
        truncation="only_second",
        return_offsets_mapping=True,
        padding="max_length",
    )

    offset_mapping = inputs.pop("offset_mapping")
    answers = examples["answers"]
    start_positions = []
    end_positions = []

    for i, offset in enumerate(offset_mapping):
        answer = answers[i]
        start_char = answer["answer_start"][0]
        end_char = answer["answer_start"][0] + len(answer["text"][0])
        sequence_ids = inputs.sequence_ids(i)

        # Find the start and end of the context
        idx = 0
        while sequence_ids[idx] != 1:
            idx += 1
        context_start = idx
        while sequence_ids[idx] == 1:
            idx += 1
        context_end = idx - 1

        # If the answer is not fully inside the context, label it (0, 0)
        if offset[context_start][0] > end_char or offset[context_end][1] < start_char:
            start_positions.append(0)
            end_positions.append(0)
        else:
            # Otherwise it's the start and end token positions
            idx = context_start
            while idx <= context_end and offset[idx][0] <= start_char:
                idx += 1
            start_positions.append(idx - 1)

            idx = context_end
            while idx >= context_start and offset[idx][1] >= end_char:
                idx -= 1
            end_positions.append(idx + 1)

    inputs["start_positions"] = start_positions
    inputs["end_positions"] = end_positions
    return inputs

데이터셋을 앞의 정의된 함수로 전처리한다. 필요하지 않은 열은 제거한다. 
tokenized_squad = squad.map(preprocess_function, batched=True, remove_columns=squad["train"].column_names)

학습을 위해 배치를 만든다. 
from transformers import DefaultDataCollator
data_collator = DefaultDataCollator()

from transformers import AutoModelForQuestionAnswering, TrainingArguments, Trainer
model = AutoModelForQuestionAnswering.from_pretrained("distilbert/distilbert-base-uncased")  # 사전 학습 모델을 파인튜닝한다

training_args = TrainingArguments(
    output_dir="my_awesome_qa_model",
    evaluation_strategy="epoch",
    learning_rate=2e-5,
    per_device_train_batch_size=16,
    per_device_eval_batch_size=16,
    num_train_epochs=3,
    weight_decay=0.01,
    push_to_hub=True,
)  # 학습될 모델 및 파라메터 명시

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_squad["train"],
    eval_dataset=tokenized_squad["test"],
    tokenizer=tokenizer,
    data_collator=data_collator,
)  # 전이학습모델, 파라메터, 데이터셋, 토크나이져, 배치처리를 위한 데이터 컬렉터 설정

trainer.train()  # 학습
trainer.push_to_hub()  # 학습된 데이터를 허브에 업로드

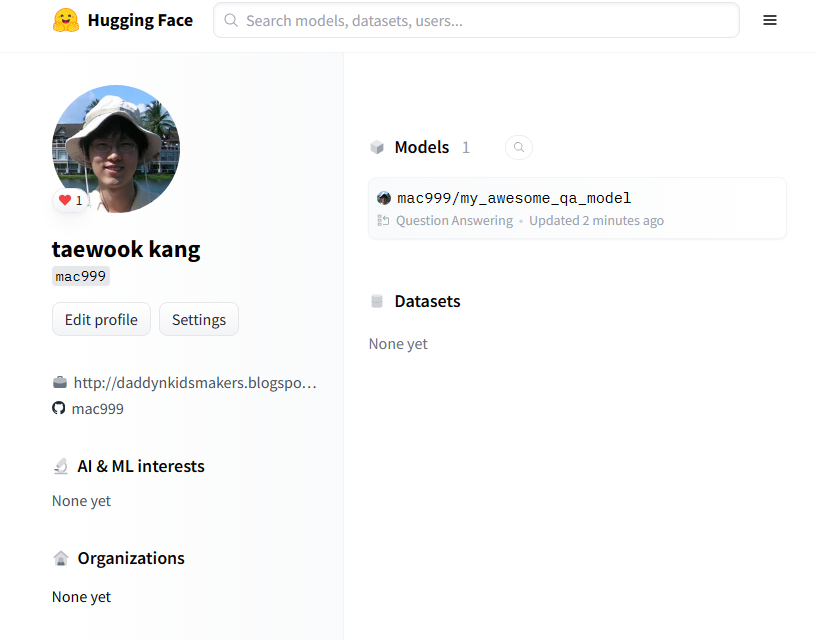
그 결과 다음과 같이 파인 튜닝된 학습 모델이 허브에 업로드되었다. 

다음과 같이 실행한다.
from transformers import pipeline

question = "How many programming languages does BLOOM support?"
context = "BLOOM has 176 billion parameters and can generate text in 46 languages natural languages and 13 programming languages."

question_answerer = pipeline("question-answering", model="my_awesome_qa_model")
question_answerer(question=question, context=context)

결과가 다음과 같다면 성공한 것이다.

NER(Named Entity Recognition) BERT 모델 
각 문장의 토큰 엔티티 의미를 인식하는 모델을 NER이라 한다. 문장 토큰의 의미를 인식할 수 있다면, 문장에서 특정 토큰에 대한 의미를 알고, 해당 의미에 대한 에이전트를 자동 실행하는 등의 서비스를 쉽게 개발할 수 있다. 

코드 개발 전에 다음을 설치한다. 
pip install transformers[torch] datasets

이 예제는 NER 데이터셋을 다운로드하고, BERT-BASE-NER(참고) 사전학습모델을 이용해 파인튜닝할 수 있다. BERT-BASE-NER 모델 사용방법은 다음과 같다. 
from transformers import AutoTokenizer, AutoModelForTokenClassification
from transformers import pipeline

tokenizer = AutoTokenizer.from_pretrained("dslim/bert-base-NER")
model = AutoModelForTokenClassification.from_pretrained("dslim/bert-base-NER")

nlp = pipeline("ner", model=model, tokenizer=tokenizer)
example = "My name is Wolfgang and I live in Berlin"

ner_results = nlp(example)
print(ner_results)

파인튜닝 데이터셋은 희귀한 토큰 의미를 정의한 데이터셋이다. 
NER 의미는 다음과 같다. 
Person
Location (including GPE, facility)
Corporation
Consumer good (tangible goods, or well-defined services)
Creative work (song, movie, book, and so on)
Group (subsuming music band, sports team, and non-corporate organisations)

이는 코드 상해 좀 더 상세화되어 표현되었다.
인덱스 | 태그                | 의미
0        | O                    | 엔터티 아님 (일반 단어)
1        | B-corporation    | 기업 이름 시작
2        | I-corporation     | 기업 이름 내부
3        | B-creative-work  | 창작물(책, 영화, 노래 등) 시작
4        | I-creative-work   | 창작물 내부
5        | B-group            | 조직 또는 단체 시작
6        | I-group            | 단체 내부
7        | B-location         | 지명 시작
8        | I-location         | 지명 내부
9        | B-person          | 사람 이름 시작
10      | I-person            | 사람 이름 내부
11      | B-product         | 제품 이름 시작
12      | I-product          | 제품 이름 내부

각 B, I, O는 Begin location, Inside location, Outside를 의미한다(NER 연구에 자주 나오는 용어). 참고로, New York City is a bustling metropolis의 NER 해석은 다음과 같다. 
New: O (Outside of any named entity)
York: B-LOC (Beginning of a Location entity)
City: I-LOC (Inside of a Location entity)
is: O
a: O
bustling: O
metropolis: O 

사용된 데이터셋은 다음과 같이 문장 토큰에 대한 NER이 정의되어 있다. 

다음은 파인 튜닝 코드를 보여준다. 주어진 입력단어를 토큰으로 분리한 후, wnut 데이터셋으로 앞의 NER 구분이 가능하도록 모델을 튜닝한다. 시간이 있다면, 시도해 본다. 
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("dslim/bert-base-NER")
def tokenize_and_align_tags(records):
    # 입력 단어를 토큰으로 분리함. 예를 들어, ChatGPT경우, ['Chat', '##G', '##PT']로 분해
    tokenized_results = tokenizer(records["tokens"], truncation=True, is_split_into_words=True)
    input_tags_list = []

    for i, given_tags in enumerate(records["ner_tags"]):
        word_ids = tokenized_results.word_ids(batch_index=i)
        previous_word_id = None
        input_tags = []

        for wid in word_ids:
            if wid is None:
                input_tags.append(-100)
            elif wid != previous_word_id:
                input_tags.append(given_tags[wid])
            else:
                input_tags.append(-100)
            previous_word_id = wid

        input_tags_list.append(input_tags)

    tokenized_results["labels"] = input_tags_list
    return tokenized_results

from datasets import load_dataset
wnut = load_dataset('wnut_17')
tokenized_wnut = wnut.map(tokenize_and_align_tags, batched=True)
tag_names = wnut["test"].features[f"ner_tags"].feature.names
id2label = dict(enumerate(tag_names))
label2id = dict(zip(id2label.values(), id2label.keys()))

from transformers import AutoModelForTokenClassification
model = AutoModelForTokenClassification.from_pretrained(
    "dslim/bert-base-NER", num_labels=len(id2label), id2label=id2label, label2id=label2id, ignore_mismatched_sizes=True
)

from transformers import Trainer, TrainingArguments, DataCollatorForTokenClassification
training_args = TrainingArguments(
    output_dir="my_finetuned_wnut_model",
)
# 하이퍼파라메터 튜닝용
training_args = TrainingArguments(
    output_dir="my_finetuned_wnut_model_1012",
    learning_rate=2e-5,
    per_device_train_batch_size=16,
    per_device_eval_batch_size=16,
    num_train_epochs=2,
    weight_decay=0.01,
    evaluation_strategy="epoch",
    save_strategy="epoch",
    load_best_model_at_end=True,
    push_to_hub=True,
)
data_collator = DataCollatorForTokenClassification(tokenizer=tokenizer)     
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_wnut["train"],
    eval_dataset=tokenized_wnut["test"],
    tokenizer=tokenizer,
    data_collator=data_collator,
)

trainer.train()

from transformers import pipeline
model = AutoModelForTokenClassification.from_pretrained("my_finetuned_wnut_model/checkpoint-1000")
tokenizer = AutoTokenizer.from_pretrained("my_finetuned_wnut_model/checkpoint-1000")

classifier = pipeline("ner", model=model, tokenizer=tokenizer)
out = classifier("My name is Sylvain and I work at Hugging Face in Brooklyn.")
print(out)

import evaluate
seqeval = evaluate.load("seqeval")
results = trainer.evaluate()
print(results)
trainer.push_to_hub()

참고로, 이 코드를 실행하면 결과는 다음과 같다. 

다음과 같이 문장 각 토큰의 의미(예. 사람, 위치 등)를 높은 정확도로 제공해 준다. 

마무리
이 글은 허깅페이스 트랜스포머를 이용해 다양한 사전학습 모델을 이용해 여러가지 서비스 개발 방법을 살펴보았다. 자체 데이터로 학습하거나, 데이터 학습을 좀 더 많이 할 수록 결과가 더 정확하고, 전문적이며, 풍부해 질 것이다.

레퍼런스
참고: OCR 인식 및 정보 추출
이미지나 문서와 같이 비정형 데이터에서 OCR을 지원하는 유용한 라이브러리는 다음과 같다. 
참고: 그래프, 그래픽, 기하학 데이터셋