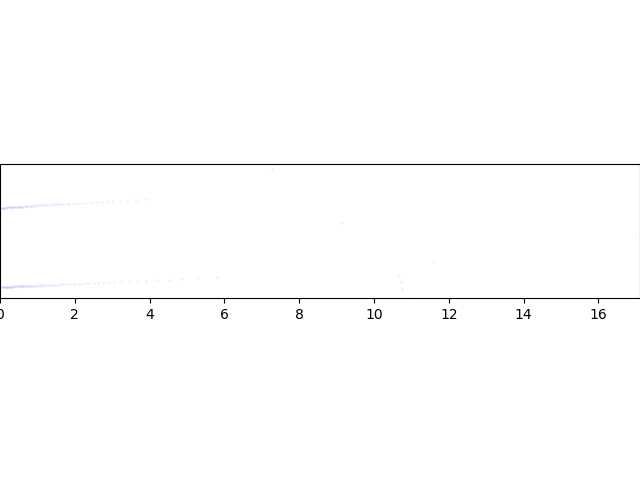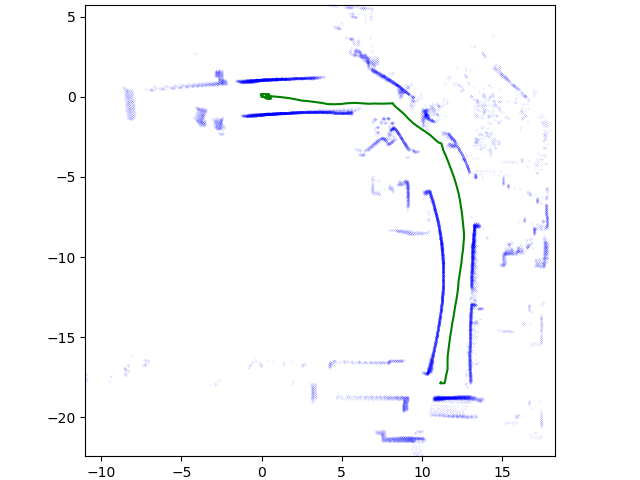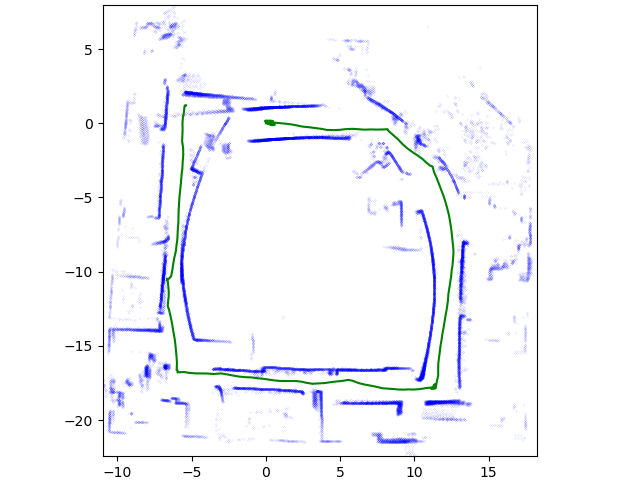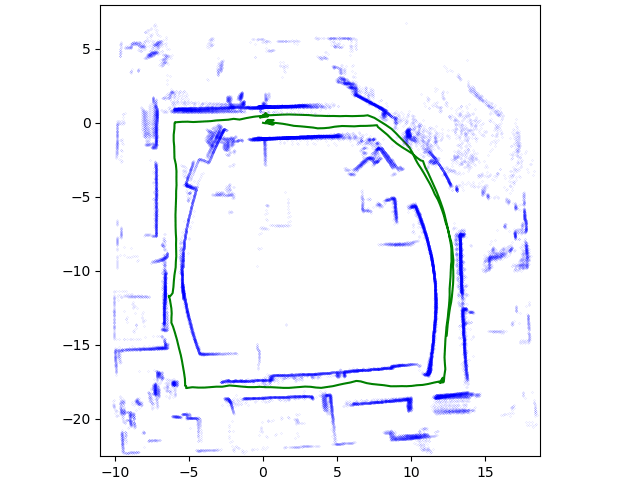검색어 LOAM에 대한 글을 관련성을 기준으로 정렬하여 표시합니다. 날짜순 정렬 모든 글 표시

2019년 6월 5일 수요일

벨로다인 LiDAR로 SLAM 만들기

이 글은 LiDAR(Light Detection and Ranging) 기반으로 SLAM 하는 방법을 간략히 설명한다. 슬램은 임의의 위치에서 상대적 거리를 측정할 수 있는 센서를 이용해 실시간으로 지도를 생성하는 기술이다. 이 기술은 무인자율차 등 실시간으로 2, 3차원 지도를 생성해야할 때 사용한다.
실시간 SLAM(Simultaneous localization and mapping) 기반 3D 맵(LOAM)

모바일 SLAM 결과(한국건설기술연구원 일산 건물)

이 글에서 SLAM을 활용해 보기 위해서 저가의 VLP16 벨로다인 센서를 사용한다. 참고로, 이 방법은 우분투 ROS 환경에서 실행된다. 여기서 사용하는 환경은 ROS(Robot Operating System) melodic 버전을 사용하였으며, NVIDIA TX2, 오드로이드 우분투 18.04 기반으로 TEST 하였다(SLAM은 많은 계산시간이 필요하므로, NVIDIA TX와 같이 가능한 성능 좋은 컴퓨터를 사용하는 것이 좋다. 이 경우에는 장치 소형화를 위해 부득이하게 오드로이드를 사용했다). 우분투, 벨로다인 LiDAR 드라이버, ROS, RViz 설치 방법은 다음 링크를 참고하길 바란다.
SLAM 동작 방식
SLAM은 다음과 같은 단계로 스캔된 포인트 클라우드 장면(Scene)을 정합(registration)한다.

1. 각 장면 별 특징(feature) 계산
보통 각 장면에서 스캔된 데이터 PCD에는 불변인 특징점이 존재한다. 예를 들어, 특정 곡률을 가진 포인트, 평면 포인트 클라우드 등이 그것이다. 포인트 클라우드 스캔 특징이 있다면 이를 특징으로 사용하면 된다.

2. 각 장면 별 유사 특징 매칭
각 장면 별 유사한 특징을 서로 매칭한다. 서로 같은 최소 3개 특징을 찾아 매칭할 수 있으면 다음과 같은 매칭 좌표변환행렬 MCT를 만들 수 있다. 각 장면별 획득된 MCT는 Odometry 데이타를 포함한다.

3. 장면 정합
각 장면의 매칭 좌표변환행렬을 얻으면, 이를 장면의 포인트 클라우드에 적용한다. 이로써 한 좌표계로 각 장면의 데이터가 정합된다. 이를 실시간으로 처리해야 하기 때문에 계산 성능이 좋은 장치를 사용해야 한다.
다음은 SLAM의 대표적 알고리즘 중 하나인 ICP를 이용한 실내 공간 스캔 데이터 정합 알고리즘이다.
ICP 기반 정합 행렬 계산 알고리즘(Yun-Ting Wang etc, 2018)

이 글에서는 SLAM의 원리를 깊게 다루지는 않는다. SLAM의 이론적 설명은 다음 링크를 참고한다.
SLAM은 대부분 ROS 패키지를 사용하므로, 이전 글 참고해 미리 설치해 놓어야 한다. ROS에 대한 상세 설명은 아래 글을 참고 하길 바란다.

LOAM SLAM
우선 SLAM 에서 잘 알려진 LOAM(Laser Odometry and Mapping) 방식 SLAM을 만들어보자. 다음과 같이 github에서 소스코드를 받고, 순서대로 빌드해 본다(링크1, 링크2 참고).

$ cd ~/catkin_ws/src/
$ git clone https://github.com/laboshinl/loam_velodyne.git
$ cd ~/catkin_ws
$ catkin_make -DCMAKE_BUILD_TYPE=Release
$ source ~/catkin_ws/devel/setup.bash

참고로, 오드로이드, 라즈베리파이 같이 램 용량이 적은 컴퓨터에서는 컴파일 에러가 발생한다. 이 경우, 부록에 설명된 방법대로 스왑 용량을 설정해 컴파일 빌드하면 된다(컴파일이 몇시간 걸릴 수 있다).

이제 roscore를 실행하고, 다음 명령을 실행한다.
roslaunch loam_velodyne loam_velodyne.launch

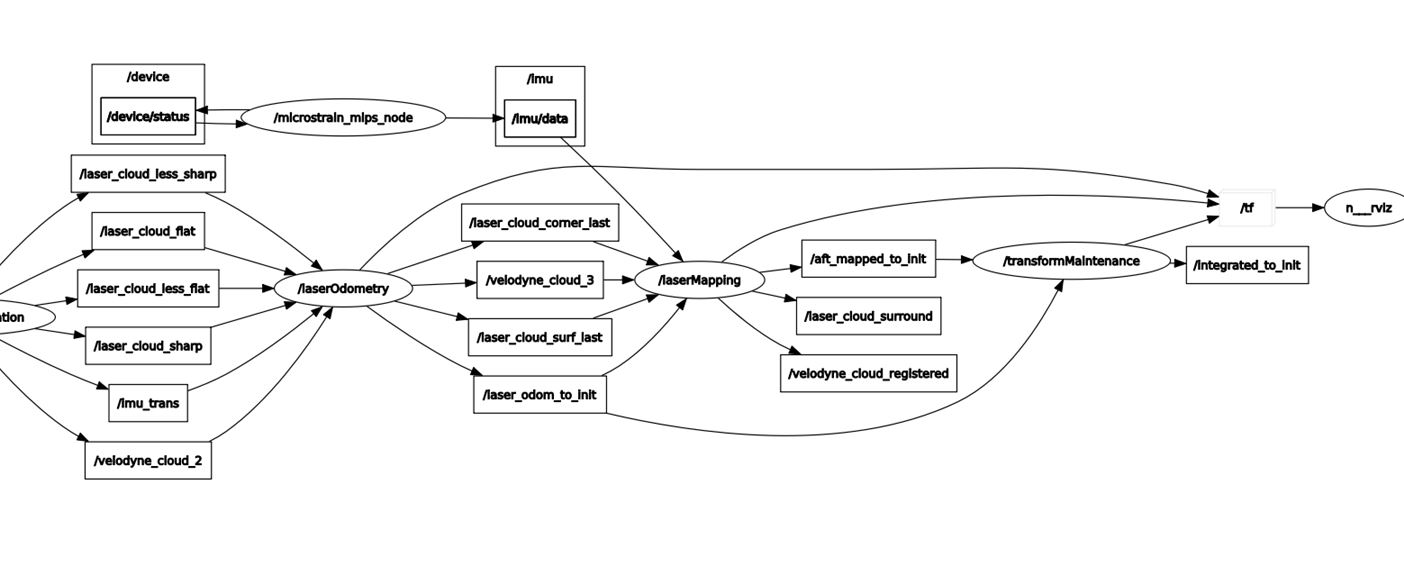
실행된 ROS node 토픽(rqt_graph)

LOAM SLAM을 이용해 회사 사무실을 LiDAR로 스캔해 본 결과는 다음과 같다. 점군 밀도가 밀집되어 있는 벽체가 진하게 표시되어 구분되는 것을 확인할 수 있다. 
SLAM 스캔 결과(건설연 본관 2동 3층)

점군이 모여있는 부분은 회사에 설치된 파티션이고, 그 외에 점들이 흩어져 있는 부분들은 천장 및 바닥이다. 파티션의 경계선은 뚜렷하게 표시된 맵이 생성되지만, 아직 좌표계, 캘리브레이션, IMU 등을 제대로 설정하지 않은 상황이라, SLAM 맵 정확도가 높지는 않아 보인다. 또한, 창쪽 유리가 반사되어 노이즈가 생기는 것을 확인할 수 있다. 

SLAM 점군과 측량장비(GLM100C)와 측정값 간의 차이는 높이 2미터에서 1-0.5미터정도이다. 정확도는 좀 더 다양한 방법으로 확인할 필요가 있어보인다.

1차 SLAM 테스트
2차 SLAM 테스트
3차 SLAM 테스트(ODROID)
4차 SLAM 테스트(NVIDIA TX2로 테스트. IMU연결안함. SLAM 맵 깨지는 현상이 덜함)

SLAM은 IMU 센서 유무에 따라 테스트해보았다. 두 경우 모두 급격한 회전이나 이동에 오차가 발생하는 것을 확인할 수 있다(이 문제는 성능 낮은 저가 임베디드 보드 사용과 관련있을 수 있다). 가능한 SLAM이 예측 가능한 방향으로 부드럽게 천천히 이동하는 것이 제일 품질이 좋다. 단, IMU 센서가 없는 경우 급격한 회전이나 이동시 오차가 상대적으로 더 많았으며, 정합 대상을 잃어버리면서 스캐닝되는 문제가 좀 더 빈번히 발생한다. 이렇게 정합이 안되고 발산하는 문제는 SLAM 기술의 일반적인 문제로 알려져 있다(상용 SLAM 측량 기술도 동일한 문제가 발생한다). 그러므로 현재 기술은 아직 SLAM을 이용해 스캔하는 방법이 결과물에 나쁜 영향을 줄 수도 있다.

참고로, VLP16의 스캔 수직범위는 크지 않아, 360도 스캔을 위해서는 스캐너를 회전시켜야 한다. 아래 영상은 LiDAR를 회전시켜 360도로 점군을 획득해 맵을 생성하는 예이다.

LOAM SLAM

SLAM 결과를 저장하려면 다음과 같이 토픽명을 지정하고 ROSBAG 명령어로 토픽 데이터를 저장하면 된다.
rosbag record -o out /laser_cloud_surround

만약, PCD 포맷으로 변환하려면, 아래 명령을 이용해 [input bag]에 저장된 .bag파일명을 지정해 준다.
rosrun pcl_ros bag_to_pcd [input bag] /laser_cloud_surround pcd

생성된 pcd파일은 다음과 같이 CloudCompare 프로그램으로 확인할 수 있다.
저장된 SLAM 정합 결과(CloudCompare)

참고로, 다음 명령을 이용해 미리 획득된 데이터를 플레이하거나 읽을 수 있다.
rosbag play ~/Downloads/velodyne.bag 
roslaunch velodyne_pointcloud VLP16_points.launch pcap:="$HOME/Downloads/velodyne.pcap"

LOAM동작을 이해하기 위해 소스코드를 UML로 역설계한다.
LOAM SLAM UML

아울로 ROS NODE간 토픽 그래프를 RQT_GRAPH 명령을 이용해 확인해 본다.
ROS NODE 토픽 그래프

구조와 소스코드를 분석해 보면 다음과 같은 순서로 SLAM데이터를 계산하고 있는 것을 알 수 있다.
1. velodyne node: 스캔 후 point cloud 데이터 획득
2. multi scan registration node: 스캔된 데이터에서 곡률 기반 특징점(모서리, 평면) 생성
3. laser odometry: 이전 스캔 데이터에서 생성된 특징점을 기반으로 현재 스캔 데이터의 매특징점과 비교해 주행괘적(odometry)을 계산
4. laser mapping: 주행괘적을 이용해 스캔 데이터를 보정해 정합함. 만약, IMU 센서가 있는 경우, /imu/data에서 얻은 데이터를 이용해 데이터 보정함

LOAM은 특징점 계산에 많은 계산 시간이 필요하다. 이런 이유로 원칙적으로 NVIDIA TX2 이상의 임베디드 보드가 필요하다. LeGO LOAM은 이 계산 시간을 좀 더 줄인것이다.
좀 더 자세한 내용은 관련 논문을 참고하길 바란다.

LeGO LOAM
LeGO(lightweight and ground optimized lidar odometry and mapping) LOAM은 LOAM에 비해 계산 시간은 줄이고, 루프백(LOOP BACK)을 지원하여 SLAM 안전성을 높인 방법이다. Levenberg–Marquardt algorithm 을 이용해 해 계산 방법을 개선한다. 참고로 LM 알고리즘은 특정 함수에 적합한 커브를 피팅(curve fitting)할 때도 많이 사용된다.
LeGO LOAM 링크를 방문해, 다음과 같이 소스를 다운로드후 빌드를 준비한다. 참고로, LeGO LOAM을 빌드하기 전에 GTSAM(Georgia Tech Smoothing and Mapping library) 패키지를 미리 설치해 놓아야 한다.

wget -O ~/Downloads/gtsam.zip https://github.com/borglab/gtsam/archive/4.0.0-alpha2.zip
cd ~/Downloads/ && unzip gtsam.zip -d ~/Downloads/
cd ~/Downloads/gtsam-4.0.0-alpha2/
mkdir build && cd build
cmake ..
sudo make install

다음과 같이 소스를 빌드한다.
cd ~/catkin_ws/src
git clone https://github.com/RobustFieldAutonomyLab/LeGO-LOAM.git
cd ..
catkin_make -j1

다음과 같이 ROS 패키지 실행해 보았다.
roslaunch lego_loam run.launch

참고로 lego 패키지의 노드 중 일부는 ROS의 시뮬레이션 time 을 이용한다. 이 기능은 ros::time 패키지에 있는 데, 이를 사용하는 노드의 ROS loop가 동작되지 않는 경우가 발생할 수 있다. 이 상황에는 실제 스캔된 포인트 클라우드 및 처리된 결과물을 rviz에서 확인할 수 없다. 이때는 해당 노드의 main() 함수 내에서 ROS loop가 실행되기 전에 다음과 같은 시간 초기화 함수를 호출해 빌드한 후 실행해 보면 잘 동작될 것이다. 
ros::time::Init();

일부 TF(Transform coordinate Frame) 토픽이 동작되지 않는 문제가 있을 수 있다. 이 경우 센서 데이터 좌표계가 설정되지 않아 rviz에 스캔 데이터가 표시되지 않고 에러 메시지가 발생한다. 이 경우, lego_loam 의 run.launch 파일 내 TF 토픽 발생하는 노드를 터미널에서 강제로 실행하면 잘 동작된다. 

문제가 없을 경우 LeGO SLAM 실행된 결과는 다음과 같다.
LeGO SLAM 실행 결과

github에 링크되어 있는 pcap파일로 실행하면 미리 스캔한 데이터로 다음과 같은 데모를 확인할 수 있다고 한다. 만약, 벨로다인에서 저장된 ROS bag 파일이 있다면, 다음 명령을 이용해 재생하여 rviz에 데이터를 표시할 수 있다. 참고로, LeGO 웹사이트에서 샘플 데이터 bag 파일을 다운로드 할 수 있다.
rosbag play *.bag --clock --topic /velodyne_points /imu/data
LeGO LOAM

LOAM이나 LeGO이외에도 여러가지 SLAM방식이 존재한다. 그러므로, 응용 목적에 따라 적합한 것을 사용해야 한다.
HDL graph SLAM

HDL GRAPH SLAM
HDL 그래프 스램은 3차원 라이다를 이용한 슬램 기술 중 하나로 NDT(Normal Distributions Transformation) 스캔 매칭 및 루프 검출 방식을 알고리즘으로 사용한다. 이 방식은 다음 그림과 같이 odometry 예측, RANSAC을 이용한 바닥 검출 등을 이용해 스캔 데이터 매칭을 수행한다.
HDL GRAPH SLAM 프로세스

HDL 슬램을 수행하려면, 다음 링크를 방문해 소스코드를 다운로드 받고, 빌드해야 한다.
실행을 위해 필요한 패키지는 다음과 같이 설치한다.

# for indigo
sudo apt-get install ros-indigo-geodesy ros-indigo-pcl_ros ros-indigo-nmea-msgs
# for kinetic
sudo apt-get install ros-kinetic-geodesy ros-kinetic-pcl_ros ros-kinetic-nmea-msgs ros-kinetic-libg2o
# for melodic
sudo apt-get install ros-melodic-geodesy ros-melodic-pcl-ros ros-melodic-nmea-msgs ros-melodic-libg2o

sudo pip install ProgressBar2

컴파일은 ROS cakin으로 빌드한다. 만약 intel 계열 보드가 아니면 OpenMP 사용하는 소스코드에서 에러가 발생한다. ARM계열 보드의 경우, openmp 패키지를 설치하고, 에러 나는 소스 코드를 일부 수정해야 한다.

관련 에러를 수정한 후 벨로다인 노드와 슬램을 실행다면 다음과 같은 결과를 확인할 수 있다.
실내 SLAM 결과

깃허브에 포함된 예제를 보면, 다음과 같은 실행 결과를 확인할 수 있다.
HDL GRAPH SLAM 결과

NDT(Normal Distributions Transformation) SLAM
NDT는 SLAM에서 사용하는 기술 중 하나로 PCL(point cloud library)에 구현되어 있는 알고리즘이다.
PCL NDT 지원 클래스

이 방법은 이동하는 장치에서 스캔한 점군 PCD1, PCD2가 있을 경우, 두 점군이 겹칠때 각 점들의 오차를 정규분포로 계산해 최소화하는 알고리즘으로 정합을 한다.
이 방법을 실시간 SLAM에 직접 사용할 때는 계산 성능에 문제가 있어, OCTREE 등 공간 인덱싱 기법을 사용해 속도를 개선해 사용하는 기법을 적용한다.
다음은 PCL 및 공간 인덱싱을 사용한 버전의 소스이다.
이 중 공간 인덱싱 적용된 NDT 코드를 다운로드받고 ROS CATKIN으로 빌드해 보았다. 그리고 다음과 같이 실행해 보았다(각 폴더는 본인 환경에 맞게 변경하길 바란다).

rosrun ndt_omp align /home/nvidia/catkin_ws/src/ndt_omp/data/251370668.pcd /home/nvidia/catkin_ws/src/ndt_omp/data/251371071.pcd

그럼 다음과 같이 두개의 점군이 정합된 결과를 확인할 수 있다.

NDT 결과

참고로, NDT는 GICP(Generalized Iterative Closest Point) 방식의 하나이다.
GICP 결과(좌: 정합되지 않은 두개 점군. 우: 정합된 점군)(PCL)

부록: 오드로이드 cc1plus internal compile 에러 솔류션
오드로이드는 내부 램 용량이 작은 임베디드 컴퓨터이기 때문에 컴파일 시 cc1plus internal compile error 가 발생될 수 있다. 이 경우, 터미널에서 다음과 같이 설정한다.

dd if=/dev/zero of=/swapfile bs=1024 count=4194304
chown root.root /swapfile
chmod 0600 /swapfile
mkswap /swapfile
swapon /swapfile

설정된 스왑 디스크 크기를 확인해 본다.
free -m

이렇게 해도 안된다면, 컴파일 시 make -j 옵션 대신 make 를 사용한다(관련 링크).

참고로, 임베디드 장치는 메모리 크기가 2~4G이며 스왑은 구성되어 있지 않다. 이 경우, 컴파일 프로세스에서 g++: internal compiler error: Killed (program cc1plus) 오류가 발생한다. 이 오류는 메모리가 부족하여 발생하므로, 스왑을 추가하여 문제를 해결할 수 있다(링크 참고).

참고: NVIDIA TX2기반 테스트
ODROID보다 TX2기반에서 안정적인 SLAM 처리가 가능하다. ROS 특성상 컴퓨팅 처리 속도가 늦으면, 메시지 동기화가 문제가 되며, 이로 인해 SLAM 맵 생성이 제때 처리되지 않는 문제가 발생할 수 있다. 참고로 TX2는 보통 개발 보드와 함께 조립되어 있는 데, 다음과 같은 캐리어 보드를 이용하면, 손바닥 보다 작은 크기로 패키징 가능하다.
 캐리어 보드
NVIDIA TX2와 개발보드

레퍼런스
기타 임베디드 보드에서 소스코드 빌드하며 에러가 발생할 때 구글링해 도움받은 레퍼런스는 아래와 같다. 

2020년 9월 23일 수요일

LIO SAM 기반 SLAM 기술 소개, 빌드 및 활용

이 글은 LIO SAM 기반 SLAM 기술 소개 및 활용에 대해 간략히 설명한다.

개요

LIO SAM은 LOAM개발자가 기존 방법을 개선해 개발한 슬램 기술이다. 

LIO-SAM은 라이더 관성 주행 거리 측정법을 개발해, 루프 폐쇄를 포함한 다양한 상대 및 절대 포인트 측정을 여러 소스에서 통합한다. 관성 측정 장치 (IMU) 통합에서 추정된 모션은 포인트 클라우드의 왜곡을 제거하고 라이더 주행 거리 측정 최적화를 위한 초기 추측 데이터를 생성한다. 라이더 주행 거리 측정 솔루션은 IMU의 편향을 추정하는 데 사용된다. 이 결과로 다음과 같이 기존 LOAM보다 좋은 결과를 얻을 수 있다.

시스템 아키텍처는 다음과 같다. 

이 기술은 다음과 같이 IMU, LiDAR가 미리 준비되어 있어야 한다.

소스 빌드 및 실행

다음과 같이 실행해 소스코드를 빌드한다.

sudo apt-get install -y ros-kinetic-navigation
sudo apt-get install -y ros-kinetic-robot-localization
sudo apt-get install -y ros-kinetic-robot-state-publisher
wget -O ~/Downloads/gtsam.zip https://github.com/borglab/gtsam/archive/4.0.2.zip
cd ~/Downloads/ && unzip gtsam.zip -d ~/Downloads/
cd ~/Downloads/gtsam-4.0.2/
mkdir build && cd build
cmake -DGTSAM_BUILD_WITH_MARCH_NATIVE=OFF ..
sudo make install -j8
cd ~/catkin_ws/src
cd ..
catkin_make

실행은 다음과 같다. 

roslaunch lio_sam run.launch

미리 준비된 데이터로 스캔 데이터를 시뮬레이션할 수 있다.

rosbag play your-bag.bag -r 3

결과는 다음과 같다. 

마무리

LIO SAM은 LOAM과 유사한 방식(참고)으로 개발되었다. 특징점을 계산하기 위해, GSTAM 패키지를 사용한다. 성능에 대한 설명은 여기를 참고한다.

레퍼런스


2021년 9월 14일 화요일

실행 코드로 이해하는 ICP(Iterative Closest Point) 알고리즘, 실행방법 및 SLAM과 차이점

이 글은 ICP(Iterative Closest Point) 알고리즘 및 실행방법을 설명한다.

ICP는 카메라, 라이다 등을 통해 생성된 3차원 점군을 정합해 실내외 지도를 만드는 데 핵심적으로 활용되는 알고리즘이다. 대부분의 SLAM(Simultaneous localization and mapping)알고리즘은 ICP를 응용 목적에 따라 수정해 개발한 것이다. 그래서, 수학적 계산 모델은 ICP, SLAM 모두 유사하다.

ICP는 한 대상물에 대해 다른 지점에서 스캔된 두개의 포인트 클라우드가 있을 경우, 이 두개의 데이터를 퍼즐처럼 합쳐, 정합(registration)하는 알고리즘이다. 반복적으로 가장 근접된 점들을 퍼즐처럼 맞춰주기 때문에 Iterative Closest Point 이라 한다. 

이 글은 ICP개념, 알고리즘 및 간단한 구현 방법을 살펴보고, SLAM과의 차이점을 알아본다. 이 글을 통해, SLAM알고리즘을 좀 더 깊게 이해할 수 있고, 각자 응용에 따른 로보틱스 기반 실내외 지도 생성 알고리즘 개발 등에 도움이 될 것이다.
점군 자동 정합 과정(GH-ICP)

머리말
ICP는 카메라, 라이다 등을 통해 생성된 점군을 정합해 실내외 지도를 만드는 데 핵심적으로 활용되는 알고리즘이다. 대부분의 SLAM(Simultaneous localization and mapping)알고리즘은 ICP를 응용 상황에 따라 수정해 개발한 것이다. 그래서, 수학적 계산 모델은 ICP, SLAM 모두 유사하다.

SLAM은 실시간 정합을 위해, 공간인덱싱 등 속도를 많이 고려하였고, 특징점 추출도 최대한 계산량을 줄일 수 있도록 처리되어 있다.

이전에도 이동체 주반의 맵을 계산하는 현지화(Localization. 로컬라이제이션) 알고리즘에 관성 항법 시스템(INS) 및 시각 센서를 기반으로 한 자세 추정은 최근 수십 년 동안 널리 연구되었다. INS 추정은 가속도와 각속도를 적분하여 자세와 방향 정보를 추정하는데, 이는 관성 센서의 바이어스와 노이즈로 인해 무한한 누적 오차가 발생하기 쉽다. 카메라 비전 기반 방법은 강력하고 정확한 모션 추정을 얻을 수 있다. 그러나 주변 조명 조건에 취약하다. 능동형 센서인 LiDAR는 빛에 대해 불변하다. Velodyne VLP-16과 같은 일반적인 3D LiDAR는 360도 방향에 대해 약 10Hz 스캐닝 속도로 데이터를 획득할 수 있다. 이런 점으로 인해 LiDAR는 로봇 시스템에서 널리 사용된다.

ICP와 SLAM
ICP는 로컬라이제이션 및 매핑(Mapping) 기술로 자율이동 시스템의 탐색 이동 작업을 수행하기 위한 핵심기술이다. ICP는 로봇에서 LiDAR 스캔 매칭에 널리 적용된다. 스캔된 점군 사이에 가장 가까운 점을 찾는 ICP알고리즘은 많은 비용이 필요하다. 특히 대규모 포인트 클라우드 데이터를 처리할 때, 실시간 요구 사항을 충족하기는 어렵다. 

카메라 기반 사진측량이나 LiDAR는 스캔할 때 많은 수의 렌드마크(Landmark. 특징점) 지점을 생성하지만, 이러한 지점 중 상당수는 쓸모가 없으며, 후속 처리의 부담을 증가시킨다. 이 문제는 다수 렌드마크에서 노이즈 필터링로 해결될 수 있다. 예를 들어, 렌드마크에서 그라운드(Ground) 포인트를 제거한다. 이 단계 후에 표준적인 알고리즘인 Point to Point ICP가 적용되어, 연속된 스캔 점군 간의 6자유도 변환 행렬을 계산한다. 또한, 스캔 환경에서 폐쇄 루프(Close Loop)가 감지되면 전역 적으로 6D 그래프 최적화 알고리즘을 적용할 수 있다.

포인트 클라우드 정합(Registration)은 지도 매핑을 위한 로봇 시스템의 핵심이다. 위치가 다른 두 개의 인접한 포인트 클라우드 스캔이 주어지면 목표는 이 두 스캔을 가장 잘 정렬하는 변환행렬을 찾는 것이다. 

일반적인 점 기반 방법은 선택된 가장 가까운 점에 따라 두 점군 사이의 변환 적용 시 거리 함수를 최소화한다. 이 방법은 정합 소프트웨어에서 가장 널리 사용되는 방법이다. 이외에, 포인트 클라우드에서 일부 하위 수준 속성을 추출하여, 스캔 매칭을 수행할 수도 있다. 예를 들어, 법선, 강도, 평면 표면, 모서리 및 사용자 정의 설명자와 같은 의미론적 정보를 사용한다. 이를 특징점이라 말한다. 이 특징점을 사용하여 스캔 사이의 점 대응 관계를 찾는다. 예를 들어, LOAM(Lidar Odometry and Mapping)은 가장자리 및 평면 특징을 추출하여 고정밀 맵을 생성한다. 그러나 많은 특징점은 특정 환경 조건에서 적용하도록 설계되었다. 특징점 기반 방법은 고속도로와 같이 기하학적 정보가 낮고 변화가 별로 없는 환경에서 낮은 품질을 갖는다. 

또 다른 유형의 알고리즘은 분포 기반 방법이다. 정규 분포 변환(NDT)은 점군을 가우스 확률 분포 집합으로 나타낸다. 점에 대해 직접 계산하는 대신, 이 방법은 점-분포 또는 분포-분포 대응을 반복적으로 계산하고, 각 반복 단계에서 거리 함수를 최소화한다.

앞서 언급한 누적 오류를 제한할 수 있는 또 다른 방법은 포인트 기반 스캔 매칭 알고리즘과 특징 기반 매핑을 결합하는 것이다. 

SLAM(동시 현지화 및 매핑)은 프런트엔드(Frontend)와 백엔드(Backend)의 두 부분으로 구성된다. 프런트엔드에는 데이터 연결 및 센서 자세 초기화가 포함된다. 백엔드에서는 필터링 방법, 포즈 그래프 최적화 방법이 사용된다. 그래프 기반 최적화는 SLAM 분야에서 가장 널리 사용되는 기술이다. 

관련 기술들
LiDAR로 얻은 포인트 클라우드에는 많은 그라운드 포인트가 포함되어 있다. 따라서 포인트 클라우드 전처리 단계에서 그라운드 포인트 제거가 중요한다. 일반적인 접근 방식은 Bounding Box Filter이다. 이를 사용하여 직사각형 경계 영역에서 점을 제외할 수 있다. 또 다른 방법은 법선과 기울기를 사용하여 로컬 특징을 계산한 다음, 영역 성장(Region grown)알고리즘을 수행하여 그라운드를 추출했다. 포인트 클라우드를 투영한 그라운드 포인트를 추출할 수도 있다. 투영을 통해 3차원 점군은 2차원 이미지로 생성된다. 이 경우 계산량은 크게 줄어든다.

머신 러닝을 기반으로 한 포인트 클라우드 세그먼테이션도 좋은 접근이다. CNN(Convolutional Neural Network)을 이용해, 그라운드 지점과 아닌 지점을 분할할 수 있다. 하지만, 이러한 지도 학습 방법은 모델을 훈련하기 위해 미리 레이블이 지정된 데이터 세트가 필요한다. 

백엔드에서는 필터 기반 방법, 포즈 그래프 최적화 방법이 사용된다. 이 프로세스는 전역적으로 일관된 매핑을 얻는 것을 목표로 한다. 확장 칼만 필터와 같은 필터 기반 방법에는 널리 사용된다. 

포즈 그래프 최적화 방법은 SLAM에서 더 큰 이점이 있다. 예를 들어, ICP를 사용하여 수렴될 때까지 모든 스캔을 정합하는 6D SLAM 방법이 있다. 폐쇄 루프가 감지되면, 전역 완화를 위한 GraphSLAM이 사용된다. LEGO-LOAM은 먼저 포인트 클라우드를 2D 이미지로 투영한다. 그런 다음 포인트 클라우드는 지상 및 비지상 포인트로 세분화된다. 특징점 추출 및 매칭 오차 함수는 6자유도 포즈를 추정하는 데 사용된다. 보다 정확한 결과를 얻기 위해 포즈 그래프 SLAM를 통합했다. LOAM은 실시간 작업을 충족함과 동시에 높은 포즈 추정 정확도를 달성한다. 그러나 특징점 기반 방법은 고속도로와 같이 기하학적 정보가 낮은 환경에서 부정확한 정합으로 이어질 수 있다.

ICP 알고리즘
ICP는 선택된 가장 가까운 점에 따라 두 점군 사이의 변환을 계산하기 위해, 거리 함수를 최소화한다. 
E(R,t)=∑i=1Nm∑j=1Nd∥si−(Rdj+t)∥2

Point-to-plane ICP알고리즘은 소스 포인트와 타겟 포인트의 접평면 사이의 거리 제곱의 합을 최소화할 수도 있다. 다만, 이 경우, 법선을 계산하는 비용이 실시간 지도 생성에 맞지 않을 수 있다. 

Topt=argminT∑i=1N((Tsi−di)ni)2

여기는 파이썬으로 구현된 점 대 점 ICP 알고리즘 구현코드를 분석해 설명한다. 참고로, 이 코드는 현재 아마존 로보틱스기술 개발  시니어 매니저인 Clay Flannigan이 구현한 것이다. ICP 구현 코드 중 가장 직관적으로 되어 있어 이를 활용해 설명한다.

import numpy as np
from sklearn.neighbors import NearestNeighbors

def icp(A, B, init_pose=None, max_iterations=20, tolerance=0.001):  
    '''
    주어짐 점군 A, B에 대해 정합 행렬을 계산해 리턴함.
    Input:
        A: numpy 형태 Nxm 행렬. 소스(Src) mD points
        B: numpy 형태 Nxm 행렬. 대상(Dst) mD points
        init_pose: (m+1)x(m+1) 동차좌표계(homogeneous) 변환행렬
        max_iterations: 알고리즘 계산 중지 탈출 횟수
        tolerance: 수렴 허용치 기준
    Output:
        T: 최종 동차좌표계 변환 행렬. maps A on to B
        distances: 가장 가까운 이웃점 간 유클리드 오차 거리
        i: 수렴 반복 횟수
    '''

    assert A.shape == B.shape

    # 차원 획득
    m = A.shape[1]

    # 동차 좌표계 행렬을 만들고, 점군 자료를 추가
    src = np.ones((m+1, A.shape[0]))
    dst = np.ones((m+1, B.shape[0]))
    src[:m,:] = np.copy(A.T)
    dst[:m,:] = np.copy(B.T)

    # src 점군에 초기 자세 적용
    if init_pose is not None:
        src = np.dot(init_pose, src)

    prev_error = 0

    for i in range(max_iterations):  # 정합될때까지 반복 계산
        # 소스와 목적 점군 간에 가장 근처 이웃점 탐색. 계산량이 많음. 
        distances, indices = nearest_neighbor(src[:m,:].T, dst[:m,:].T)

        # 소스 점군에서 대상 점군으로 정합 시 필요한 변환행렬 계산
        T,_,_ = best_fit_transform(src[:m,:].T, dst[:m,indices].T)

        # 소스 점군에 변환행렬 적용해 좌표 갱신
        src = np.dot(T, src)

        # 에러값 계산
        mean_error = np.mean(distances)
        if np.abs(prev_error - mean_error) < tolerance:  # 허용치보다 에러 작으면 탈출
            break
        prev_error = mean_error

    # 변환행렬 계산
    T,_,_ = best_fit_transform(A, src[:m,:].T)

    return T, distances, i


def nearest_neighbor(src, dst):
    '''
    소스와 목적 점군에 대한 가장 이웃한 점 계산
    Input:
        src: Nxm array of points
        dst: Nxm array of points
    Output:
        distances: 가장 가까운 이웃점간 유클리드 거리
        indices: 목적 점군에 대한 가장 가까웃 이웃점의 인덱스들
    '''

    assert src.shape == dst.shape

    neigh = NearestNeighbors(n_neighbors=1)
    neigh.fit(dst)
    distances, indices = neigh.kneighbors(src, return_distance=True)
    return distances.ravel(), indices.ravel()


def best_fit_transform(A, B):
    '''
    m 공간 차원에서 점군 A에서 B로 맵핑을 위한 최소자승법 변환행렬 계산
    Input:
      A: Nxm numpy array of corresponding points
      B: Nxm numpy array of corresponding points
    Returns:
      T: (m+1)x(m+1) 동차좌표 변환행렬. maps A on to B
      R: mxm rotation matrix
      t: mx1 translation vector
    '''

    assert A.shape == B.shape

    # 차원 얻기
    m = A.shape[1]

    # 각 점군 중심점 및 중심 편차 계산
    centroid_A = np.mean(A, axis=0)
    centroid_B = np.mean(B, axis=0)
    AA = A - centroid_A    # A행렬 편차
    BB = B - centroid_B     # B행렬 편차

    # SVD이용한 회전 행렬 계산
    H = np.dot(AA.T, BB)    # 분산
    U, S, Vt = np.linalg.svd(H)   # SVD 계산
    R = np.dot(Vt.T, U.T)     # 회전 행렬

    # 반사된 경우 행렬 계산
    if np.linalg.det(R) < 0:
       Vt[m-1,:] *= -1
       R = np.dot(Vt.T, U.T)

    # 이동 행렬 계산
    t = centroid_B.T - np.dot(R, centroid_A.T)   # 

    # 동차 변환행렬 계산
    T = np.identity(m+1)
    T[:m, :m] = R # 회전 행렬
    T[:m, m] = t  # 이동 행렬

    return T, R, t

여기서, SVD(Singular Value Decomposition. 특이값분해)는 주어진 점군에서 차원을 축소해, 변환행렬에 필요한 요소를 구한다. 
SVD 구성요소 및 변환 예시(WIKI)

여기서, 분해하려는 행렬 M은 m x n 실수 행렬이다. 
  • U: m x m 직교 행렬. 회전 변환
  • : m x n 대각 행렬. 스케일 변환
  • VT: n x n 직교 행렬. 회전 변환
다음 테스트 코드를 이용해 결과를 확인해 본다. 

import numpy as np
import time
import icp

# Constants
N = 10                                    # 데이터셋 크기
num_tests = 10                      # 반복 테스트 계산 횟수
dim = 3                                   # 데이터 포인트 차원 
noise_sigma = .01                   # 노이즈 표준 편차 
translation = .1                        # 테스트셋 최대 이동 거리
rotation = .1                            # 테스트셋 최대 회전 각 

def test_icp():

    # 임의 데이터셋 생성
    A = np.random.rand(N, dim)

    total_time = 0

    for i in range(num_tests):

        B = np.copy(A)

        # 테스트 데이터셋 이동
        t = np.random.rand(dim)*translation
        B += t

        # 회전
        R = rotation_matrix(np.random.rand(dim), np.random.rand() * rotation)
        B = np.dot(R, B.T).T

        # 노이즈 추가
        B += np.random.randn(N, dim) * noise_sigma

        # 위치 섞음
        np.random.shuffle(B)

        # ICP 알고리즘 실행
        start = time.time()
        T, distances, iterations = icp.icp(B, A, tolerance=0.000001)
        total_time += time.time() - start

        # 동차좌표 생성
        C = np.ones((N, 4))
        C[:,0:3] = np.copy(B)

        # 변환행렬 적용
        C = np.dot(T, C.T).T

        print('distance: {:.3}'.format(np.mean(distances)))

        assert np.mean(distances) < 6*noise_sigma                   # 평균 에러
        assert np.allclose(T[0:3,0:3].T, R, atol=6*noise_sigma)     # T and R should be inverses
        assert np.allclose(-T[0:3,3], t, atol=6*noise_sigma)        # T and t should be inverses

    print('icp time: {:.3}'.format(total_time/num_tests))

    return

실행 결과는 다음과 같다. 잘 정합되는 것을 확인할 수 있다.

점군 간 정합 알고리즘 코드를 디버깅하면, 다음과 같이 SVD를 계산해, 변환행렬을 계산하는 것을 확인할 수 있다. 이 변환행렬을 정합 대상이 되는 점군에 적용해가면서, 정합 퍼즐을 맞춰나간다. 


앞서 설명한 알고리즘이 점군 정합에 어떤식으로 동작하는 지 확인해 보기 위해, 각 수렴단계를 파일로 저장하여 동작을 가시화해본다. 다음과 같이 test.py 모듈에 사인 모양 점군을 생성하고, ICP()함수안에 각 정합 단계별로 파일을 저장하도록 코드를 추가한다. 

icp._index = 0
def test_icp():

    # Generate a random dataset
    # A = np.random.rand(N, dim)
    A = np.zeros((N, dim))

    x = np.arange(0, 3 * np.pi, 3 * np.pi / N) # create x array of angels from range 0 to 3*3.14
    y = np.sin(x)
    z = np.sin(x)

    for i in range(N):
        A[i][0] = x[i]
        A[i][1] = y[i]
        A[i][2] = z[i]
...

_index = 0
def icp(A, B, init_pose=None, max_iterations=20, tolerance=0.001):
    ...
    for i in range(max_iterations):
        # find the nearest neighbors between the current source and destination points
        distances, indices = nearest_neighbor(src[:m,:].T, dst[:m,:].T)

        _index = _index + 1
        fname = "point_" + str(_index) + ".xyz"
        f = open(fname, "a")
        for data in src.T:
            point = np.array2string(data, separator=',')
            point = point.replace('[', '')
            point = point.replace(']', '')
            f.write(point)
            f.write('\n')
        f.close()
        ...

test.py 안의 전역변수를 아래와 같이 수정해, 정합할 대상 점군과 원본 점군과의 차이를 크게 한다.
noise_sigma = 0.1                         # standard deviation error to be added
translation = 1.0                            # max translation of the test set
rotation = 1.0                                # max rotation (radians) of the test set

test.py를 실행해, 저장된 xyz 파일을 CloudCompare로 확인해 보면, 다음과 같이 녹색 점군이 흰색 점군으로 잘 정합되는 것을 확인할 수 있다.

SVD는 전역적인 최적화이므로, 지역적인 매칭은 오차가 있다. 예를 들어, 일부만 매칭하는 경우, 다음과 같이 오차가 크다는 것을 알 수 있다.
SVD기반 정합 결과(흰색 = 목표, 녹색 = 초기 점군, 적색 = 정합된 점군) 

PCL ICP 
PCL(Point Cloud Library)을 설치한 후, 구현된 ICP를 실행해 본다. 다음과 같이 스캔한 두개의 점군 데이터를 준비하여, 하나를 회전 이동 변환해 본다.
../pcl_transform_point_cloud -trans 5,5,5 -quat 0.5,0,0,1 s3.pcd s3_tr2.pcd

다음과 같이 두 데이터를 정합한다. 정합 시간은 1분 정도 소요되었다. 
../pcl_icp -d 10 s1.pcd s3_tr1.pcd

제대로 정합된 결과를 확인할 수 있다.

좀 더 자세히 설명하면, 대학교 건물을 각각 다른 장면에서 스캔한 두개의 데이터셋이 있다. 그 중 하나를 x, y, z각각 5미터만큼 이동하고, 쿼터니언 각도로 0.5 회전시켰다. 
스캔 데이터 1(273,694 개)
스캔 데이터 2(223,243개)
정합 전
정합 후

PCL에 구현된 ICP 주요 단계는 다음과 같다.

icp->setMaximumIterations (iter);
icp->setMaxCorrespondenceDistance (dist);
icp->setRANSACOutlierRejectionThreshold (rans);
iicp.setRegistration(icp);

pcd = LoadPCDFile();
iicp.registerCloud(pcd);


전통적인 ICP 알고리즘 한계
ICP 모든 점군에 대해 이를 계산하므로 계산속도 문제는 여전히 존재한다. 실시간 처리가 불가능하다. 만약, 무인자율로봇이 주변을 탐색해 경계나 장애물을 제외하고 특정 경로로 움직이고자 할 때는 ICP방식으로는 실시간 동작을 지원할 수가 없다(예. 주변공간의 특정한 모양을 가진 지점을 방문하거나, 공간 전체를 고르게 탐색하거나, 공간을 사람이 지시한 방향의 경계까지 최단경로로 목적지까지 가도록 하거나 등.. 사람이라면 자연스럽게 하는 공간탐색 후 행동전략은 모두 실시간임). 그러므로, 다음과 같은 솔류션으로 문제를 개선한다. 
  1. 정합 대상이 되는 점군에서 특징점만 얻어 계산하면 속도와 정확성이 높아진다. 
  2. 변환행렬 계산 속도를 개선한다. 
1은 공간인덱싱 기술인 공간분할 a)을 적용하고, 특징점 b)과 관련없는 점군은 필터링 c)한다. 
2는 1을 적용하고, 각 격자별로 통계적 특징 d)을 얻어, 정합 변환행렬 해 e) 계산량을 줄일 수 있다. 예를 들어, NDT(Normal Distribution Transform)을 사용해 계량산을 줄일 수 있다.  

각 단계별 사용되는 알고리즘 예시는 다음과 같다.
c) RANSAC, PCA(Principal Component Analysis), Region growing
d) NDT

Octree 기반 공간분할 예시

SLAM 알고리즘 구현 예시
주어진 3D 포인트 클라우드 계산량을 줄이기 위해, 보통, 공간인덱싱 구조를 사용한다. 예를 들어, 옥트리(Octree) 기반 데이터 구조를 적용한다. 이를 통해, 점군 검색 등의 속도를 획기적으로 개선할 수 있다. 이제, 점군 간 매칭될 특징점 대상수를 줄여야 실시간 스캔 데이터 정합이 가능하다. 예를 들어, 이미지 기반 그라운드 포인트 제거 방법을 적용한다. 이후, 표준적인 점 대 점 ICP 알고리즘이 적용되어, 연속된 스캔 점군 간의 6자유도 변환을 계산한다. 만약, 스캔 환경에서 폐쇄 루프가 감지되면 전역 이완을 위한 6D 그래프 최적화 알고리즘이 사용된다. 
ICP 기반 실시간 맵 생성(Xuyou Li, 2020)

LiDAR의 고해상도는 스캔할 때 대규모 데이터를 수집한다. 예를 들어, Velodyne HDL-64E는 초당 180만 점군을 생성할 수 있다. 방대한 양의 3D 데이터 포인트를 효율적으로 처리하기 위해서는 포인트 클라우드 저장 및 축소가 중요한 단계이다. Octree는 3차원 포인트 클라우드의 효율적인 저장, 압축 및 검색을 가능하게 하는 3차원 공간 인덱싱 기술이다. 

그라운드 점 제거 및 분할 알고리즘은 2D 이미지를 기반으로 처리한다. 투영된 각 3D 좌표점은 고유한 픽셀로 표시된다. 그라운드 점군은 다른 점군보다 밀도, 법선각도 등의 차이가 있다. 이를 이용해 세그먼테이션 후 제거를 한다. 이후, 처리된 점군에 대한 일부 노이즈 및 이상치 포인트도 필터링된다. 

필터링된 점군에서 표준적인 점대점 ICP 알고리즘을 적용하여, 연속 스캔 간의 6자유도 변환을 계산한다. 

ICP는 인접한 두 스캔 사이의 포즈를 계산한 다음, 지속적으로 업데이트하여, 궤적을 얻는다. 그러나 포즈 추정은 장기간 또는 대규모 스캔 장면에서 오차가 누적되는 문제가 있다. 이 문제를 해결하기 위해 폐쇄 루프가 감지되면, ICP의 포즈 추정 결과가 6D SLAM에 전역적으로 조정되도록 한다. 포즈 그래프 최적화 방법은 마할라노비스 거리(Mahalanobis distance)를 사용하여 모든 포즈의 전역 오류를 최소화한다. 마할라노비스 거리는 포즈 데이터의 평균과의 거리가 표준편차의 몇 배인지를 계산한다. 구체적인 공식은 다음과 같다.


이 거리가 최소가 되도록 ICP의 포즈 추정 데이터(위치, 방향)를 수정한다. 

마무리
이 글을 통해, ICP, SLAM 알고리즘 동작 방식을 알아보았다. ICP와 SLAM코드의 동작 방식을 이해하면, 왜 스캔 장면이 급격하게 변하거나 변화가 없는 장면 데이터를 정합할 때는 에러가 많아지는 지 이해할 수 있을 것이다. 그럼에도, 스캔 장비 성능이 좋아지고, 관련 데이터도 점차 많아질 것이므로, 이런 기술은 앞으로도 크게 중요해지리라 생각한다.

참고: ICP